
02-MySQL 事务、锁与索引:ACID、隔离级别与索引失效
📝 笔记摘要:MySQL 的事务、锁与索引,配可复现的实验脚本
事务、锁、索引这三件事在 InnoDB 里其实是同一件事的三个侧面:事务定边界,锁管并发,索引决定锁能落到多细。这篇按事务 → 锁 → 索引的顺序讲,每一块都给出能在本地直接跑的两会话实验脚本和对应的观察命令——事务提交的那一刻数据到底写到了哪、MVCC 怎么判断一个版本可不可见、一条 UPDATE 锁住了哪一段、死锁环是怎么形成的、二级索引为什么要回表,都在图和代码里摊开。
MySQL 系列 共 5 篇,这是第 2 篇
01 MySQL 基础 类型、建表与查询
02-MySQL 事务、锁与索引 ACID、隔离级别、锁层级与索引失效 ← 本篇
03 MySQL 函数专题 CONCAT、CONCAT_WS 与 GROUP_CONCAT
04 MySQL 报表实战 同环比、日期序列与多表连接
05 MySQL 优化与版本细节 优化清单、版本行为差异与转义
这篇的结构
1. 事务是什么:四种开启写法
2. ACID 四个特性各对应哪个机制
3. 一次 UPDATE 到底改了什么
4. 提交、回滚与隐式提交
5. 四个隔离级别
6. MVCC:可重复读是怎么做到的
7. 四个隔离级别实测一遍
8. 锁的四个层级
9. next-key lock 锁住哪一段
10. 死锁:环形等待与检测
11. 索引是什么
12. B+ 树与最左前缀
13. 回表:一次查询翻两棵树
14. 索引的创建、删除与查看
15. 索引失效的七种场景
16. EXPLAIN 怎么看
17. 索引类型
表结构和查询写法在 MySQL 基础 那篇,这篇接着往下走。版本和优化相关的清单在 MySQL 优化与版本细节。文章里的实验脚本可以直接复制到两个终端里跑,会话 A 和会话 B 是两条独立连接。
1. 事务是什么:四种开启写法
事务就是一组要么全成功、要么全失败的操作。经典的例子是转账:扣钱和加钱必须同时生效,中间任何一步崩了都不行。
先把这张实验表建好,后面的脚本全在它上面跑:
CREATE TABLE `account` (
  `id`      INT UNSIGNED NOT NULL AUTO_INCREMENT,
  `name`    VARCHAR(32)  NOT NULL,
  `balance` DECIMAL(12,2) NOT NULL DEFAULT 0.00,
  PRIMARY KEY (`id`),
  KEY `idx_name` (`name`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;

INSERT INTO `account` (`name`,`balance`) VALUES
  ('张三', 1000.00),
  ('李四', 2000.00),
  ('王五', 3000.00);
开启事务有四种写法,效果不同:
-- 写法 1:autocommit=1(默认),每条语句自己是一个事务
UPDATE account SET balance = balance - 100 WHERE id = 1;
UPDATE account SET balance = balance + 100 WHERE id = 2;

-- 写法 2:显式事务(最常用)
START TRANSACTION;
UPDATE account SET balance = balance - 100 WHERE id = 1;
UPDATE account SET balance = balance + 100 WHERE id = 2;
COMMIT;

-- 写法 3:关掉 autocommit,手动控制
SET autocommit = 0;
UPDATE account SET balance = balance - 100 WHERE id = 1;
UPDATE account SET balance = balance + 100 WHERE id = 2;
COMMIT;

-- 写法 4:把一段操作包在一个事务里
START TRANSACTION;
  UPDATE account SET balance = balance - 100 WHERE id = 1;
  UPDATE account SET balance = balance + 100 WHERE id = 2;
  INSERT INTO account (name, balance) VALUES ('审计', 0.00);
COMMIT;
MySQL 没有
BEGIN ... END事务块 存储过程那种写法在 MySQL 里没有,事务边界只能靠START TRANSACTION和COMMIT两行
事务是连接级的 状态挂在会话上。命令行里开两个终端就是两个会话,能复现并发
只有 DML 和 DDL 有事务SELECT查询本身不在「写事务」里
MySQL 不支持 SAVEPOINT 想部分回滚只能靠条件判断手动补偿,Oracle / PostgreSQL 才有SAVEPOINT
随时可以查当前会话的事务状态:
SELECT @@transaction_isolation;          -- 当前会话的隔离级别
SELECT @@global.transaction_isolation;     -- 全局默认值
SHOW VARIABLES LIKE 'transaction_isolation';
SELECT @@autocommit;                      -- 1 或 0
2. ACID 四个特性各对应哪个机制
原子性 Atomicity 事务里的操作要么全做完,要么全不做。执行到一半出错,数据库回到事务开始前的状态
一致性 Consistency 事务前后数据都满足完整性约束(主外键、唯一索引、CHECK 约束)
隔离性 Isolation 多个事务并发跑时互相看不见对方的中间状态,隔离到什么程度由隔离级别决定
持久性 Durability 事务提交之后数据就落定了,宕机也不丢
一致性是结果而不是独立机制,把四个词对应到具体实现上就清楚了:
原子性 → undo log 记的是「这一行原来长什么样」,回滚时按它改回去
持久性 → redo log 记的是「某个数据页改成了什么样」,宕机后按它重做
隔离性 → 锁 + MVCC 写写冲突靠锁串行化,读写隔离靠版本链
一致性 → 前三条的结果 原子性保证不会停在中间,隔离性保证别人看不到中间,持久性保证改完的还在。三者成立,一致性自然成立
3. 一次 UPDATE 到底改了什么
老资料里说「InnoDB 提供了一组用来记录事务性活动的日志文件」,方向对但太粗。实际是两份日志,各管一头:
redo log(重做日志) 物理层面的记录,记的是「某个数据页改成了什么样」。负责持久性
undo log(回滚日志) 逻辑层面的记录,记的是「这个行原来长什么样」。负责原子性
两者都在磁盘上 现代 InnoDB 是循环写入的固定大小文件(innodb_redo_log_capacity控制,8.0.30 起取代了老的innodb_log_file_size),写满就覆盖旧的
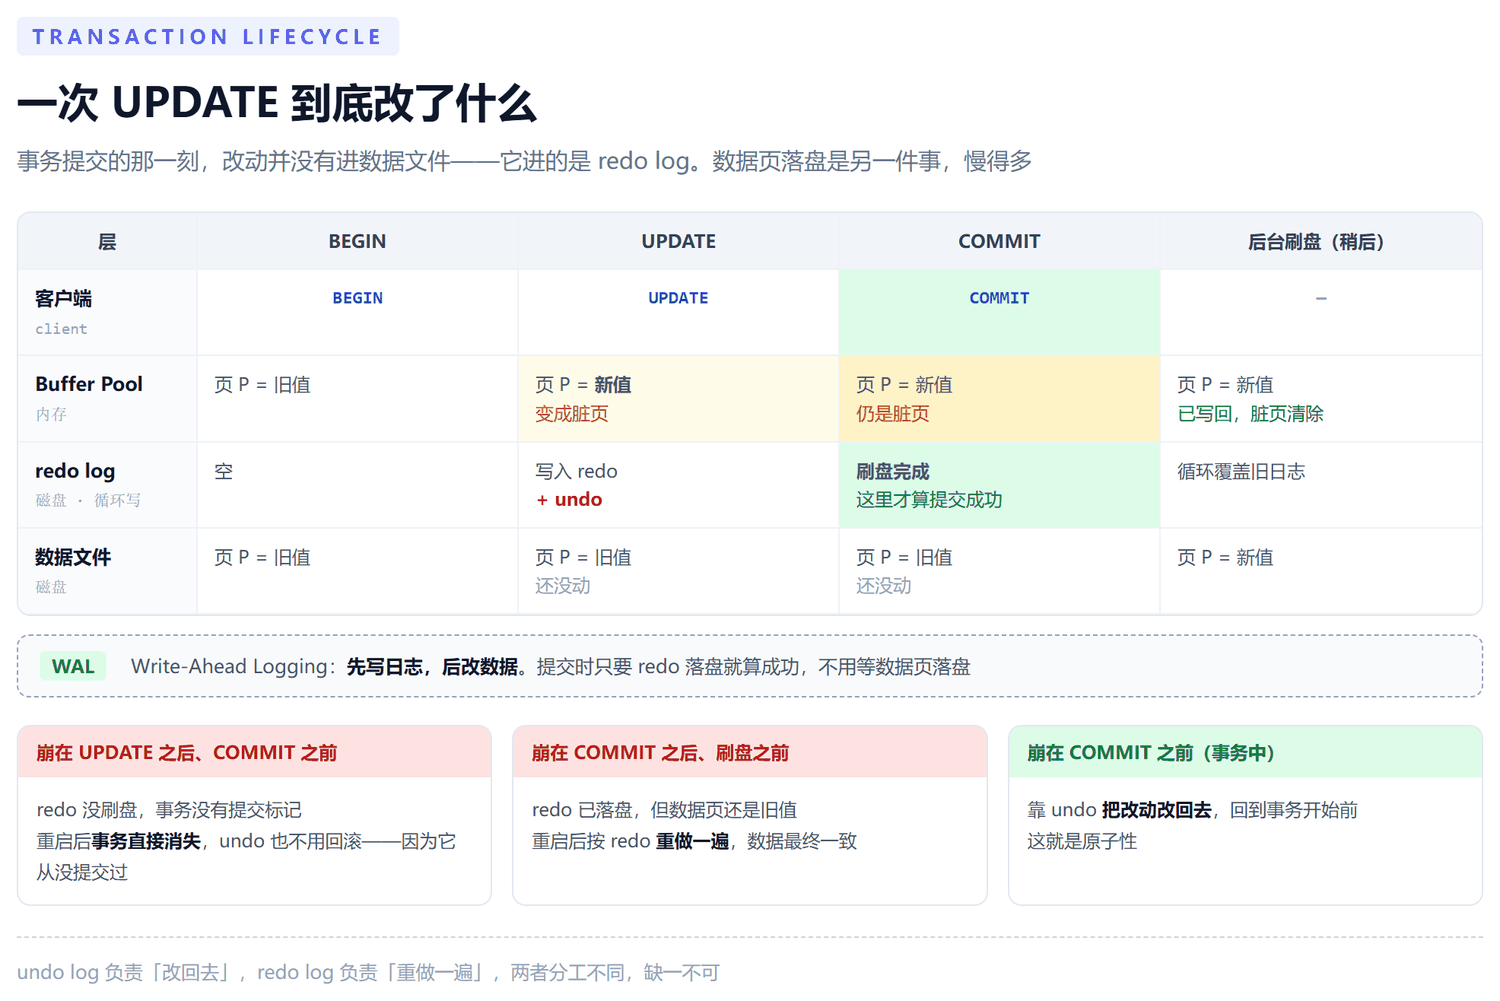
这张图最关键的一行是 COMMIT 那一列:提交的时候改的是内存页和 redo log,数据文件还没动。数据页落盘是后台线程慢慢做的,慢得多。这就是 WAL(Write-Ahead Logging):先写日志,后改数据,提交只要 redo 落盘就算成功。
-- redo / undo 的容量配置
SHOW VARIABLES LIKE 'innodb_redo_log_capacity';   -- 8.0.30+
SHOW VARIABLES LIKE 'innodb_log_file_size';         -- 8.0.30 之前

-- 看当前 InnoDB 状态:事务、锁、最近一次死锁都在这
SHOW ENGINE INNODB STATUS\G

-- 8.0 起:结构化的性能视图,比翻 STATUS 好读
SELECT * FROM performance_schema.log_status\G还有一个常见误解要澄清:提交事务不会「清空日志文件」。老资料描述的那种「提交时清空日志」是 MySQL 早期的行为,现代 InnoDB 始终循环写,靠 checkpoint 推进来回收空间。
4. 提交、回滚与隐式提交
START TRANSACTION;
INSERT INTO account (name, balance) VALUES ('temp', 1.00);
UPDATE account SET balance = balance - 100 WHERE id = 1;
SELECT * FROM account;          -- 事务内能看到自己的改动
ROLLBACK;                       -- 全部撤销
-- 或者 COMMIT;                 -- 全部生效
事务边界的坑比语法多得多,下面这段脚本能亲手验证「隐式提交」:
START TRANSACTION;
INSERT INTO account (name, balance) VALUES ('temp', 1.00);

CREATE TABLE t_demo (id INT);   -- DDL 触发隐式提交

ROLLBACK;                        -- 想撤销?晚了
SELECT * FROM account WHERE name = 'temp';   -- 还在,INSERT 已经被提交了
DDL 一律隐式提交
CREATE TABLE、ALTER TABLE、TRUNCATE、DROP都会先把当前事务提交掉。所以「事务里建表然后回滚」是回滚不掉的
START TRANSACTION会隐式提交前一个事务 别在事务中间随手开新事务
autocommit=0 时要记得手动 COMMIT 忘了提交,连接一断数据全丢
锁表语句也会提交LOCK TABLES、FLUSH TABLES、CREATE INDEX同样带隐式提交
想看有哪些语句偷偷提交了,可以开 general log:
SET GLOBAL general_log = ON;
SET GLOBAL general_log_file = '/var/log/mysql/general.log';
5. 四个隔离级别
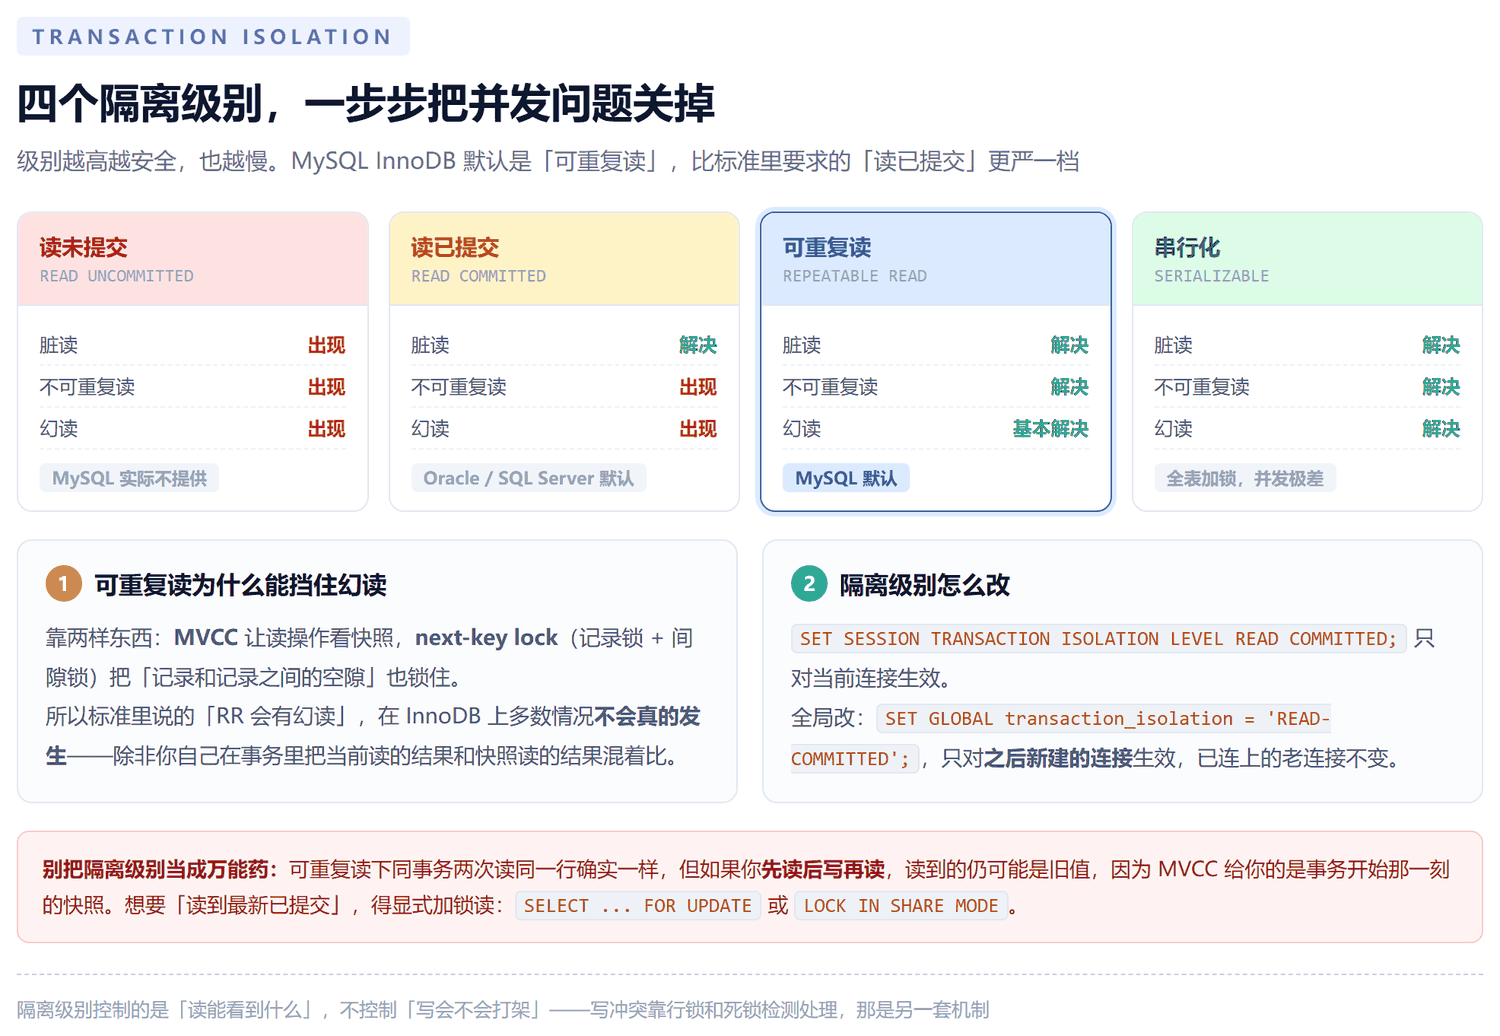
隔离级别决定「一个事务能看见另一个事务的什么状态」,代价是并发度。四级从低到高:
READ UNCOMMITTED 能读到别人没提交的数据,脏读。MySQL 支持这个级别,但 InnoDB 里它实际等价于 READ COMMITTED(不加间隙锁),所以脏读并不会真的发生
READ COMMITTED 只读得到别人已提交的数据,解决脏读。但同一事务里两次读同一行可能不一样——不可重复读
REPEATABLE READ 同一事务里反复读同一行,结果都一样。MySQL InnoDB 的默认级别,比标准要求的 RC 更严一档
SERIALIZABLE 所有读都加锁,等于串行执行,安全但并发度最差
-- 三个作用域:全局、当前会话、下一个事务
SET GLOBAL transaction_isolation = 'READ-COMMITTED';
SET SESSION transaction_isolation = 'REPEATABLE-READ';
SET TRANSACTION transaction_isolation = 'SERIALIZABLE';

-- 在事务内部临时改(只影响下一个事务)
START TRANSACTION;
SET TRANSACTION transaction_isolation = 'READ-COMMITTED';
SELECT * FROM account WHERE id = 1;
COMMIT;
改全局不生效的坑
SET GLOBAL transaction_isolation只对之后新建的连接生效,已经连着的连接还是老级别。应用连接池里这条尤其坑
应用层的选择 互联网业务常用 RC(减少间隙锁、并发更高),但要接受「同事务内读到不同值」
想读到最新已提交的值 别指望调隔离级别,用加锁读:SELECT ... FOR UPDATE或LOCK IN SHARE MODE
6. MVCC:可重复读是怎么做到的
「可重复读」和「快照读」这两个词总是混着讲,其实是一件事的两面。InnoDB 的做法是多版本:每次修改不覆盖旧值,而是在 undo log 里留一版,形成一条版本链。
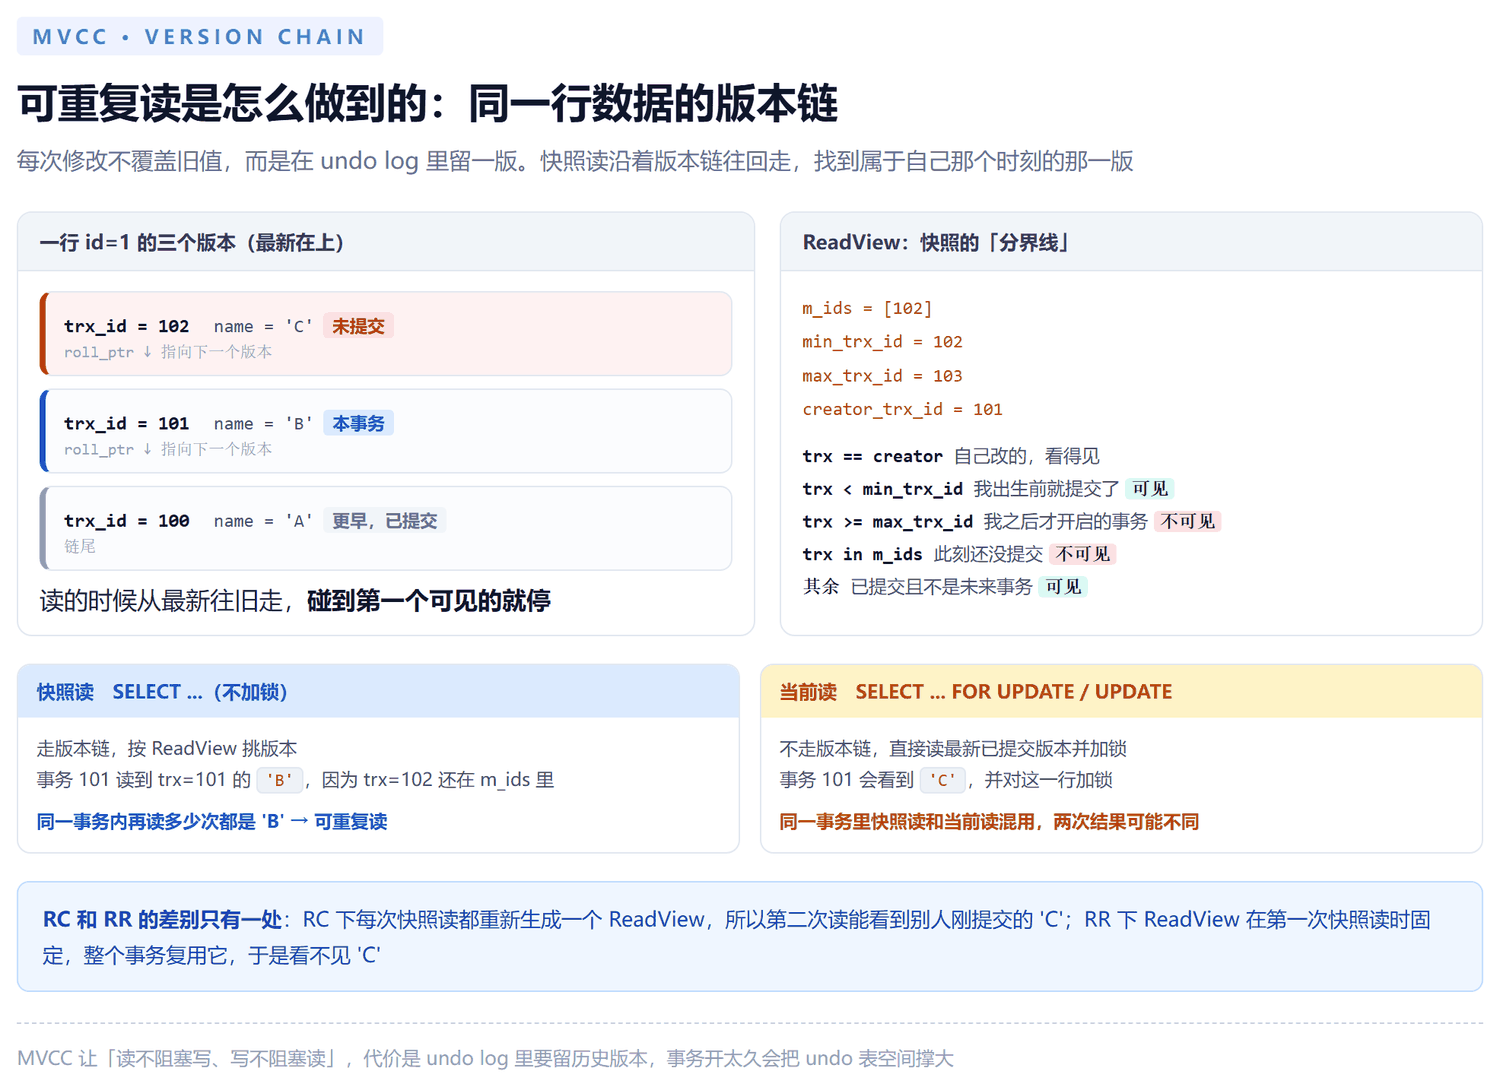
判断规则拆开看就五条:
trx_id == creator_trx_id 自己事务改的,看得见
trx_id < min_trx_id 我出生之前就提交了,可见
trx_id >= max_trx_id 我之后才开启的事务,不可见
trx_id 在 m_ids 里 此刻还没提交,不可见
其余 已提交且不是未来事务,可见
读的时候从最新的版本往旧走,碰到第一个可见的就停下。这个「往回走」的动作由 ReadView 决定停在哪,ReadView 里有当前活跃事务列表 m_ids 和两个事务号边界。
快照读和当前读的区别,是这一节最该记住的一句:
快照读 普通
SELECT。走版本链,按 ReadView 挑版本,不加锁,读到的是「事务视角」的值
当前读SELECT ... FOR UPDATE、UPDATE、DELETE。不走版本链,直接读最新已提交版本并加锁,读到的是「物理视角」的值
两者混用就会对不上:
START TRANSACTION;

SELECT balance FROM account WHERE id = 1;             -- 快照读:1000.00
UPDATE account SET balance = 2000.00 WHERE id = 1;     -- 当前读 + 加锁
SELECT balance FROM account WHERE id = 1;             -- 快照读:还是 1000.00
SELECT balance FROM account WHERE id = 1 FOR UPDATE;  -- 当前读:2000.00

COMMIT;
RC 和 RR 的差别只有一处:RC 下每次快照读都重新生成一个 ReadView,RR 下 ReadView 在第一次快照读时固定、整个事务复用。所以 RC 能读到别人刚提交的数据,RR 读不到。
MVCC 的代价是 undo log 里要留历史版本。事务开太久会把 undo 表空间撑大,长事务是线上的一类隐患:
-- 找出开了超过 60 秒的事务
SELECT trx_id,
       trx_started,
       TIMESTAMPDIFF(SECOND, trx_started, NOW()) AS running_sec,
       trx_state,
       trx_rows_modified,
       trx_query
FROM information_schema.INNODB_TRX
WHERE trx_started < NOW() - INTERVAL 60 SECOND
ORDER BY trx_started;
7. 四个隔离级别实测一遍
两个会话同时跑,会话 A 和 会话 B 是两条独立连接。
读已提交(READ COMMITTED):
-- 会话 A
SET SESSION transaction_isolation = 'READ-COMMITTED';
START TRANSACTION;
SELECT * FROM account WHERE id = 1;   -- 1000.00

-- 会话 B(此时执行)
START TRANSACTION;
UPDATE account SET balance = 8888.00 WHERE id = 1;
COMMIT;

-- 会话 A(此时执行)
SELECT * FROM account WHERE id = 1;   -- 8888.00  ← RC 下第二次读能看到新值
COMMIT;
可重复读(REPEATABLE READ),同样的操作:
-- 会话 A
SET SESSION transaction_isolation = 'REPEATABLE-READ';
START TRANSACTION;
SELECT * FROM account WHERE id = 1;   -- 1000.00  ← 这一次快照读固定了 ReadView

-- 会话 B(此时执行)
START TRANSACTION;
UPDATE account SET balance = 8888.00 WHERE id = 1;
COMMIT;

-- 会话 A(此时执行)
SELECT * FROM account WHERE id = 1;   -- 还是 1000.00  ← 快照没变
COMMIT;

-- 会话 A 再开一个新事务
START TRANSACTION;
SELECT * FROM account WHERE id = 1;   -- 8888.00  ← 新事务才有新 ReadView
COMMIT;串行化(SERIALIZABLE),会话 A 不加锁读,会话 B 会被挡住:
-- 会话 A
SET SESSION transaction_isolation = 'SERIALIZABLE';
START TRANSACTION;
SELECT * FROM account WHERE id = 1;   -- 持有共享锁,不放

-- 会话 B(此时执行,会一直等到 A 提交)
UPDATE account SET balance = 7777.00 WHERE id = 1;   -- 卡住

-- 会话 A 提交后,会话 B 才继续
老资料里「RR 有幻读」的说法要补一句 标准定义上 RR 确实可能幻读,但 InnoDB 用 next-key lock(记录锁 + 间隙锁)把范围查询的空隙也锁住了,绝大多数场景下幻读不会发生
真正会踩到的是「快照读和当前读混用」 上一节那段脚本就是:先普通 select 再 update 再 select,第二次读到的是最新值,和第一次对不上
8.锁的四个层级
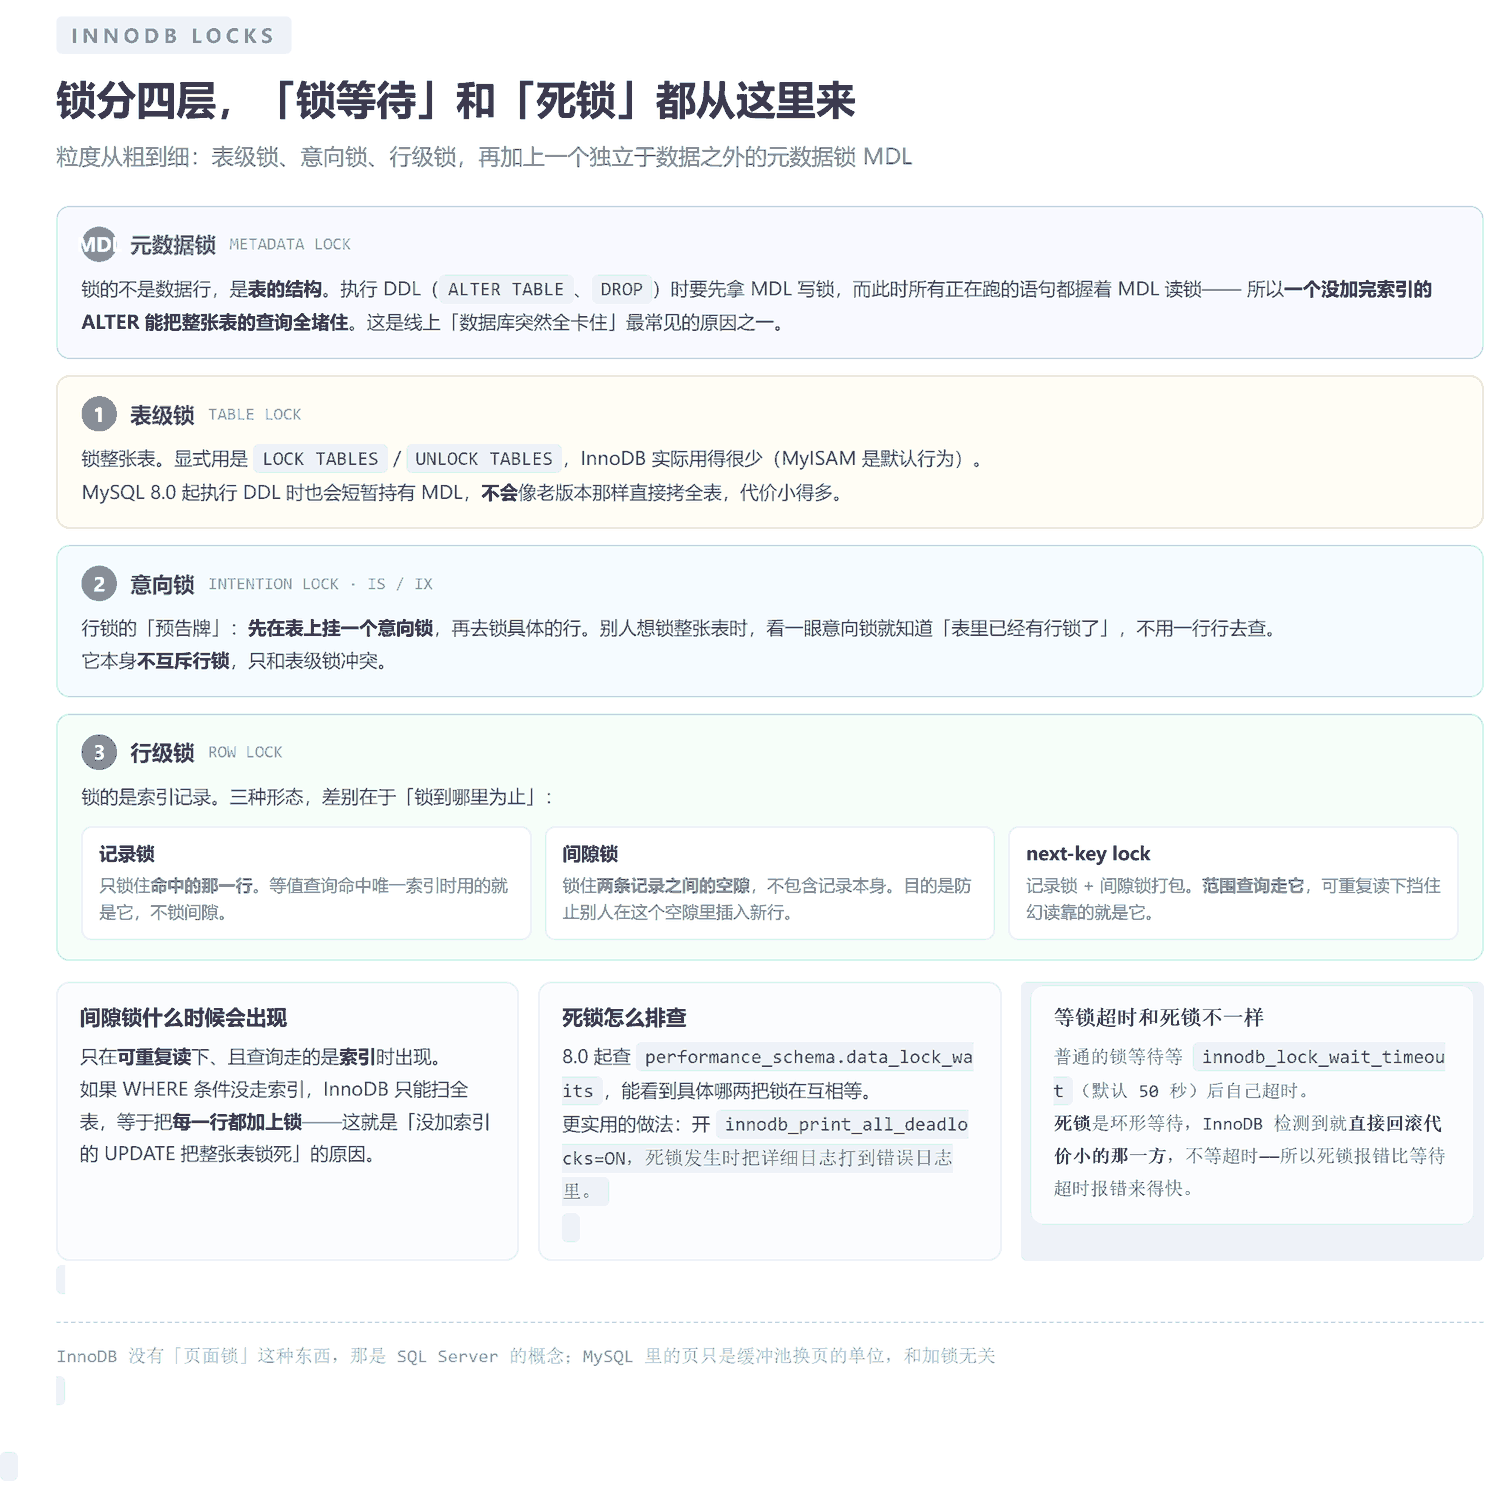
元数据锁 MDL 锁的不是数据行,是表的结构。执行 DDL 要先拿 MDL 写锁,而此时所有正在跑的语句都握着 MDL 读锁——一个没加完索引的 ALTER 能把整张表的查询全堵住,这是线上「数据库突然全卡住」最常见的原因
表级锁 锁整张表。显式用是LOCK TABLES/UNLOCK TABLES,InnoDB 实际很少用(MyISAM 是默认行为)
意向锁 IS / IX 行锁的「预告牌」:先在表上挂一个意向锁再去锁具体的行。别人想锁整张表时看一眼意向锁就知道表里已经有行锁了,不用逐行去查。它本身不互斥行锁,只和表级锁冲突
行级锁 锁的是索引记录,三种形态见下
行级锁的三种形态
记录锁 Record Lock 只锁住命中的那一行。等值查询命中唯一索引时用的就是它,不锁间隙
间隙锁 Gap Lock 锁住两条记录之间的空隙,不包含记录本身。目的是防止别人在这个空隙里插入新行
next-key lock 记录锁 + 间隙锁打包,范围查询走的就是它。可重复读下挡住幻读靠的就是它
8.0 起可以直接看当前有哪些锁被持有、谁在等谁:
-- 8.0 的真实锁视图
SELECT ENGINE_TRANSACTION_ID, OBJECT_NAME, INDEX_NAME,
       LOCK_TYPE, LOCK_MODE, LOCK_STATUS, LOCK_DATA
FROM performance_schema.data_locks;

-- 谁在等谁
SELECT * FROM performance_schema.data_lock_waits;

-- sys 库封装好的视图,输出更友好
SELECT * FROM sys.innodb_lock_waits;
SELECT * FROM sys.schema_table_lock_waits;   -- MDL 等待看这个
8.0 换了地方
information_schema.innodb_locks和innodb_lock_waits在 8.0 里已被移除,换成了performance_schema.data_locks和data_lock_waits
排障顺序 先分清是 MDL 等还是行锁等:DDL 卡住看sys.schema_table_lock_waits,DML 卡住看sys.innodb_lock_waits
9. next-key lock 锁住哪一段
间隙锁只在两个条件下出现:可重复读(RC 下不加间隙锁)+ 查询走了索引。
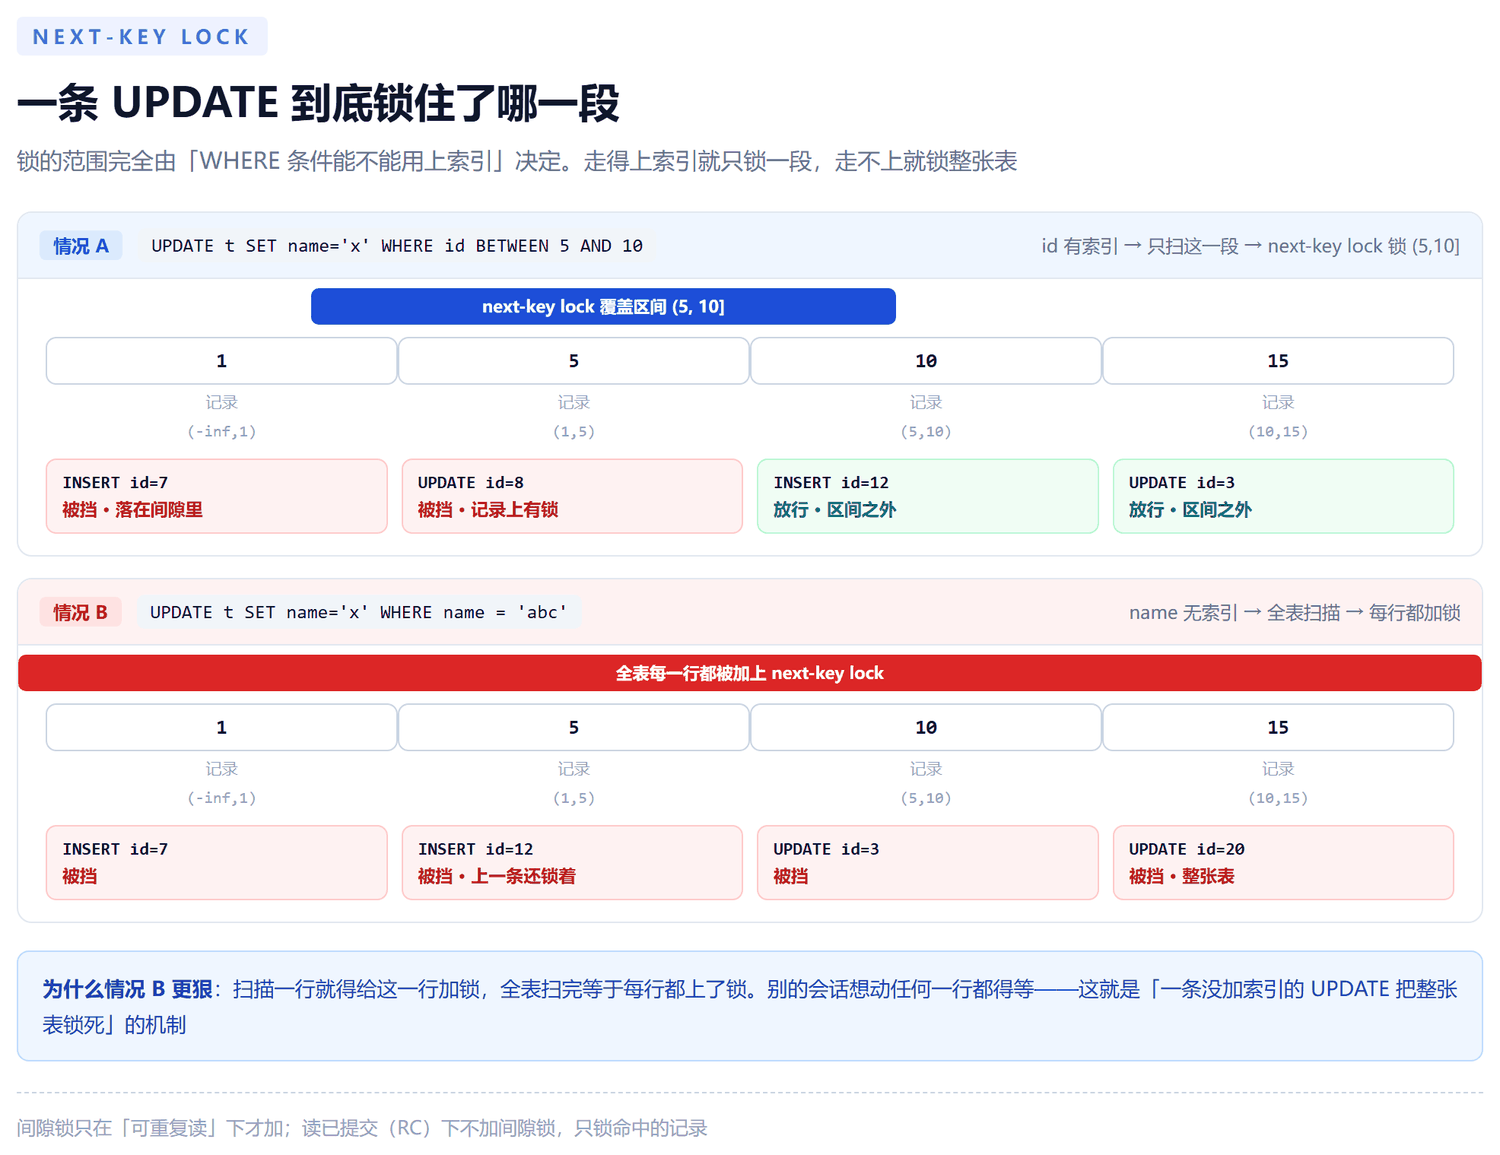
图里两种情况都能亲手复现。先造数据:
CREATE TABLE `t_gap` (
  `id`   INT NOT NULL,
  `name` VARCHAR(32) NOT NULL,
  PRIMARY KEY (`id`)
) ENGINE=InnoDB;

INSERT INTO t_gap (id, name) VALUES (1,'a'), (5,'b'), (10,'c'), (15,'d');
走索引:只锁住一段
-- 会话 A
START TRANSACTION;
SELECT * FROM t_gap WHERE id BETWEEN 5 AND 10 FOR UPDATE;

-- 会话 B(此时执行)
INSERT INTO t_gap (id, name) VALUES (7, 'x');    -- 被挡,卡在间隙锁上
INSERT INTO t_gap (id, name) VALUES (12, 'x');   -- 放行,在锁区间之外
UPDATE t_gap SET name = 'y' WHERE id = 3;        -- 放行

-- 会话 A 提交后,会话 B 的 INSERT 才继续
没走索引:整张表都锁
-- 会话 A
START TRANSACTION;
UPDATE t_gap SET name = 'z' WHERE name = 'b';    -- name 没有索引 → 全表扫描加锁

-- 会话 B(此时执行,全部被挡)
UPDATE t_gap SET name = 'q' WHERE id = 15;
INSERT INTO t_gap (id, name) VALUES (20, 'w');
所以「一条没加索引的 UPDATE 把整张表锁死」不是玄学,机制就在这张图里:扫描一行就得给这一行加锁,全表扫完等于每行都上了锁。
官方文档给的间隙锁例子
SELECT c1 FROM t WHERE c1 BETWEEN 10 AND 20 FOR UPDATE;会给 10 到 20 之间的间隙上间隙锁,别的会话往这个范围里插 15 就会被挡住
排障顺序 出现「UPDATE 卡住整表」,先看这条 SQL 的 WHERE 条件有没有索引,再看是不是 RC 下的锁等待
元数据锁是另一类卡顿 如果卡的是 DDL 而不是 DML,去看 MDL——那是结构锁,不是数据锁
10. 死锁:环形等待与检测
死锁是环形等待:A 等 B 的锁,B 等 A 的锁。InnoDB 有死锁检测,发现就直接回滚代价小的那一方,不等超时。
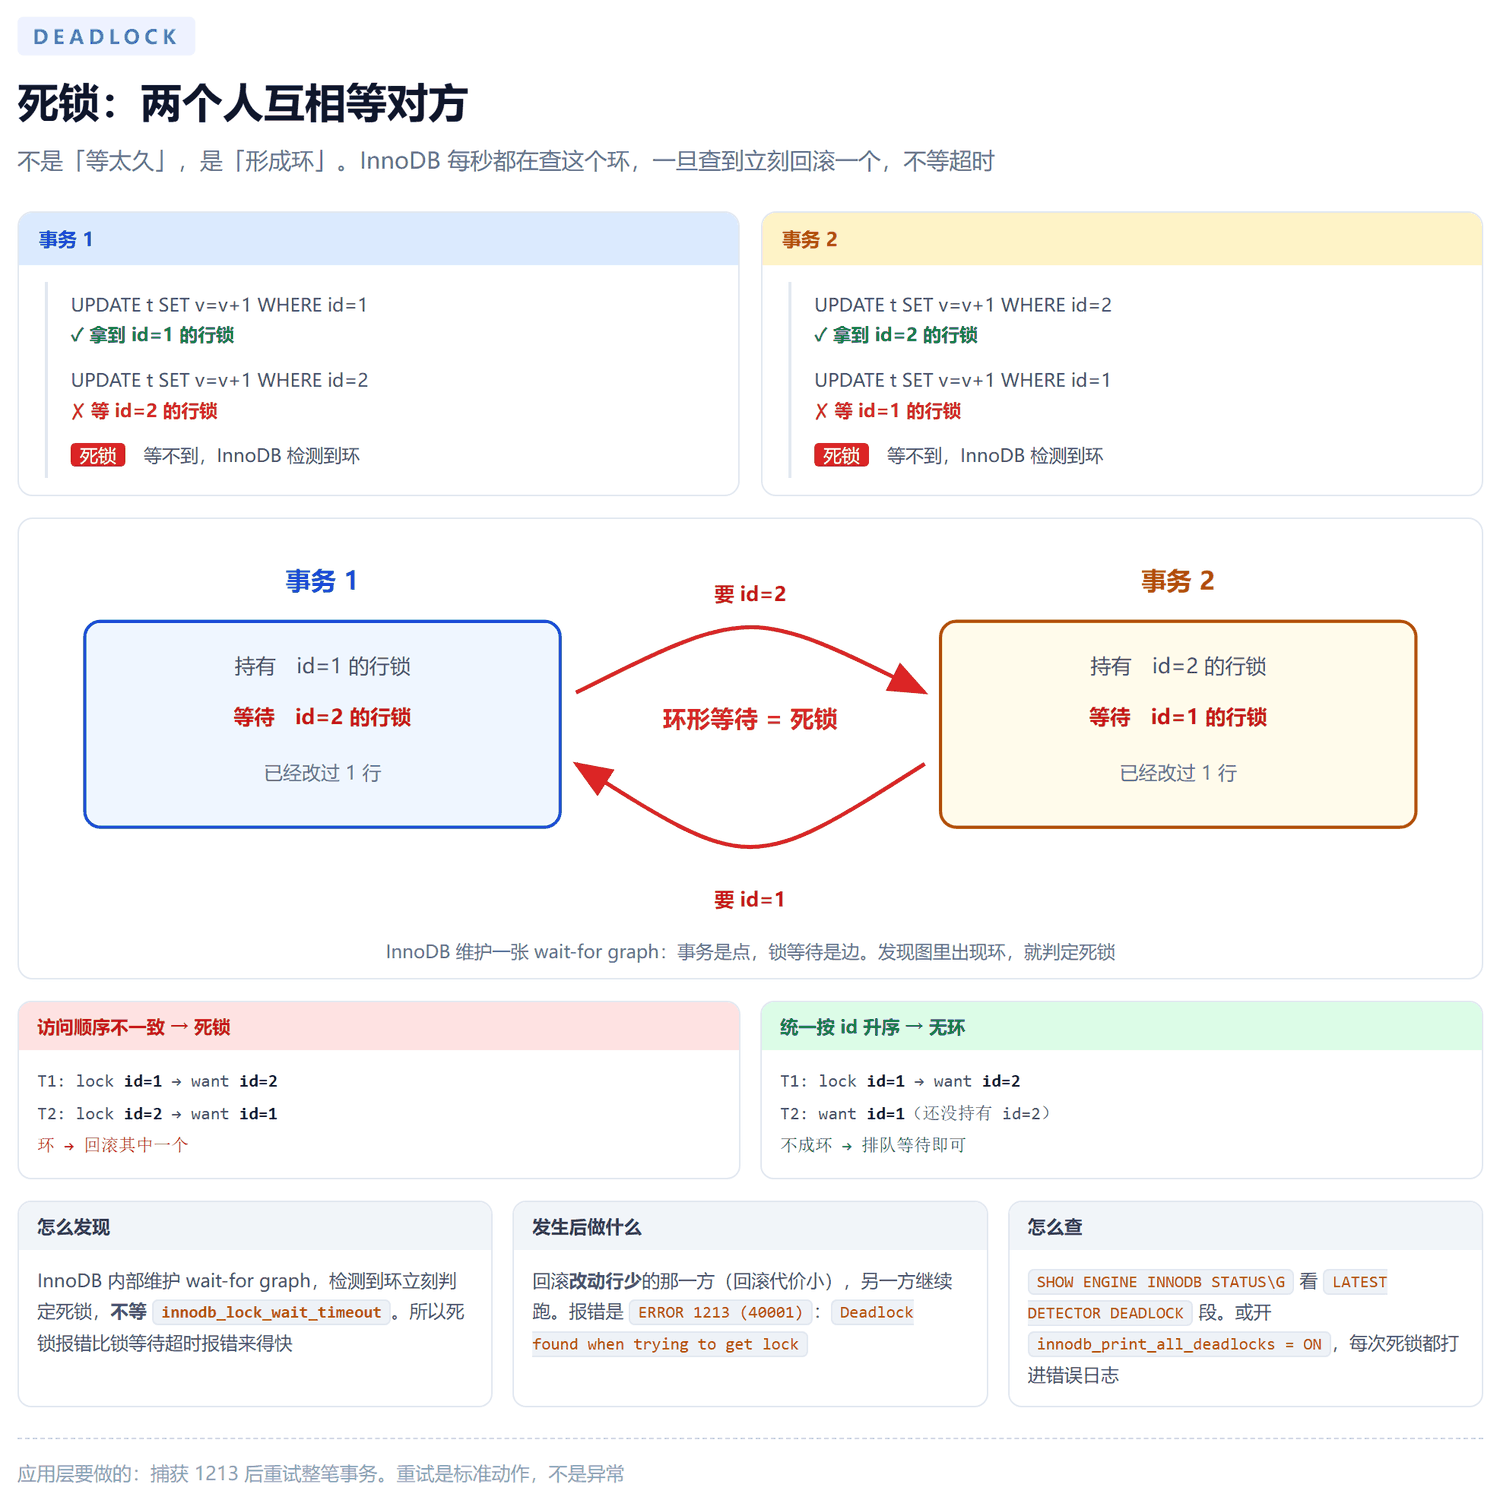
死锁可以稳定复现,两边都反着来:
-- 会话 A                          -- 会话 B
START TRANSACTION;                 START TRANSACTION;
UPDATE account SET balance =        UPDATE account SET balance =
  balance - 100 WHERE id = 1;         balance - 100 WHERE id = 2;
-- 拿到 id=1 的锁                   -- 拿到 id=2 的锁

-- 让 B 先跑第二句(会话 A 可以先 sleep 一下)
                                  UPDATE account SET balance =
                                    balance + 100 WHERE id = 1;
                                  -- 等 id=1 → 死锁

UPDATE account SET balance =
  balance + 100 WHERE id = 2;
-- 等 id=2 → 死锁
其中一边会立刻收到报错:
ERROR 1213 (40001): Deadlock found when trying to get lock;
try restarting transaction
查死锁细节:
-- 最近一次死锁的完整现场(找 LATEST DETECTOR DEADLOCK 段)
SHOW ENGINE INNODB STATUS\G

-- 让所有死锁都写进错误日志,事后能翻
SET GLOBAL innodb_print_all_deadlocks = ON;
死锁和锁等待不是一回事 普通锁等待等
innodb_lock_wait_timeout(默认 50 秒)后自己超时;死锁是环形等待,会被立刻检测出来并回滚,所以死锁报错比等待超时报错来得快得多
回滚的是改动行少的那一方 回滚代价小,另一方继续跑完
怎么改 所有事务按同一顺序访问资源。最省事的做法是把要改的行 ID 排好序再批量更新:WHERE id IN (3, 8, 15) ORDER BY id(严格说批量 UPDATE 内部仍按索引顺序加锁,但显式排序能消除歧义)
索引顺序不一致也会造成死锁 两张表按不同索引顺序扫描同一个业务对象时,加锁顺序会不一致
两个超时别搞混:innodb_lock_wait_timeout 管 InnoDB 的行锁等待(默认 50 秒),lock_wait_timeout 管元数据锁等待(默认 31536000 秒,也就是一年——因为 DDL 宁可等,也不该被一条慢查询无限期挡住)。
8.0 起还支持两个跳过等待的选项,做任务队列的「抢单」逻辑时非常好用:
-- 拿不到锁立刻报错,不等
SELECT * FROM account WHERE id = 1 FOR UPDATE NOWAIT;

-- 直接跳过被锁住的行
SELECT * FROM account WHERE balance > 0 FOR UPDATE SKIP LOCKED;应用层对死锁的标准动作是重试整笔事务,这不是异常处理,是日常:
for attempt in range(3):
    try:
        with conn.begin():          # 开启事务
            cur.execute("UPDATE account SET balance = balance - %s WHERE id = %s", (100, 1))
            cur.execute("UPDATE account SET balance = balance + %s WHERE id = %s", (100, 2))
        break                        # 提交成功
    except OperationalError as e:
        if e.args[0] != 1213:        # 只有死锁才重试
            raise
        time.sleep(0.1 * (attempt + 1))
11. 索引是什么
索引是在字段上建的排好序的目录,目的是缩小扫描范围。字段是字典,索引是目录,查询时先翻目录再翻正文。
什么时候值得建 数据量大、字段经常出现在 WHERE 后面、字段很少被 DML(索引要跟着 DML 一起维护)
不要乱建 索引本身要占空间、写操作要维护。优先用主键或唯一索引覆盖的字段查询
主键和唯一索引是特例 它们由业务规则驱动,建了不亏
12. B+ 树与最左前缀
老资料把索引的底层结构说成「类似 TreeSet 的自平衡二叉树」,这是不准的。InnoDB 用的是 B+ 树:
非叶子节点只存索引键 不存数据,所以一层能塞进很多键,树就矮
数据全在叶子节点 而且叶子之间用链表串起来,范围查询顺着链表走就行
三到四层就够用 几千万行数据的表,三层 B+ 树就能覆盖,磁盘 IO 次数非常少
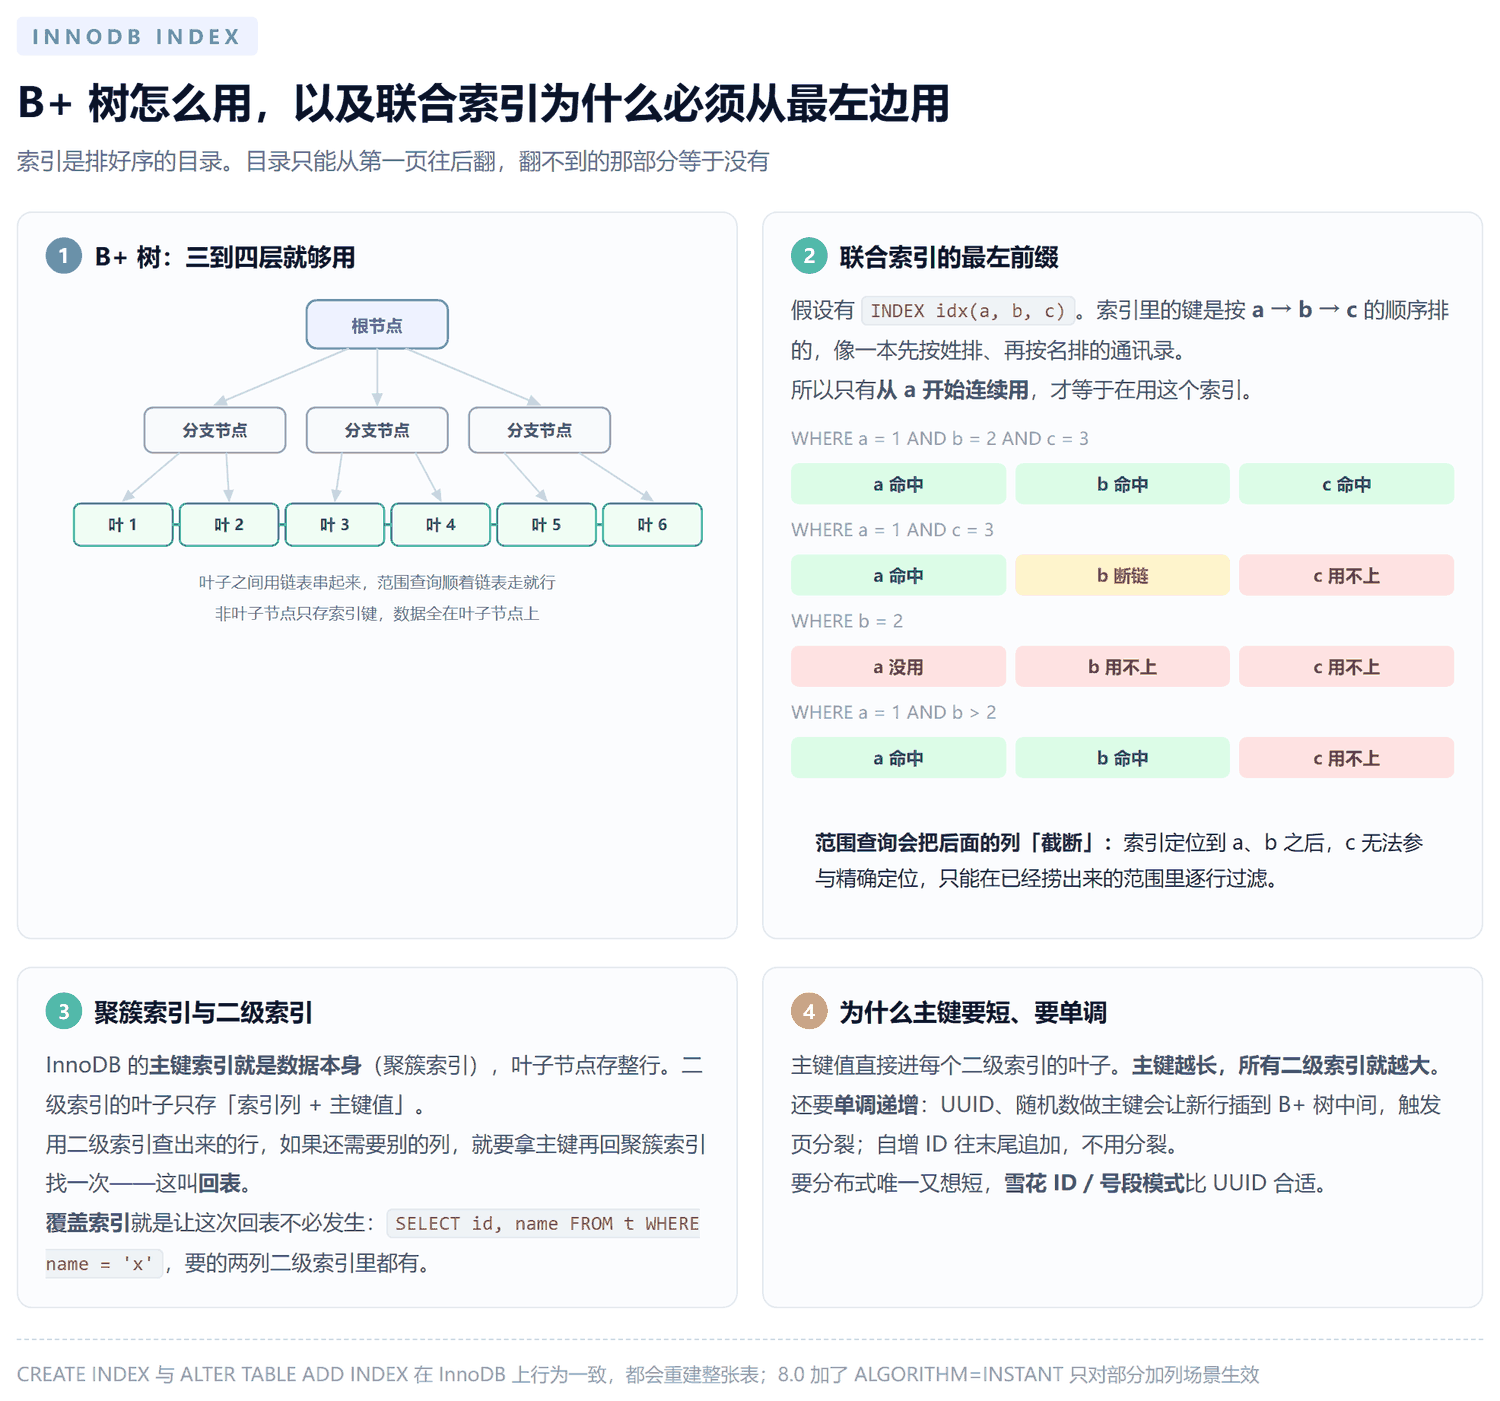
最左前缀规则的根子在排序方式上:INDEX idx(a, b, c) 里的键是按 a → b → c 的顺序排的,像一本先按姓排、再按名排的通讯录。所以只有从 a 开始连续用,才等于在用这个索引。
建一张表把四种情况都跑一遍,用 EXPLAIN 的 key_len 看索引实际用到了第几列:
CREATE TABLE `t_idx` (
  `id`         INT UNSIGNED NOT NULL AUTO_INCREMENT,
  `a`          INT NOT NULL,
  `b`          INT NOT NULL,
  `c`          INT NOT NULL,
  `name`       VARCHAR(32)     NOT NULL DEFAULT '',
  `created_at` DATETIME        NOT NULL DEFAULT CURRENT_TIMESTAMP,
  PRIMARY KEY (`id`),
  KEY `idx_abc` (`a`,`b`,`c`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;
-- 四个字段都是 INT NOT NULL,每个 4 字节
EXPLAIN SELECT * FROM t_idx WHERE a=1 AND b=2 AND c=3; -- key_len=12 三个都用上
EXPLAIN SELECT * FROM t_idx WHERE a=1 AND c=3; -- key_len=4 b 断链,c 用不上
EXPLAIN SELECT * FROM t_idx WHERE b=2; -- key_len=0 完全用不上
EXPLAIN SELECT * FROM t_idx WHERE a=1 AND b>2; -- key_len=8 范围截断,c 用不上key_len 就是「用到了索引的前几列」的字节数 用它判断最左前缀比看文字描述准
范围查询会截断WHERE a=1 AND b>2之后,c 只能在这个范围里逐行过滤
排序方向不影响可用性WHERE a=1 ORDER BY b只要 a、b 是连续的就能用上
13. 回表:一次查询翻两棵树
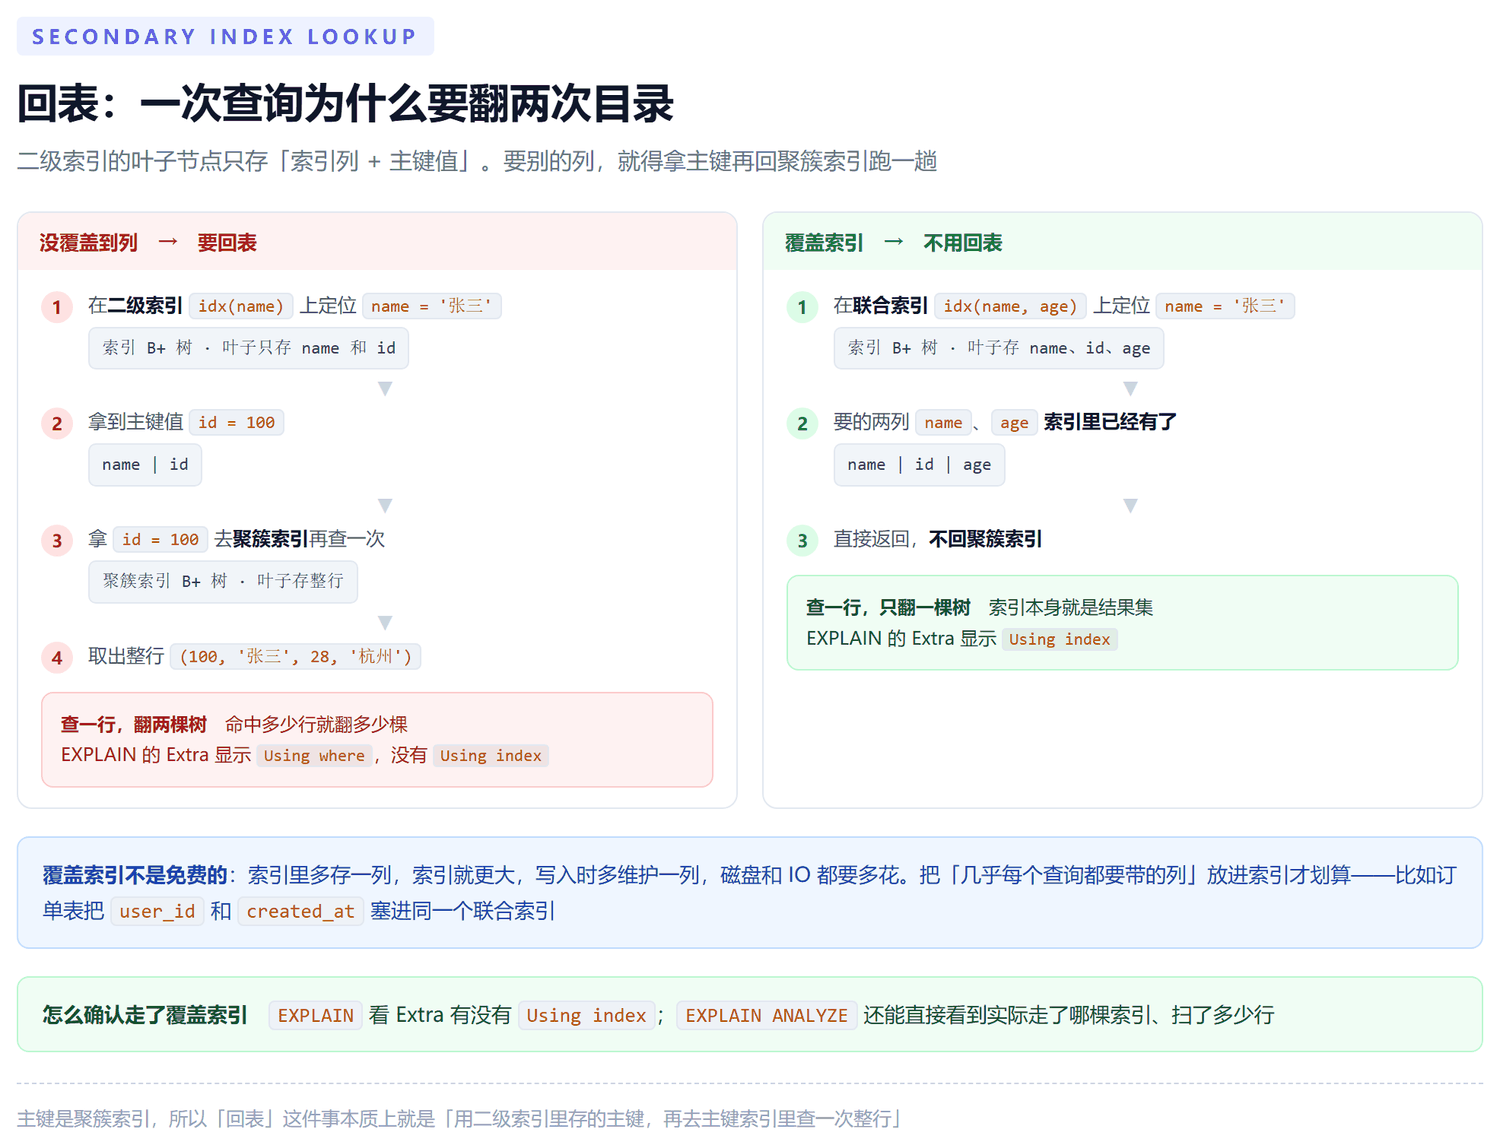
聚簇索引 InnoDB 的主键索引就是数据本身,叶子节点存整行数据。一张表只有一个聚簇索引
二级索引 叶子节点只存「索引列 + 主键值」
回表 用二级索引查出来的行,如果还需要别的列,得拿主键再回聚簇索引找一次
覆盖索引 让这次回表不必发生:SELECT a, b FROM t_idx WHERE a = 1,要的两列二级索引里都有
用 EXPLAIN 的 Extra 就能验证是不是覆盖索引:
-- 要回表:Extra 里没有 Using index
EXPLAIN SELECT * FROM t_idx WHERE a = 1;

-- 覆盖索引:Extra = Using index
EXPLAIN SELECT a, b FROM t_idx WHERE a = 1;

-- 把要带的列补进索引,就变成覆盖索引
ALTER TABLE t_idx ADD KEY idx_ab (`a`,`b`,`c`,`name`);回表是「一行只取一两个字段」的查询反而慢的常见原因——走二级索引定位后,每行都要回一次表。主键的选择也有讲究:要短(主键值进每个二级索引的叶子,主键越长所有二级索引越大)、要单调(UUID 和随机数会让新行插到 B+ 树中间触发页分裂,自增 ID 往末尾追加就不用分裂)。
14. 索引的创建、删除与查看
-- 创建
CREATE INDEX index_name ON table_name (column_name);
ALTER TABLE table_name ADD INDEX index_name (column_name);

-- 删除
DROP INDEX index_name ON table_name;
ALTER TABLE table_name DROP INDEX index_name;

-- 看表上所有索引
SHOW INDEX FROM t_idx;

-- 看索引的使用情况:哪些索引一次都没被用过
SELECT object_schema, object_name, index_name, count_star
FROM performance_schema.table_io_waits_summary_by_index_usage
WHERE index_name IS NOT NULL AND count_star = 0
ORDER BY object_schema, object_name;

-- 更新统计信息(优化器估算不准时)
ANALYZE TABLE t_idx;

-- 看索引的统计信息
SELECT * FROM mysql.innodb_index_stats WHERE table_name = 't_idx';
建索引会锁表 InnoDB 上
CREATE INDEX和ALTER TABLE ADD INDEX行为一致,都会重建整张表。大表上要走在线 DDL 工具或者在低峰期做
8.0 的 INSTANT 只对部分加列场景生效ALGORITHM=INSTANT不能用来加索引
不可见索引适合「先下线观察」ALTER TABLE t ALTER INDEX idx INVISIBLE;索引还在但不供优化器使用,观察一段时间确认没影响再真正删掉
唯一索引还能当约束用 加UNIQUE的同时提供了唯一性保证
15. 索引失效的七种场景
索引失效的根因只有一个:优化器判断走索引还不如全表扫。下面这些写法会触发它的判断,每一种都能用 EXPLAIN 现场验证。
场景一:前导通配符
EXPLAIN SELECT * FROM t_idx WHERE name LIKE '%abc';   -- key=NULL,全表扫
EXPLAIN SELECT * FROM t_idx WHERE name LIKE 'abc%';   -- key=idx,范围扫描
场景二:联合索引不满足最左前缀
EXPLAIN SELECT * FROM t_idx WHERE b = 2 AND c = 3; -- key=NULL场景三:列上做运算或用函数
EXPLAIN SELECT * FROM t_idx WHERE created_at > '2026-01-01';        -- 走索引
EXPLAIN SELECT * FROM t_idx WHERE YEAR(created_at) = 2026;              -- key=NULL
EXPLAIN SELECT * FROM t_idx WHERE created_at + INTERVAL 1 DAY > NOW(); -- key=NULL场景四:隐式类型转换,这一条最隐蔽:
CREATE TABLE `t_phone` (
  `id`    INT UNSIGNED NOT NULL AUTO_INCREMENT,
  `phone` VARCHAR(11)  NOT NULL,
  PRIMARY KEY (`id`),
  KEY `idx_phone` (`phone`)
) ENGINE=InnoDB;

INSERT INTO t_phone (phone) VALUES ('13800138000'), ('13900139000');

EXPLAIN SELECT * FROM t_phone WHERE phone = 13800138000;    -- key=NULL
EXPLAIN SELECT * FROM t_phone WHERE phone = '13800138000'; -- key=idx_phone场景五:字符集不一致,两张表 JOIN 时字符集或排序规则不同,转换发生在索引上,索引用不上。
场景六:OR 连接的条件有一边没索引,整条语句退化。给每一边都建索引,或改写成 UNION。
EXPLAIN SELECT * FROM t_idx WHERE a = 1 OR name = 'x'; -- name 没索引 → 整条退化场景七:不等号和 NOT IN,!=、NOT IN、IS NOT NULL 的优化器估算经常认为全表扫更划算。
场景四的机制 字段是 varchar、参数是数字,MySQL 会把每一行的字符串转成数字再比较,转换发生在索引列上,索引直接作废。绑定参数时如果框架把数字传成了 int,问题就出在这里
场景三的正面解法 8.0.13 起支持函数索引:ALTER TABLE t_idx ADD INDEX idx_year ((YEAR(created_at)));,把函数结果直接存进索引
场景六的正面解法 拆成 UNION:SELECT ... WHERE a=1 UNION SELECT ... WHERE name='x',两个分支各走各的索引
反过来,有几个写法能让索引更好用:
覆盖索引 要查的列全在索引里,不用回表
最左前缀 按索引列顺序写条件
用索引排序ORDER BY的字段和索引顺序一致,能直接利用索引顺序,省掉 filesort
把 OR 拆成 UNION 两个能走索引的分支取并集
16. EXPLAIN 怎么看
EXPLAIN 是看索引用没用上的第一工具。一条完整的输出长这样:
mysql> EXPLAIN SELECT * FROM t_phone WHERE phone = '13800138000';
+----+-------------+---------+------------+------+---------------+---------+---------------------+---------+-------------+
| id | select_type | table   | partitions | type | possible_keys | key     | key_len | ref         | rows | Extra       |
+----+-------------+---------+------------+------+---------------+---------+---------------------+---------+-------------+
|  1 | SIMPLE      | t_phone | NULL       | ref   | idx_phone     | idx_phone | 46      | const       |    1 | Using where |
+----+-------------+---------+------------+------+---------------+---------+---------------------+---------+-------------+
逐列读:
type 访问类型,从好到差:
const>eq_ref>ref>range>index>ALL。ALL就是全表扫描,看到它先查 WHERE 条件有没有索引
possible_keys / key 候选索引和实际选中的索引。possible_keys有值但key是 NULL,说明优化器放弃了
key_len 索引用到了前几列、每列多少字节。上一节用它判断最左前缀
rows 预计要扫多少行。和实际差很多说明统计信息过期,跑ANALYZE TABLE更新
filtered 按条件过滤后剩余的百分比,和 rows 相乘是真正要处理的行数
ExtraUsing index是覆盖索引(好事),Using index condition是索引条件下推(也是好事),Using filesort是额外排序(要优化),Using temporary是用了临时表
8.0.18 起有更精确的 EXPLAIN ANALYZE:它真跑一遍并给出实际行数和耗时,比估算值准得多。
EXPLAIN ANALYZE SELECT * FROM t_phone WHERE phone = '13800138000';还有两个输出格式:EXPLAIN FORMAT=TREE 给出优化器决策树(能看到它为什么选了某个索引),EXPLAIN FORMAT=JSON 给出最详细的成本估算。
17. 索引类型
主键索引 建在主键上,就是聚簇索引
唯一索引 带 UNIQUE 约束,既保证唯一又能加速查找
复合索引 多个字段合起来建一个,注意最左前缀
全文索引FULLTEXT,InnoDB 从 5.6 起就支持了,做关键词检索用
空间索引SPATIAL,给几何类型用
降序索引 8.0 起支持INDEX idx(a DESC),配合ORDER BY a DESC免排序
函数索引 8.0.13 起支持INDEX idx((YEAR(created_at))),把函数结果直接存进索引,正面解决「列上用函数索引失效」
多值索引 8.0.17 起支持,JSON 数组字段上建索引,一个值对应多个索引项
不可见索引ALTER TABLE t ALTER INDEX idx INVISIBLE;,索引还在但不供优化器使用,适合「先下线观察再彻底删」
💡 补充:几处版本差异。InnoDB 从 5.6 起就支持全文索引了,老资料里「只有 MyISAM 支持全文索引」的说法早就过期。8.0.17 起整数显示宽度(INT(11))和 ZEROFILL 被标记废弃,将来会移除。还有 mysql_native_password 认证插件8.4 起默认禁用、9.0 起彻底移除,老客户端连不上新实例时,先查这一条——默认认证插件已经是 caching_sha2_password 了。锁相关的版本差异集中在 8.0:锁视图从 information_schema.innodb_locks 搬到了 performance_schema.data_locks,FOR UPDATE 多了 NOWAIT 和 SKIP LOCKED 两个选项,LOCK IN SHARE MODE 有了更短的写法 FOR SHARE。
🔥 一句话总结:事务靠 redo log 保证持久、undo log 保证回滚,提交那一刻数据只进了 redo log 和内存页、数据页由后台慢慢刷;隔离级别默认是可重复读,靠 MVCC 的版本链加 ReadView 挡住脏读和不可重复读;锁分 MDL、表级、意向、行级四层,行级锁能不能只锁一行完全取决于索引走没走上去,走不上就锁全表;死锁是环形等待,InnoDB 用 wait-for graph 检测到就立刻回滚一个;而索引本身是一棵 B+ 树,聚簇索引存数据、二级索引存主键,查别的列就得回表,联合索引必须从最左用——索引一失效,整套并发控制跟着塌。