
01-MySQL 基础:类型、建表与查询
📝 笔记摘要:MySQL 的数据类型、建表规范与查询写法
MySQL 的表结构是所有活的地基:类型选错,索引和性能都会跟着歪;CREATE TABLE 写歪了,后面所有的查询都在替它买单。这篇按「选类型 → 建表 → 改表 → 增删改查 → 连接 → 分组」的顺序走一遍,每一步都给出 2026 年还能直接用的写法。
MySQL 系列 共 5 篇,这是第 1 篇
01-MySQL 基础 类型、建表与查询 ← 本篇
02 MySQL 事务、锁与索引 ACID、隔离级别、锁层级与索引失效
03 MySQL 函数专题 CONCAT、CONCAT_WS 与 GROUP_CONCAT
04 MySQL 报表实战 同环比、日期序列与多表连接
05 MySQL 优化与版本细节 优化清单、版本行为差异与转义
这篇的结构
1. 数值类型:金额别用 FLOAT
2. 字符串类型:CHAR、VARCHAR 与 TEXT 怎么选
3. 日期与时间类型:DATETIME 和 TIMESTAMP 的差别
4. 建表:字段属性、字符集和引擎
5. 改表与删表
6. 外键:用还是不用
7. 增删改查
8. WHERE 与运算符
9. 模糊查询、IN 与连接查询
10. 自连接、排序与分页
11. 子查询与嵌套查询
12. 聚合函数与分组查询
13. MD5 与哈希
只想找一份能抄的 DDL / DML / DQL 命令清单的话,站内那篇 MySQL 入门概念 够用,它一页列完各类型的常用命令。这里往下走的是这些命令背后的选择和坑。
1. 数值类型:金额别用 FLOAT
整数类型按存储宽度分档,宽度直接决定取值范围:
TINYINT 1 字节,0~255(有符号 -128~127),布尔值和状态码用它
SMALLINT 2 字节,0~65535
MEDIUMINT 3 字节,0~16777215
INT 4 字节,0~4294967295,有符号 -2147483648~2147483647
BIGINT 8 字节,够用一辈子,也是雪花 ID、分布式主键的常见落点
带 UNSIGNED 就变成非负数,范围整体右移一位。老资料里常见的「int 原本是 -127~127,unsigned 后是 0~256」是 TINYINT 的范围,写成 INT 就差得离谱了。
浮点类型只有两个:FLOAT 4 字节单精度,DOUBLE 8 字节双精度。它们是二进制浮点,十进制的小数在里面存不精确。
为什么金额不能用 DOUBLE
0.1 + 0.2在 DOUBLE 里不等于0.3,是二进制表示不了十进制 0.1 导致的。金额算到最后几分钱对不上,财务就来找你了
该用什么DECIMAL(M,D),定点小数,M是总位数、D是小数位数,存的是精确十进制
老资料的存储公式要更新 「M>D 取 M+2,否则 D+2」是 MySQL 5.0 之前的规则。5.0 之后精确值类型的存储长度由M决定,比这个老公式省
2. 字符串类型:CHAR、VARCHAR 与 TEXT 怎么选
CHAR(N) 定长,0~255 字符。身份证号、手机号这种长度固定的用它,不补空格(MySQL 会去掉尾部空格),查询时按固定长度比较
VARCHAR(N) 变长,0~65535 字符。实际占多少取决于存进去的内容,但取值范围和定长一样有上限
TINYTEXT / TEXT 0~255 / 0~65535 字节,不带长度声明
MEDIUMTEXT / LONGTEXT 16 MB / 4 GB
三个容易踩的点:
VARCHAR(N) 里的 N 是字符数不是字节数 MySQL 5.0.3 之前是字节数,之后改成了字符数。同一句
VARCHAR(255),老版本存不下 255 个汉字(3 字节一个),新版本存得下
但 utf8mb4 下最多也只占 1020 字节 4 字节字符 × 255 字符 = 1020 字节。InnoDB 一行放不下超长的VARCHAR时会把长的部分存到行外,这会让随机 IO 变多
TEXT 不是「更长的 VARCHAR」 它不能有默认值(8.0.13 起支持表达式默认值),行内只存 20 字节指针,必须读出来才能拿到内容
字符集这一层现在必须写清楚。MySQL 里的 utf8 其实是 utf8mb3——一个最多 3 字节的伪 UTF-8,存不了 emoji 和部分生僻字。官方从 8.0.11 起就写明「utf8mb3 将来会被 utf8mb4 取代,utf8 别名将来会指向 utf8mb4」。
建表就写 utf8mb4 不要写
utf8,也不要写utf8mb3
要兼容 utf8 和 utf8mb4 的老库 26.7 提供了 sql_modeINTERPRET_UTF8_AS_UTF8MB4,打开后utf8按 utf8mb4 解释(默认关闭)
排序规则 8.0 起默认是utf8mb4_0900_ai_ci,ai表示不区分重音、ci表示不区分大小写。中文站点常用它
3. 日期与时间类型:DATETIME 和 TIMESTAMP 的差别
DATE
YYYY-MM-DD,只有日期,范围 1000-01-01 到 9999-12-31
TIMEHH:MM:SS,既能表示时刻也能表示时长(可以是 -838:59:59 到 838:59:59)
DATETIMEYYYY-MM-DD HH:MM:SS,范围 1000 到 9999 年,不随时区变化
TIMESTAMP 4 字节 Unix 时间戳,范围只有 1970-01-01 到 2038-01-19,按会话时区做转换
老资料里把 TIMESTAMP 描述成「时间戳、全球唯一」是不准确的。它是自动按时区换算的类型:库里存的是 UTC,连接时按 time_zone 转成本地时间给你看。跨时区业务用它是优点,但 2038 年上限是硬伤。
选哪个 业务时间(下单时间、创建时间)用
DATETIME,语义是「墙上时间」,不受时区和 2038 影响
事件时间(最后修改时间)用TIMESTAMP,省空间、且带ON UPDATE CURRENT_TIMESTAMP的自动维护
注意时区 服务器时区是 UTC、客户端是 Asia/Shanghai 时,NOW()和 Java 侧new Date()写进去的值可能差 8 小时。库、应用、连接串的时区要统一
4. 建表:字段属性、字符集和引擎
完整的建表语法长这样,方括号里的都是可选的:
CREATE TABLE [IF NOT EXISTS] `表名`(
    `字段名` 列类型 [属性] [索引] [注释 COMMENT],
    PRIMARY KEY (`主键字段`)
)[表类型 ENGINE=InnoDB] [字符集 DEFAULT CHARSET=utf8mb4];
常用属性就那么几个:
NOT NULL 不允许为空。加上
NULL的列在索引、排序、统计上都要多花代价,能禁就禁
DEFAULT 默认值。MySQL 8.0.13 起默认值可以是表达式,比如DEFAULT (CURRENT_TIMESTAMP)
AUTO_INCREMENT 自增,必须建在索引上(一般是主键),一张表只能有一个
UNSIGNED 非负数
ZEROFILL 补零显示。8.0.17 起已废弃,和整数显示宽度一起被标记为将来移除
COMMENT 字段注释,写给人看的
一段能直接用的建表语句:
CREATE TABLE IF NOT EXISTS `student` (
  `id`         INT UNSIGNED NOT NULL AUTO_INCREMENT COMMENT '学号',
  `name`       VARCHAR(20)  NOT NULL DEFAULT '匿名' COMMENT '姓名',
  `score`      DECIMAL(6,2) NOT NULL DEFAULT 0.00 COMMENT '分数',
  `created_at` DATETIME    NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '创建时间',
  PRIMARY KEY (`id`),
  KEY `idx_name` (`name`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_0900_ai_ci;两个容易写错的地方:反引号包的是标识符(表名、字段名),单引号包的是字符串字面量,两者的区别是语法级的,不是风格问题。另外别用中文逗号,中文标点会让解析直接报错。
引擎怎么选
MyISAM 和 InnoDB 的差异集中在三点:
事务 InnoDB 支持,MyISAM 不支持
锁 InnoDB 是行锁,只锁命中的行;MyISAM 是表锁,一次锁整张表
崩溃恢复 InnoDB 有 redo log,宕机后能回滚恢复;MyISAM 靠定时写盘,崩了就是崩了
外键 InnoDB 支持,MyISAM 不支持
全文索引 两者都支持——老资料里说「只有 MyISAM 支持」是 InnoDB 5.6 之前的事
26.7 里 MyISAM 依然存在,但 InnoDB 是默认引擎,要用 MyISAM 得显式写 ENGINE=MyISAM。除非有非常明确的理由——比如需要 MEMORY 之外的全表内存压缩、或者从遗留系统迁移——新表一律 InnoDB。
老资料里那句「InnoDB 在系统文件中只有一个 .frm 文件,加上级目录的 ibdata1」也已经不成立了。8.0 起表数据默认存成每表一个 .ibd 文件(innodb_file_per_table=ON),表定义进了 mysql.ibd 里的数据字典,.frm 只是留着的兼容文件。好处是删表能真删掉磁盘空间,不用像 ibdata1 那样越用越大。
5. 改表与删表
改表名
ALTER TABLE `旧表名` RENAME TO `新表名`;
加字段ALTER TABLE `表名` ADD `字段名` 列类型 [属性];
改字段属性ALTER TABLE `表名` MODIFY `列名` 新类型;
改字段名ALTER TABLE `表名` CHANGE `旧列名` `新列名` 新类型;
删字段ALTER TABLE `表名` DROP COLUMN `列名`;
删表DROP TABLE IF EXISTS `表名`;
MODIFY 和 CHANGE 的区别是初学者最容易搞混的:CHANGE 改字段名(顺带可以改类型),MODIFY 只改类型不改名字。两个都不写新名字的时候会报语法错。
大表加字段会锁表吗 8.0 支持
ALGORITHM=INSTANT,部分加列场景不重建表(要求加在最后、不带默认值)。8.0.29 起ALGORITHM=NONE能在不支持 INSTANT 时自动降级,普通加列不至于整张表卡死
改字段类型一定是重建表 数据要重新转换、索引要重建,大表上就是一次长时间 DDL
删字段不会缩文件 InnoDB 的行是变长的,空出来的空间留给后续插入用,OPTIMIZE TABLE才会真正重建收缩
6. 外键:用还是不用
物理外键的建法:
ALTER TABLE `test01`
  ADD CONSTRAINT `FK_gradeid`
  FOREIGN KEY (`gradeid`) REFERENCES `test02`(`gradeid`);
它能保证引用完整性,但代价是:父表被锁、子表的插入要先检查父表、分库分表后没法用、批量导入数据要临时关掉 foreign_key_checks。互联网业务里大多数团队不用物理外键,改成应用层保证,约束靠代码和测试兜。
8.0.16 起 CHECK 约束被真正执行 以前
CHECK只是被解析器放过的装饰品,现在真的会拦数据。所以「用 CHECK 约束表达业务规则」这条替代方案现在成立了
状态字段用 ENUM 或 CHECK 比VARCHAR(20)存任意字符串强
唯一性用唯一索引 唯一索引既能保证唯一,又能加速查找,比外键实用得多
7. 增删改查
增删改的语法都很直白,WHERE 条件永远别忘:
-- 插入
INSERT INTO `表名` (`字段1`, `字段2`)
VALUES (值1, 值2), (值1, 值2);

-- 更新
UPDATE `表名` SET `列名` = 新值 WHERE 修改条件;

-- 删除
DELETE FROM `表名` WHERE 条件;

-- 查询
SELECT `列名`, `列名` FROM `表名` WHERE 条件
  GROUP BY 分组字段 HAVING 分组后过滤
  ORDER BY 排序列 ASC|DESC
  LIMIT 起始条数, 条数;
清空表有三条命令,行为差别很大:
DELETE 逐行删,可以带
WHERE,能回滚(但删 millions 行会写巨量 undo log)
TRUNCATE 整表清空,重置自增计数器,不写 undo log、速度快,是 DDL,不能回滚,会清空并重建表空间
DROP TABLE 表都没了,结构和数据一起没
要清空一张表就用 TRUNCATE,别用不带 WHERE 的 DELETE——后者在 InnoDB 上可能比 TRUNCATE 慢一个数量级。
8. WHERE 与运算符
= 等于
<> 或 != 不等于
> < >= <=大小比较
BETWEEN a AND b 区间,两端闭区间
IN (...) 在集合里
LIKE 模糊匹配,配合%和_
IS NULL / IS NOT NULL 判空。不能用 = NULL,那是三值逻辑,永远不成立
AND / OR / NOT 逻辑连接
两个关于 NULL 的规则要刻在脑子里:任何与 NULL 做比较的运算,结果都是 NULL(不是 false);聚合函数默认忽略 NULL,但 COUNT(*) 数的是行数、不忽略,COUNT(列名) 忽略 NULL。
老资料说「COUNT(1) 性能优于 COUNT(*)」——那是 MySQL 5.x InnoDB 的老结论。现在两者生成的执行计划基本一样,没有可测量的差距,统一写 COUNT(*) 就行。
9. 模糊查询、IN 与连接查询
模糊查询的两个通配符:% 匹配 0 到任意个字符,_ 匹配恰好 1 个字符。
-- 包含 Keyword
SELECT * FROM `表名` WHERE `字段名` LIKE '%Keyword%';

-- 以 Keyword 开头,后面恰好 1 个字符
SELECT * FROM `表名` WHERE `字段名` LIKE 'Keyword_';
IN 用来把值收进集合:
SELECT `列名` FROM `表名` WHERE `列名` IN (值1, 值2, 值3);连接查询是把多张表拼成一张宽表。四个变体,差别只在「不匹配的行算不算」:
INNER JOIN 只返回两边都匹配上的行。左表独有的行会被丢掉
LEFT JOIN 左表每一行都保留,右表匹配不上时补 NULL
RIGHT JOIN 右表每一行都保留。实际项目里几乎用不到,把主表换到左边写 LEFT JOIN 更好读
FULL OUTER JOIN MySQL 不支持,要「两边都全留」只能拿 LEFT JOIN 和 RIGHT JOIN 取并集
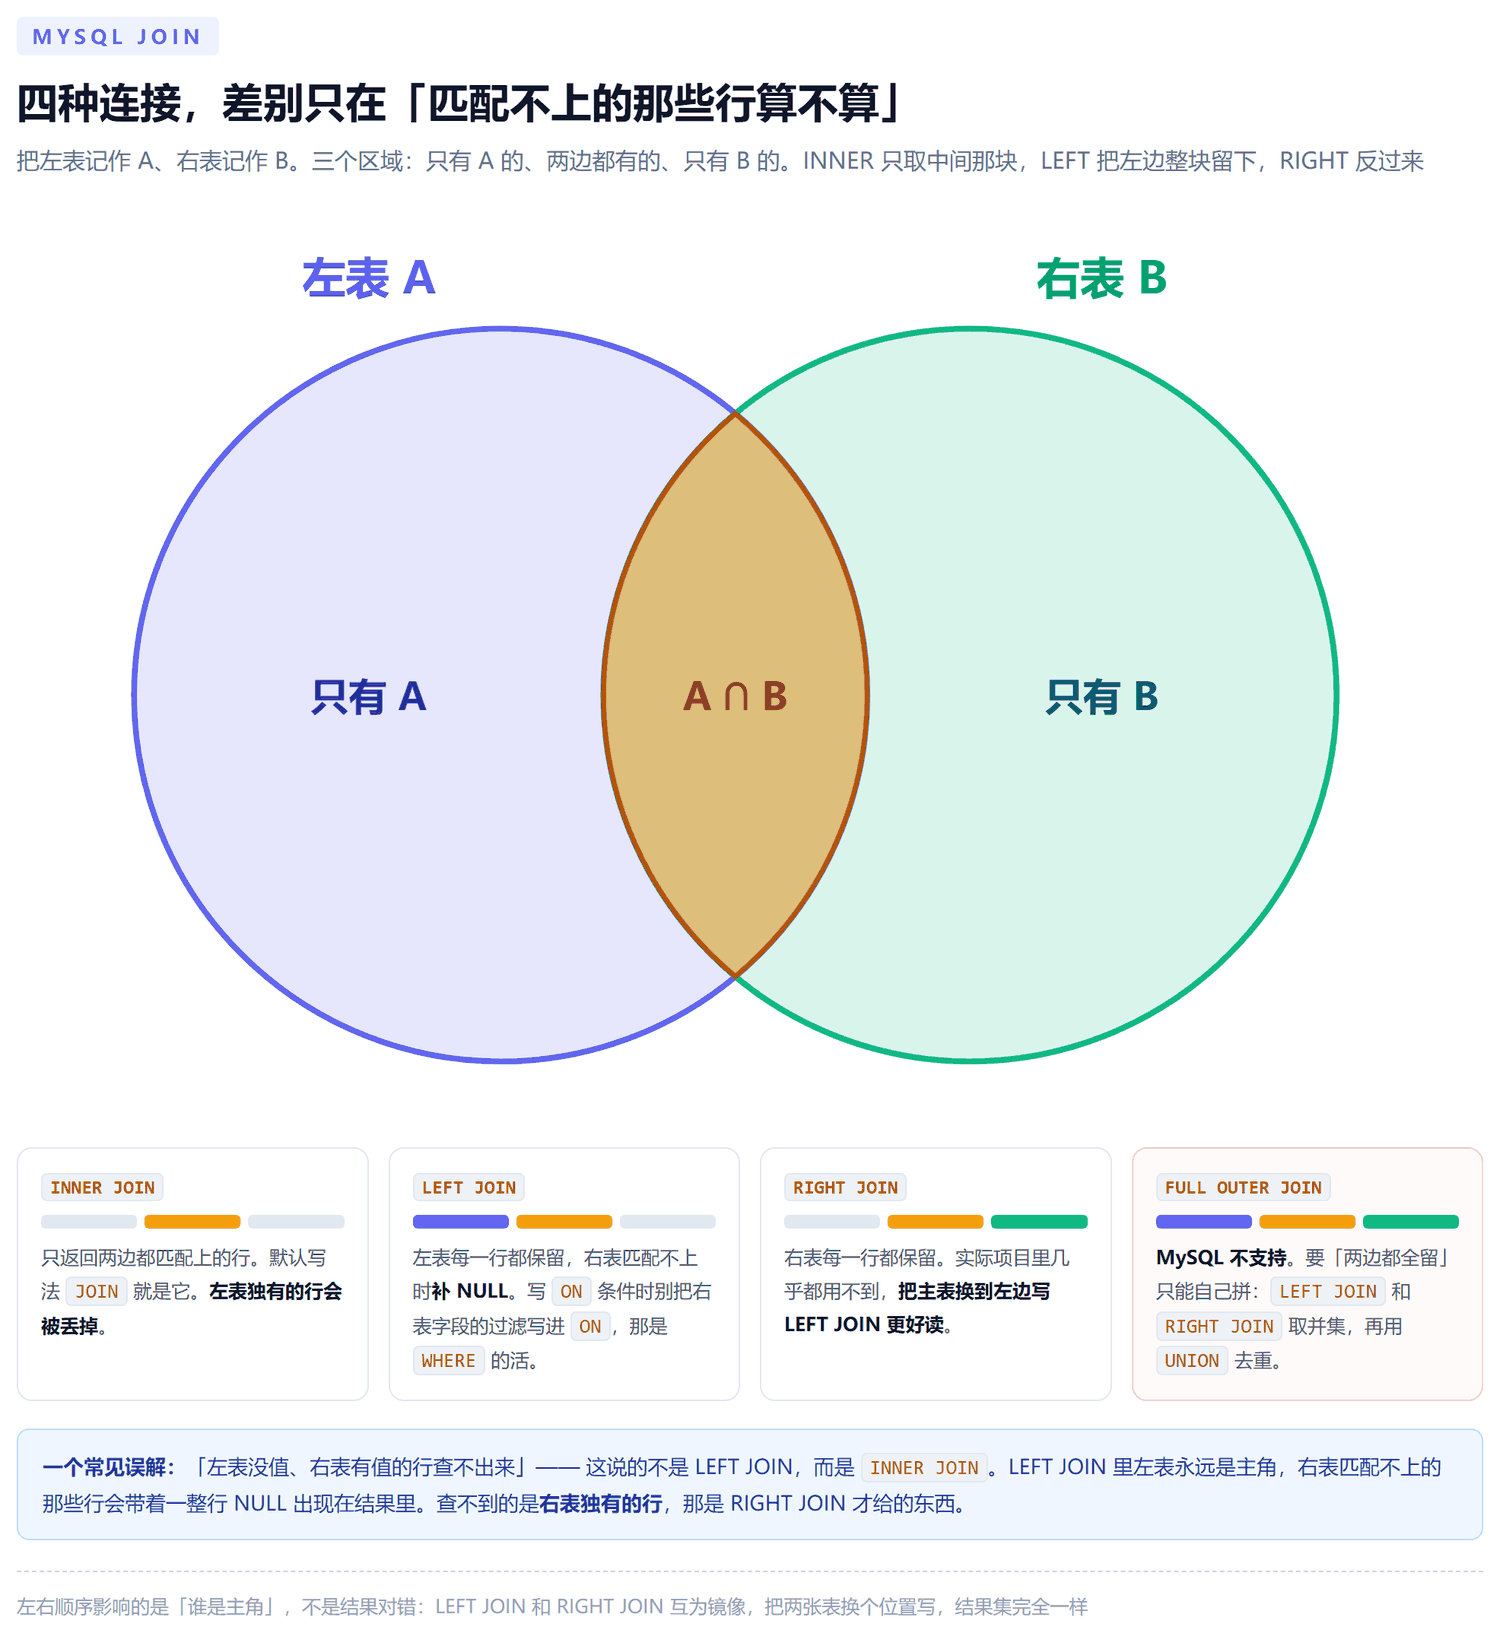
用的时候记住两件事:写 LEFT JOIN 时,把右表字段的过滤条件写进 ON 而不是 WHERE,写进 WHERE 会把补 NULL 的行再过滤一遍,LEFT 就退化成 INNER 了;ON 里只放连接条件,WHERE 里放对结果集的过滤。
10. 自连接、排序与分页
同一张表当两张表用,就能查父子关系。分类表里「省—市—区」三级都存在一张表里时特别常用:
SELECT a.categoryname AS '父类',
       b.categoryname AS '子类'
FROM category AS a
JOIN category AS b ON a.categoryid = b.pid;
老资料里写成 FROM category a, category b WHERE a.categoryid = b.pid 也能跑,但 8.0 起推荐用显式的 JOIN ... ON,可读性和出错概率都更好。
排序和分页:
SELECT * FROM `表名` ORDER BY `字段` ASC;   -- 升序
SELECT * FROM `表名` ORDER BY `字段` DESC;  -- 降序
SELECT * FROM `表名` LIMIT i, n;
LIMIT i, n 里 i 是偏移量(从 0 开始),n 是返回条数,LIMIT n 等价于 LIMIT 0, n。写 SQL 分页的时候别把这两个参数搞混。
深度分页是慢的根源
LIMIT 1000000, 10要先扫掉前 100 万行再吐 10 行,数据量一大就是灾难
两个解法 延迟关联:先用覆盖索引把主键查出来,再回原表取 10 行;游标翻页:记住上一页最后一条的排序值,用WHERE id > 上次id往下翻,不带偏移量
排序字段必须有索引 否则ORDER BY会触发额外排序(filesort),数据量一大就是临时表落盘
11. 子查询与嵌套查询
子查询就是把一次查询的结果当另一个查询的条件。分三种位置:
在 FROM 里(派生表) 把子查询当一张表用,必须起别名:
FROM (SELECT ...) AS t
在 WHERE 里WHERE price > (SELECT AVG(price) FROM ...),用来跟聚合值比较
在 SELECT 里SELECT name, price - (SELECT AVG(price) FROM ...) FROM ...,算出每行跟平均值的差
-- 从子查询里再筛
SELECT *
FROM (SELECT * FROM product WHERE price > 500) AS t
WHERE t.category = '电子产品';

-- 等价的写法:子查询也可以下推到 WHERE
SELECT * FROM product
WHERE price > 500 AND category = '电子产品';

-- 大于平均价的商品
SELECT * FROM product
WHERE price > (SELECT AVG(price) FROM product);
8.0 的优化器对子查询的改写能力提升很大(derived condition pushdown、semi-join 改写),「少用子查询」这个老规矩要打个折扣:能改写成 JOIN 的优先改写,改写不了的复杂子查询完全可以留着。真正要避免的是「子查询套子查询再套 JOIN」这种没人看得懂的写法。
12. 聚合函数与分组查询
聚合函数:COUNT 计数、SUM 求和、AVG 平均、MAX 最大、MIN 最小。
分组查询的执行顺序是固定的,这决定了 WHERE 和 HAVING 各管什么:
FROM → WHERE → GROUP BY → HAVING → SELECT → ORDER BY → LIMITWHERE 筛的是行 分组之前的过滤,所以它管不了聚合函数的结果
HAVING 筛的是组 分组之后的过滤,专管COUNT(*) > 10这种条件
SELECT 里的字段有约束 用了GROUP BY之后,SELECT 里只有分组字段本身和带聚合函数的表达式是有意义的,其他字段取的是任意一行的值——这是老资料里没讲清楚的坑
老资料把顺序写成「from → where → group by → select → order by」,漏了 HAVING,而 HAVING 恰恰是分组查询里最容易写错的地方。
分组之后想按多个字段分组,GROUP BY 后面跟多个字段就行;也可以用 GROUP BY 表达式分组,比如按「姓名 + 邮箱」这个组合去重后取年龄最大值:
SELECT name, email, MAX(age)
FROM student
GROUP BY name, email;
另外,8.0 起 ONLY_FULL_GROUP_BY 是默认开启的(sql_mode 默认值里就有它),会直接拒绝那些「SELECT 了没分组的字段」的语句。26.7 的 sql_mode 默认值是:ONLY_FULL_GROUP_BY、STRICT_TRANS_TABLES、NO_ZERO_IN_DATE、NO_ZERO_DATE、ERROR_FOR_DIVISION_BY_ZERO、NO_ENGINE_SUBSTITUTION。
13. MD5 与哈希
MD5() 是内置函数,MD5('abc') 直接返回 32 位十六进制字符串。「MD5 的运算过程不可逆,但相同的值对应的 MD5 一样」这个说法本身没错,错的是把它当成密码存储方案。
能用在哪 文件名去重、URL 签名、缓存 key、内容指纹比对——这些场景下它够用
不能用来存密码 MD5 是为速度设计的,彩虹表和 GPU 爆破早就能把常见密码秒解。存密码用bcrypt或Argon2,实在要用哈希就用 SHA-256 以上
更不能用它做数据脱敏 手机号、身份证这种,MD5 是可逆的(靠彩虹表和穷举),脱敏要用掩码或加密
💡 补充:几处老资料里过时的地方。整数显示宽度(INT(11) 里的 11)8.0.17 起被废弃,将来会移除,写不写都一样,别再靠它控制显示宽度。字符集别名 utf8 仍默认指 utf8mb3,但官方已明确将来会改指 utf8mb4,建表直接写 utf8mb4。还有 GRANT 建用户的老写法在 8.0.11 就被移除了(连 NO_AUTO_CREATE_USER 这个 sql_mode 一起没了),现在一律用 CREATE USER 配 GRANT。
🔥 一句话总结:MySQL 基础就是三件事——类型按语义选(金额用 DECIMAL、字符集写 utf8mb4、时间想清楚时区)、建表把字段属性和引擎定死(InnoDB + utf8mb4 + 合理索引)、查询按语义选连接方式(INNER 只留两边都有的、LEFT 留主表),剩下的分组、索引和事务在下一篇接着讲。