
5
0
0
python数据分析
数据分析三剑客
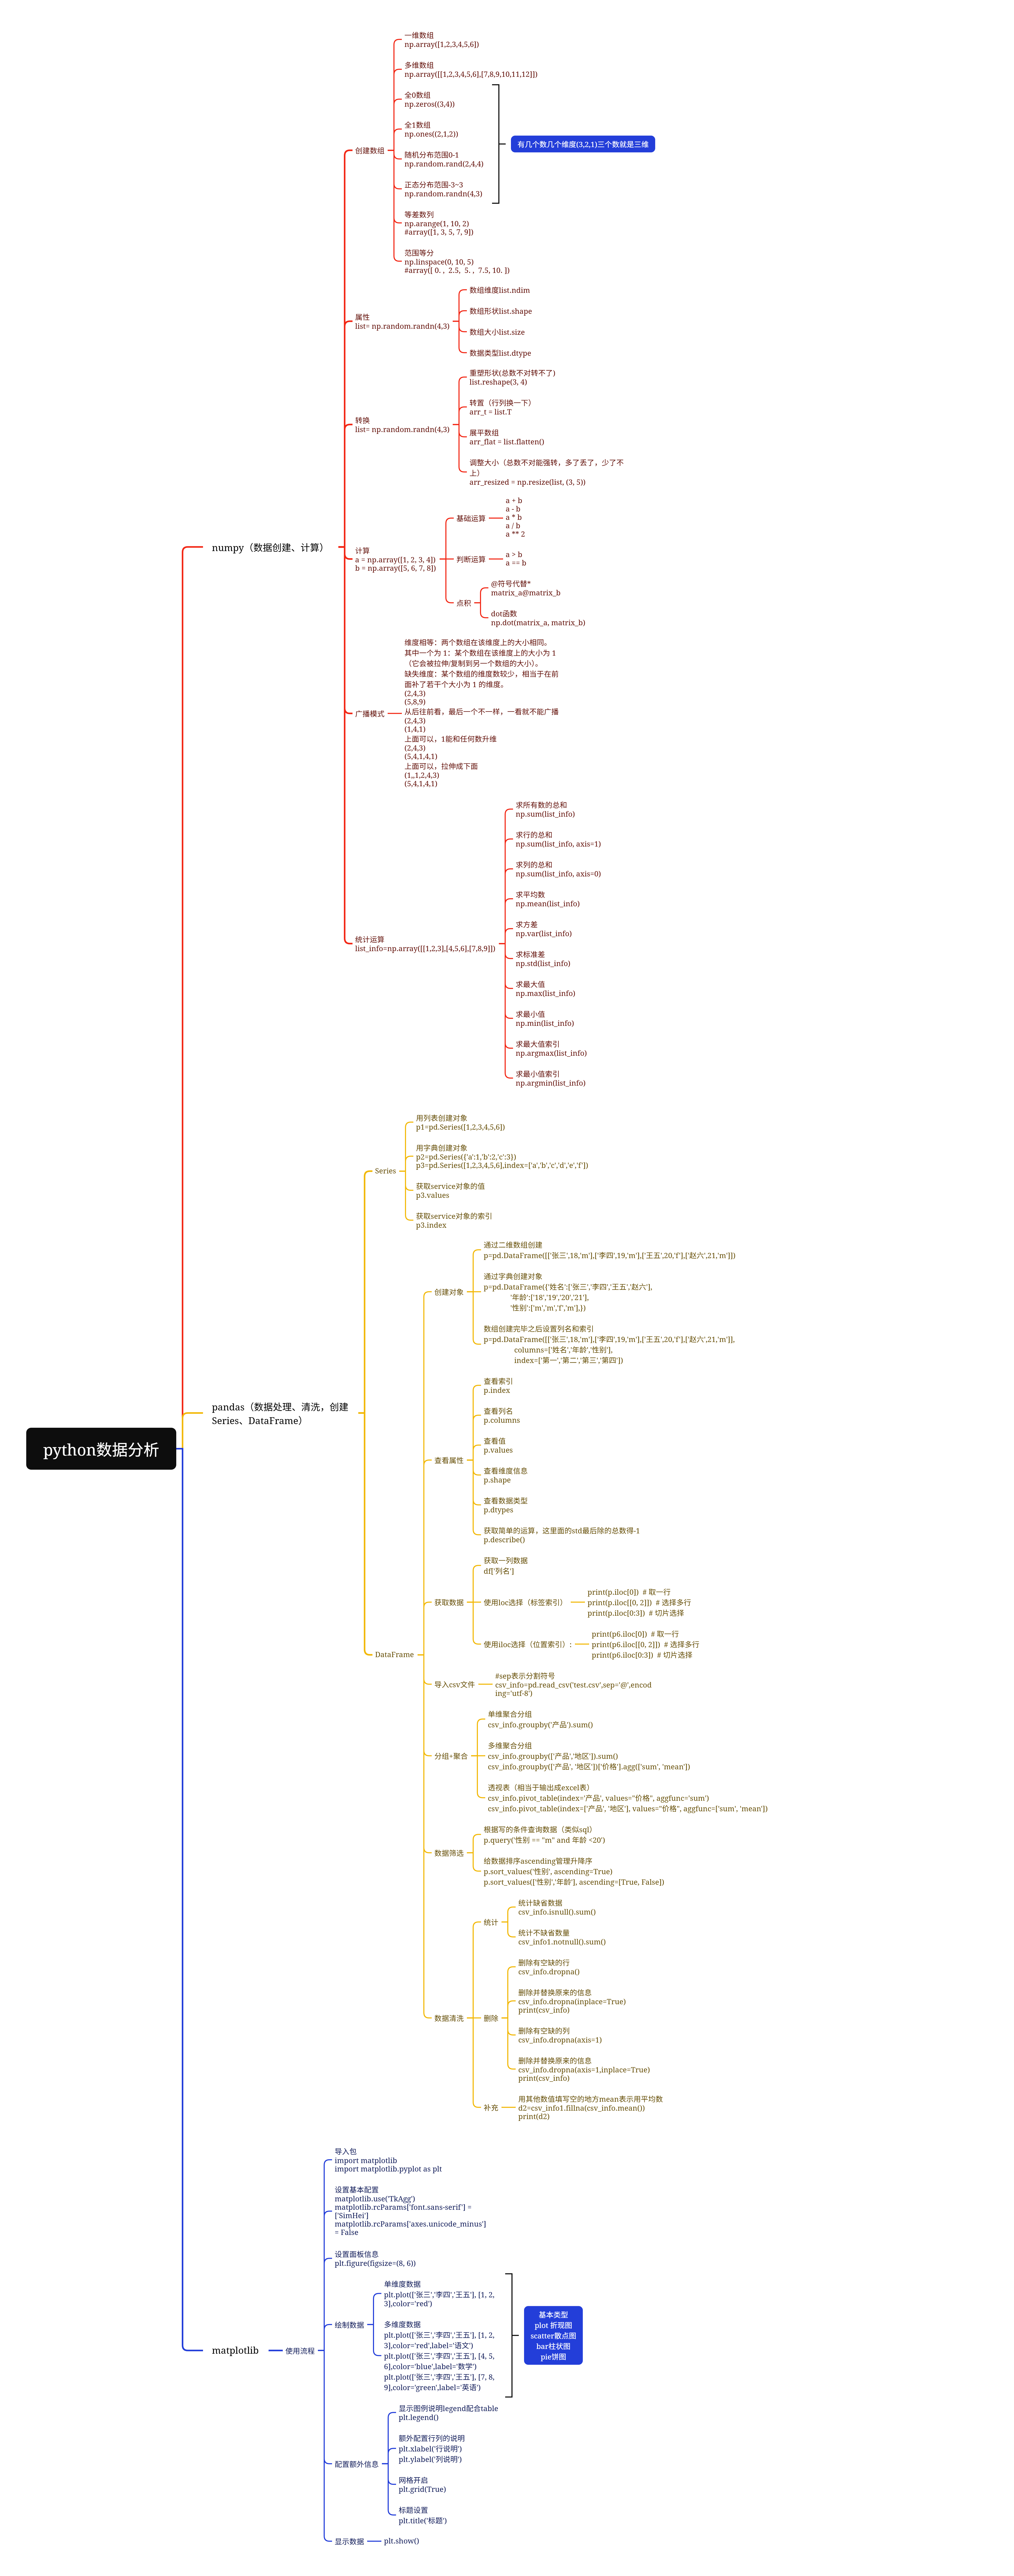
思维导图
numpy - 数据计算(生成数据)
pandas - 数据处理
matplotlib - 绘制数据
numpy
import numpy as np
1.生成数组
np.array([1,2,3])
np.array([[1,2][2,3]])
2.全0全1
np.zeros((2,3))
np.ones((2,3))
3.区间/均分
np.arange(0,10,3)起始,结束,步长(包头不包围)
np.linspace(1,2,3)起始,结束,切几下
4.随机+正态
np1 = np.random.rand((2,3))#0~1
np2 = np.random.randn((2,3))#-3~3
5.数组的属性
np1.ndim#维度
np1.shape#形状
np1.size#大小
np1.dtype#类型
6.形状处理
n1.reshape(3,4) #重置形状
n1.T #转置 行列互换
n1.flatten() # 变成1行
np.resize(np1,(3,4)) #重置形状+内容
7.数组的计算
+-*/** > == <
点击.dot
np.dot(1,2) #标量运算
np.dot([1,2],[2,3]) #向量运算
np.dot( [[1,2],[2,3]],[[1,2],[2,3]] ) #矩阵运算
矩阵@ matmul
前提:A的列等于B的行
过程:A的每一行*B的每一列
结果:A行B列
8.数组的统计
全部的和/列的和/行的和
np.sum(np1)#全部
np.sum(np1,axis=0)#列
np.sum(np1,axis=1)#行
平均值mean
方差var
标准差std
np.mean(np1)
np.var(np1)
np.std(np1)
最大最小值/索引
np.max(np1)
np.min(np1)
np.argmax(np1)
np.argmin(np1)
# 9.广播机制(由少到多的扩散)
# 1.生维度(少的向多的提升)
# 2.拉伸(少的向多的拉伸)
a1 = np.array(
    [
        [1,2,3],
        [4,5,6],
        [7,8,9]
    ]
)
a2 = np.array([10,20,30])
print(a1+a2)
a3 = np.array([[10],[20],[30]])
print(a1+a3)
# 补充:计算可能会出错(广播是有原则的)
# 原则:维度从尾看,相同才广播,见1都能扩,不足就补1
# a4 -> (3,3)
a4 = np.array([[1,2,3],[4,5,6],[7,8,9]])
# a4 -> 如果是数组(1,3)
# a4 -> 生维以后(1,3)
# a4 -> 生维以后(1,1,3)
# a4 -> 生维以后(1,1,1,3)
a5 = np.array([[[1,2,3]]])
print(a4+a5)
# 例子:
# (3,1,5) (1,2,3,4,5)
# (1,1,3,1,5) (1,2,3,4,5)
pandas
import pandas as pd
创建数据
Series - 列
列表 - s1 = pd.Series([1,2,3,4,5])
0   1
1   2
2   3
3   4
4   5
字典 - s2 = pd.Series({"one":1,"two":2,"three":3,"four":4,"five":5})
'one'     1
'two'     2
'three'   3
'four'    4
'five'    5
s2.values 获取值
s2.index  获取索引
DataFrame - 多列

列表 - d1 = pd.DataFrame([['张三',18,'男','销售部'],['李四',19,'男','销售部'],['王五',20,'女','销售部']])
字典 - d2 = pd.DataFrame({'姓名':['张三','李四','王五'],'年龄':[18,19,20],'性别':['男','男','女'],'部门':['行政部','销售部','销售部']})
    0         1         2       3
0   '张三'    18        '男'    '销售部'
1   '张三'    18        '男'    '销售部'
2   '张三'    18        '男'    '销售部'

自定义列名 和 索引
d3 = pd.DataFrame([['张三',18,'男','销售部'],['李四',19,'男','销售部'],['王五',20,'女','销售部']],columns=['姓名','年龄','性别','部门'],index= ['冠军','亚军','季军'])

属性查看:
形状 d3.shpae
列名  d3.columns
索引名  d3.index
数据类型  d3.dtypes

数据的查询
从头查 - d3.head(2)
从尾查 - d3.tail(2)
通过列查询 - d3['列名']
通过列查询 - d3[['列名1','列名2']]
通过行查询 - d3.loc['索引名']
通过行查询 - d3.loc[['索引名1','索引名2']]
通过行查询 - d3.iloc[索引]
通过行查询 - d3.iloc[[索引1,索引2]]
切片:
一维:[从那开始:到哪结束]
多维:[从那开始:到哪结束,从那开始:到哪结束]

数据筛选+排序:
d3.query('年龄>30 and 部门=="销售部"')
d3.sort_values('列名',ascending=False)
d3.sort_values(['列名1','列名2'],ascending=[False,True])

数据分组+聚合
单分组+单聚合
d3.groupby('列名').sum()
多分组+单聚合
d3.groupby(['列名1','列名2']).sum()
单分组+多聚合
d3.groupby('列名').agg(['sum','mean','max','min'])
多分组+多聚合
d3.groupby(['列名1','列名2']).agg(['sum','mean','max','min'])

透视表(知道就行,模仿excel展示)
p_table = df.pivot_table(columns='地区',values='销售额',aggfunc='sum')
print(f"透视表:\n{p_table}")

读取csv文件(逗号分割的文件)
df = pd.readcsv('文件名',sep=',',encoding='uft-8')
查看为空的
df.isnull().sum()
查看非空的
df.notnull().sum()
删
删除带有空的行,返回删除后的内容
df.dropna()
删除带有空的行,替换原来的数据
df.dropna(inplace=True)
删除带有空的列,返回删除后的内容
df.dropna(axis=1)
删除带有空的行,替换原来的数据
df.dropna(axis=1,inplace=True)
填
df.fillna(0)
df.fillna(df.mean())
matplotlib
绘图流程:
- 1.导包
- 2.设置引擎+中文支持
- 3.设置画板的大小(尺寸)
- 4.绘图
- 可选:图例、x轴y轴说明、标题、网格...
- 5.展示
中美日GDP案例:
import matplotlib
import matplotlib.pyplot as plt
import pandas as pd
matplotlib.use('TkAgg')
matplotlib.rcParams['font.sans-serif'] = ['SimHei']
matplotlib.rcParams['axes.unicode_minus'] = False
plt.figure(figsize=(9, 6))
# 读取csv文件获取数据(1.准备数据)
df = pd.read_csv('1960-2019全球GDP数据.csv',sep=',',encoding='gbk')
# 查看数据是否存在空值(2.数据的预处理)
# print(df.isnull().sum())
# 删除为空的行(2.数据的预处理)
df.dropna(inplace=True)
# print(df)
# 提取要绘制的数据(2.数据的预处理)
df_us = df[df['country']=='美国']
df_cn = df[df['country']=='中国']
df_jp = df[df['country']=='日本']
# print(df_us)
# 把年份设置为索引,压缩数据量,非必须,是优化的步骤(2.数据的预处理)
df_us.set_index('year',inplace=True)
df_cn.set_index('year',inplace=True)
df_jp.set_index('year',inplace=True)
# print(df_us)
# 绘制数据(3.数据的绘制)
# 如果是给别人看,还是要优化一下,展示自己的技术能力!!
plt.plot(df_us.index,df_us['GDP'],label='美国',color='blue')
plt.plot(df_cn.index,df_cn['GDP'],label='中国',color='red')
plt.plot(df_jp.index,df_jp['GDP'],label='日本',color='yellow')
# 图例,标题,xy轴说明,网格(3.数据的绘制)
plt.legend()
plt.title('1960-2019全球GDP数据')
plt.xlabel('年份')
plt.ylabel('GDP')
plt.grid()


plt.show()
目标:看到能理解在干嘛!后续的学习还会使用这些API,用到哪个说哪个!