
04-MySQL 报表实战:同环比、日期序列与多表连接
📝 笔记摘要:同环比报表、连续日期序列与多表连接的实际写法
报表 SQL 和日常的增删改查不是一类东西。它要在一行里同时给出本期、上一期、去年同期的几十个指标,还要算出每一个指标的增长率;折线图要的又是一段连续日期,中间没数据的那些天也得占一行。这篇拆三件事:三个时间窗怎么各自算一遍再拼成一行,没有数据的日期怎么补出来,最后是怎么用同一个表的不同别名连出一串业务关系。
MySQL 系列 共 5 篇,这是第 4 篇
01 MySQL 基础 类型、建表与查询
02 MySQL 事务、锁与索引 ACID、隔离级别、锁层级与索引失效
03 MySQL 函数专题 CONCAT、CONCAT_WS 与 GROUP_CONCAT
04-MySQL 报表实战 同环比、日期序列与多表连接 ← 本篇
05 MySQL 优化与版本细节 优化清单、版本行为差异与转义
这篇的结构
1. 报表 SQL 的骨架:三个时间窗各算一遍
2. 环比和同比比的到底是什么
3. 累计值和增量值,聚合方式不一样
4. sign 常量:给 JOIN 造一个连接键
5. 增长率:先判分母再算
6. 折线图要连续日期:造序列的两条路
7. 月份桶:把日期对齐到月初
8. 同一个表用不同别名连多次
9. 动态条件拼接
10. 几条会咬人的细节
表结构、类型选择和基本的增删改查在 MySQL 基础 那篇;连接查询的类型在那边讲得更细,这篇只讲报表场景下怎么连。SQL 层面的优化清单和版本行为差异在 MySQL 优化与版本细节。
1. 报表 SQL 的骨架:三个时间窗各算一遍
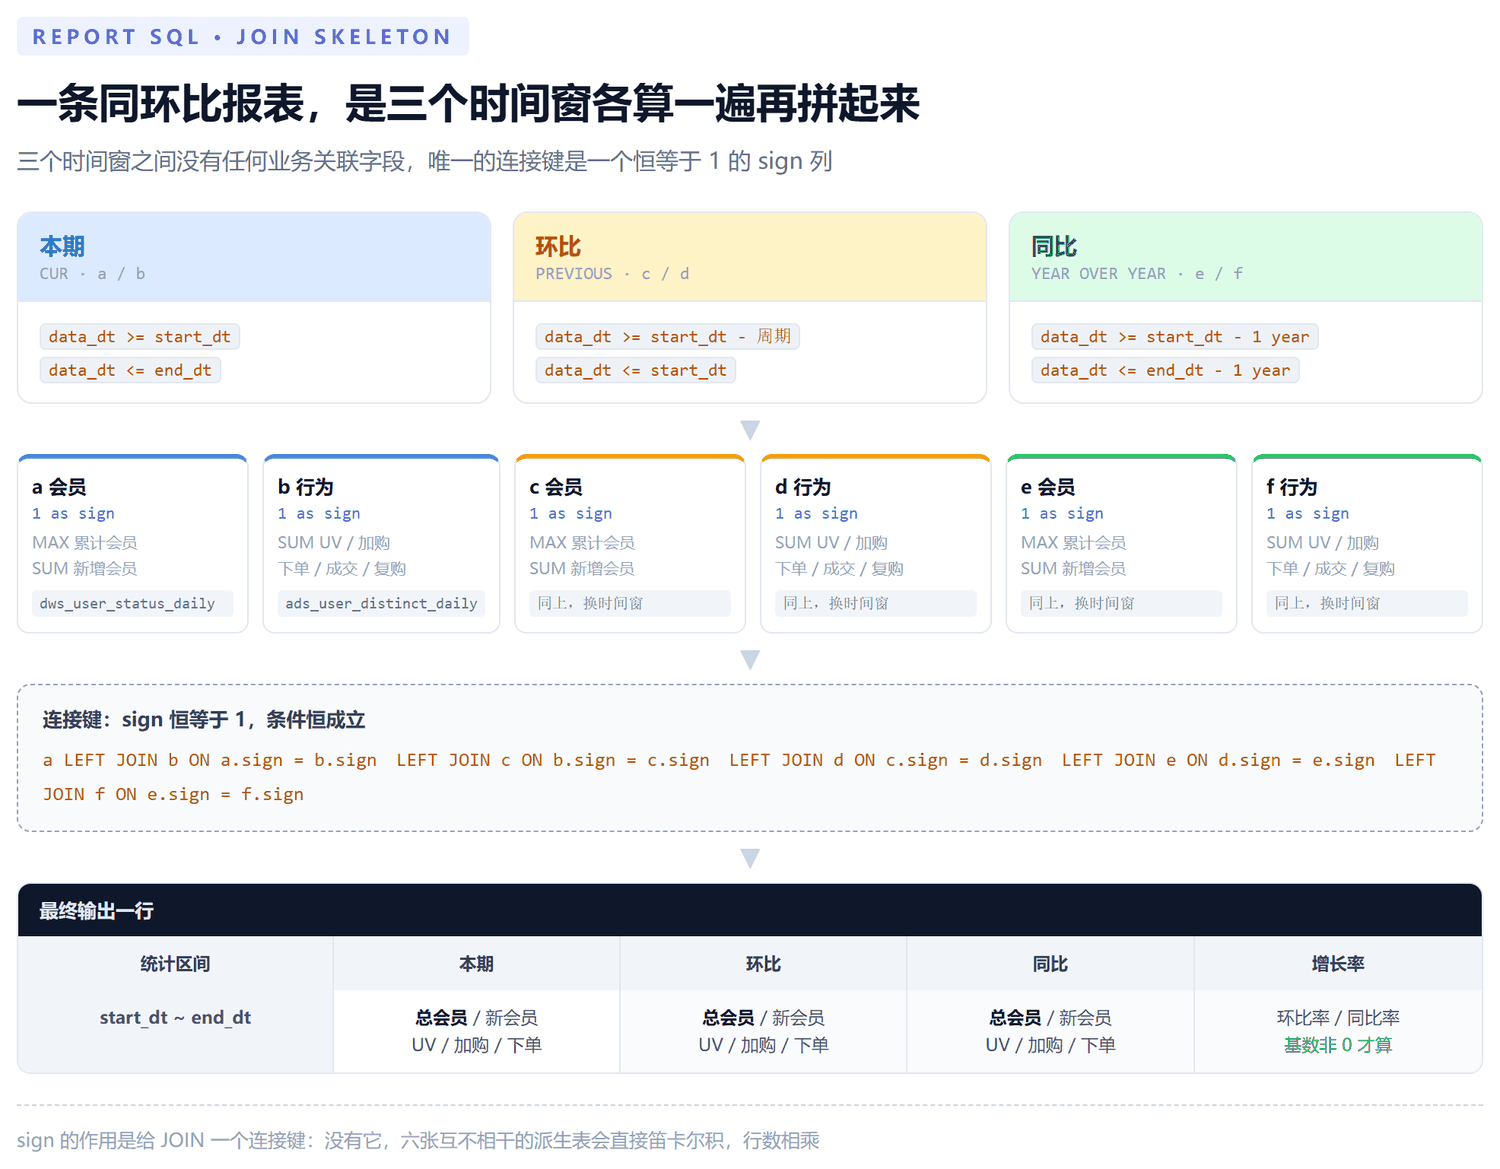
一条同环比报表,本质是三次独立聚合:本期算一次,上一期算一次,去年同期算一次。三次的结果各自是一行多列的宽表,最后要横向拼成一行——本期指标一列、环比指标一列、同比指标一列,再加两列增长率。
难点不在聚合,在于「横向拼接」。三个时间窗的数据之间没有任何业务关联字段可以匹配,纯粹的笛卡尔积又会把行数乘起来。常见的解法是给每个派生表加一列恒等于 1 的常量,再拿它当 JOIN 的连接键。
2. 环比和同比比的到底是什么
两个词经常被混用,差别只在时间窗的取法:
环比(period over period) 和紧挨着的上一期比。日报比昨天,本周比上周,本月比上月。窗口长度和本期一样长,紧贴在本期前面
同比(year over year) 和去年同期比。窗口长度也是一年,但整体往前推一年。日报比去年同一天,本月比去年同月
环比窗口的推导有个容易错的地方:长度要算上头尾两天。本期是 [start_dt, end_dt],闭区间,实际天数是 DATEDIFF(end_dt, start_dt) + 1。上一期就要从 start_dt 往前推同样多的天数:
-- 本期:2026-01-01 到 2026-01-07,一共 7 天
SELECT DATEDIFF('2026-01-07', '2026-01-01') + 1;   -- 7

-- 环比窗口的下界:往前推 7 天
SELECT DATE_SUB('2026-01-01', INTERVAL 7 DAY);     -- 2025-12-25

-- 环比窗口的上界:本期第一天的前一天
SELECT DATE_SUB('2026-01-01', INTERVAL 1 DAY);     -- 2025-12-31
这里有个坑值得单独拎出来:把上界写成 data_dt <= start_dt 的时候,start_dt 这一天同时被算进了本期和环比期,环比窗口凭空多一天,两边的口径就不一样了。环比的上界应该是 start_dt 之前的一天,条件写成 data_dt < start_dt 最省事。
同比窗口简单,把两个端点各推一年:
SELECT DATE_SUB('2026-01-01', INTERVAL 1 year);   -- 2025-01-01
SELECT DATE_SUB('2026-01-07', INTERVAL 1 year); -- 2025-01-07有个边界要留意:2 月 29 日减一年会落到 2 月 28 日,MySQL 不会报错,只是日期对不齐。2024 年是闰年,所以 2026-02-28 减一年得到 2025-02-28,2025-02-28 减一年得到 2024-02-28——如果要严格按「去年同一天」对齐,得自己在应用层处理。
3. 累计值和增量值,聚合方式不一样
同一张表里混着两种口径的指标,聚合方式必须分开,这是报表 SQL 最容易算错的地方:
累计值(快照) 像「总会员数」,每天存的是当天截止的累计值。用
MAX()取,不是SUM()。SUM 会把每天的累计值加起来,变成一个毫无意义的巨大数字
增量值(流水) 像「新会员数」「当天 UV」,每天存的是当天的增量。用SUM()取
SELECT
  IFNULL(MAX(total_user_num), 0)  AS total_user_num,   -- 累计值取 MAX
  IFNULL(SUM(new_add_user_num), 0) AS new_add_user_num  -- 增量值取 SUM
FROM bi.dws_user_status_daily
WHERE is_deleted = 0
  AND company_id = ?
为什么要包一层 IFNULL:没有匹配行时,MAX() 和 SUM() 返回的是 NULL,而 NULL 参与后续的加减乘除会让整个表达式变成 NULL。加了 IFNULL(..., 0) 之后,空数据在报表上显示为 0,而不是一片空白。
注意聚合方式要和下游用法对上。总会员数是「每天的累计快照」,那么环比总会员率算的是两个时点快照的差值占旧值的比例;新会员数是「当天增量」,它的环比率算的是两段区间增量之和的差。两个公式长得一样,含义完全不同。
4. sign 常量:给 JOIN 造一个连接键
官方文档在 JOIN 语法那节写得很直白:没有连接条件时,逗号连接等价于 INNER JOIN,结果是笛卡尔积——第一张表的每一行都配上第二张表的每一行。而报表的三个时间窗,恰恰就是三张互不相干的表。
要横向拼在一行,又不能让行数相乘,就得给 JOIN 一个恒成立的连接条件。字段对不上的时候,造一个常量列是最省事的办法:
SELECT
  IFNULL(MAX(a.total_user_num), 0) AS '总会员',
  IFNULL(MAX(c.total_user_num), 0) AS '环比总会员',
  IFNULL(MAX(e.total_user_num), 0) AS '同比总会员'
FROM ( SELECT 1 AS sign, ... ) AS a
LEFT JOIN ( SELECT 1 AS sign, ... ) AS b ON a.sign = b.sign
LEFT JOIN ( SELECT 1 AS sign, ... ) AS c ON b.sign = c.sign
LEFT JOIN ( SELECT 1 AS sign, ... ) AS d ON c.sign = d.sign
LEFT JOIN ( SELECT 1 AS sign, ... ) AS e ON d.sign = e.sign
LEFT JOIN ( SELECT 1 AS sign, ... ) AS f ON e.sign = f.sign
每个派生表都带一列 1 AS sign,连接条件是 a.sign = b.sign。因为两边都是 1,条件恒成立,每张派生表的唯一一行都能和另一张的唯一一行配上,行数不会翻倍。
这么做本质上是给「一对一的横向拼接」找了个语法上说得通的载体。它能跑通,但可读性并不好——六张派生表、五个 LEFT JOIN、每个 JOIN 都挂一个恒真的条件,看的人要在脑子里还原出「其实只是想横着摆」的意图。
8.0 起有更好的写法:用 CTE 把每张派生表先命名,再 join。语义完全一样,但每张表有了自己的名字,不用再靠 a/b/c/d/e/f 记。
WITH cur  AS ( SELECT 1 AS sign, ... ),   -- 本期会员
     curb AS ( SELECT 1 AS sign, ... ),   -- 本期行为
     prev AS ( SELECT 1 AS sign, ... )    -- 环比会员
SELECT
  IFNULL(MAX(cur.total_user_num), 0)  AS '总会员',
  IFNULL(MAX(prev.total_user_num), 0) AS '环比总会员'
FROM cur
LEFT JOIN curb ON cur.sign = curb.sign
LEFT JOIN prev ON curb.sign = prev.sign
CTE 的写法在 5.7 上用不了(递归 CTE 是 8.0 的新特性),但非递归的 CTE 早就有,MySQL 5.7 就支持 WITH 语法。如果还在 5.7 上跑,上面这个改写照样能上。
5. 增长率:先判分母再算
增长率的公式是 (本期 - 基数) / 基数 * 100,麻烦全在分母。分母为 0 或者为 NULL 的时候,这个式子算不出东西。
IF(
  IFNULL(c.total_user_num, 0) = 0,
  0,
  ROUND( (a.total_user_num - c.total_user_num) / c.total_user_num * 100, 2)
) AS '环比总会员率'
这段写法有讲究,两个地方容易看漏:
判断条件和除法用的不是同一个表达式 判断用的是
IFNULL(c.total_user_num, 0) = 0,而除法用的是原始列c.total_user_num。原始列是 NULL 时判断成立,直接返回 0,不会走到除法那一步
为什么必须显式判,不能靠 IFNULL 兜底 写成ROUND((a.x - c.x) / IFNULL(c.x,0) * 100, 2)的话,分母为 0 时除法返回 NULL,整个结果也是 NULL。报表上这一格是空白,不是 0,含义完全不同
MySQL 的除零行为是返回 NULL 并给一条 warning,不是直接报错。所以就算漏了判断,SQL 也不会挂,报表上只是多了一片空白——这种问题在页面上比报错更难发现。
公式里引用的全是源表的原始列(a.total_user_num、c.total_user_num),不是外层 SELECT 列表里定义的输出别名。这样写的好处是换数据库也能跑:MySQL 允许在 SELECT 列表里引用同一层前面写过的列别名,但那是 MySQL 独有的宽松行为,标准 SQL 和绝大多数数据库都不认。
四舍五入用 ROUND(x, 2)。要是做的是金额而不是百分比,ROUND 和 TRUNCATE 的区别得注意:ROUND 四舍五入,TRUNCATE 直接截断,1.005 这个数两者结果不一样。
6. 折线图要连续日期:造序列的两条路
折线图的横轴是日期,数据库里只有哪天有数据才有哪天。但图上通常要画出连续的一整段——中间没数据的那几天也得占个位置,否则折线会跳过它们,看起来像数据断了。
解决办法是:先造出一张完整的日期序列表,再 LEFT JOIN 到业务数据上,没匹配上的地方补 0。
5.7 时代造序列的常见办法是借一张行数够多的系统表,再配会话变量做自增:
SELECT
  DATE_SUB(CURDATE(), INTERVAL id DAY) AS time
FROM (
  SELECT @s := @s + 1 AS `id`
  FROM ( SELECT @s := -1 ) temp, mysql.help_topic
  WHERE @s < 7
) AS nums;
mysql.help_topic 是 MySQL 系统表 mysql 库里存帮助信息的表,8.0 和当前版本的系统表文档里都还列着它,行数足够当「数字发生器」用。@s 从 -1 开始,每行加 1,条件 @s < 7 停,一共产出 8 行,配合 DATE_SUB 倒着推就得到连续的 8 天。
这写法能用,但有两个隐患:一是依赖会话变量在 SELECT 里的求值顺序,MySQL 并不保证这个顺序;二是 mysql.help_topic 的行数不是稳定契约,不同版本不一样。
8.0 起有标准答案,官方文档给的例子是递归 CTE:
WITH RECURSIVE dates (date) AS
(
  SELECT MIN(date) FROM sales
  UNION ALL
  SELECT date + INTERVAL 1 DAY FROM dates
  WHERE date + INTERVAL 1 DAY <= (SELECT MAX(date) FROM sales)
)
SELECT * FROM dates;
非递归的那一段给出起始日期(表里最小的那天),递归的那一段每次加一天,直到超过表里最大那天。官方文档在递归 CTE 那一节同时给了斐波那契数列和日期序列两个例子,日期序列这个是最常用的。
日期序列接业务数据的时候,连接类型必须是 LEFT JOIN:
WITH RECURSIVE dates (date) AS
(
  SELECT DATE_SUB('2026-01-01', INTERVAL 29 DAY)
  UNION ALL
  SELECT date + INTERVAL 1 DAY FROM dates
  WHERE date + INTERVAL 1 DAY <= '2026-01-30'
)
SELECT
  d.date,
  IFNULL(SUM(s.amount), 0) AS total
FROM dates d
LEFT JOIN sales s ON s.date = d.date
GROUP BY d.date
ORDER BY d.date;
写成 INNER JOIN 的话,没有销售额的那几天直接消失,序列就断了,LEFT JOIN 才会把空日期补成 0。
递归 CTE 有个默认的层数上限:系统变量 cte_max_recursion_depth 默认是 1000。超了会被直接终止,递归没有结束条件的那种写法,几百层就报错了。生成一年 365 天的序列没问题,生成十年就要注意了。
7. 月份桶:把日期对齐到月初
月度报表要把每一天的数据归到它所属的月份,桶的边界得算准。直接用 DATE_FORMAT 取月初是最省事的:
SELECT
  DATE_FORMAT(order_date, '%Y-%m-01') AS month_key,
  SUM(amount) AS total
FROM orders
GROUP BY month_key
ORDER BY month_key;
如果需要「本月」和「上月」两组数据同时在手,就再算一个往前推一个月的起点:
SELECT
  DATE_FORMAT(order_date, '%Y-%m-01')                          AS cur_month,
  DATE_FORMAT(DATE_FORMAT(order_date, '%Y-%m-01'), '%Y-%m-01') AS ignored,
  DATE_SUB(DATE_FORMAT(order_date, '%Y-%m-01'), INTERVAL 1 MONTH) AS prev_month
FROM orders;
这几句里有几个坑值得单独看:
%Y是四位年,%y是两位 写成'%y-%m-01'出来的是26-01-01,拿去当日期用会解析失败
格式串里多一个空格就多一份隐患'%y-%m-%d '末尾那个空格不是排版需要,它会被原样拼进结果里,字符串比较和后续转换都可能出问题
月份差要用INTERVAL 1 MONTH,不是INTERVAL 30 DAY后者会把 3 月 31 日推到 3 月 1 日
桶的结束边界用 LAST_DAY() 最直接:
SELECT
  DATE_FORMAT(order_date, '%Y-%m-01')              AS month_start,
  LAST_DAY(order_date)                             AS month_end,
  SUM(amount)                                      AS total
FROM orders
GROUP BY month_start, month_end;
LAST_DAY() 会跟着月份变化,2 月是 28 还是 29 号它自己判断,不用自己写 IF。
8. 同一个表用不同别名连多次
有些表关系是环状的或者一对多的,同一张表在一条查询里要连好几次。这时候靠别名把每一次连接区分开:
SELECT
  f.ID, f.LOGINNAME, f.ORGNAME, d.NAME AS POSTID
FROM ALONE_AUTH_USER A
LEFT JOIN ALONE_AUTH_USERORG B  ON A.ID = B.USERID
LEFT JOIN ALONE_AUTH_ORGANIZATION A3 ON B.ORGANIZATIONID = A3.ID
LEFT JOIN ALONE_AUTH_USERPOST C ON C.USERID = f.ID
LEFT JOIN ALONE_AUTH_POST D      ON D.ID = C.POSTID
WHERE f.STATE = '1';
这段 SQL 里 ALONE_AUTH_USERORG 连了两次(用户和组织的关联表),ALONE_AUTH_USERPOST 和 ALONE_AUTH_POST 各一次。规则很简单:同一个物理表,每出现一次就给一个新别名,后面的 ON 条件里用别名指代,别混用表名。
连出来的层级是这样的:用户 → 用户组织关联 → 组织,这是主链路;用户 → 用户岗位关联 → 岗位,这是另一条支路。两条支路都从用户出发,粒度不同(一对一还是多对多),行数会不一样。
这种多对多的支路全用 LEFT JOIN 连的时候要留意:一个用户挂了三个岗位,主链路的行就会被复制成三份,聚合之前先想清楚是不是这个效果。不是就要在聚合时用 DISTINCT 或者改成先聚合再连接。
支路连接上还挂了个判断,位置很关键:
LEFT JOIN wts_card G ON G.USERID = f.ID AND G.PAPERID = '4028bf3f...'
WHERE ( G.ID IS NULL OR G.IS_PASSED = '否' )
ON 里的条件是连接条件,决定哪些行能配上;WHERE 里的条件是结果过滤,决定哪些行留下。这里要表达的是「这个用户要么没有卡,要么卡没通过」——用 LEFT JOIN 加上 G.ID IS NULL 判断没匹配上的行,是标准的反连接写法。
如果把 G.IS_PASSED = '否' 直接挪进 WHERE 而不带 OR G.ID IS NULL,LEFT JOIN 就退化成 INNER JOIN 了:没卡的那些用户本来靠 G.ID IS NULL 保留,一加上等值条件,全被过滤掉。带 OR 包起来,NULL 分支才能让左表的行留下来。
9. 动态条件拼接
报表平台的筛选条件是用户可选的,没勾就不该拼进 SQL。很多平台的模板语法长这样:
WHERE is_deleted = 0
  AND company_id = $company_id$
  $if(start_dt)$
    AND data_dt >= $start_dt$
  $else$
  $endif$
  $if(end_dt)$
    AND data_dt <= $end_dt$
  $else$
  $endif$
模板引擎看到 $if(start_dt)$ 就判断变量有没有值,有值就把中间那段拼进去,没有值就跳到 $else$。同一个 AND company_id = ? 是永远拼着的,条件可选的部分用模板包起来。
这种模式在 Java 侧手写的时候,一般会先在 SQL 后面挂一个恒真条件:
SELECT * FROM t WHERE 1 = 1
  AND company_id = ?
  AND status = ?
1 = 1 的作用是给后面每一个条件前面留一个 AND,这样拼接的时候不用管第一个条件是「 WHERE 」还是「 AND 」。它是拼接技巧,不是 SQL 语义的一部分——WHERE 1=1 和 WHERE 1=2 在优化器看来没有任何区别,不会因为它慢。
真正该警惕的是拼接本身。如果条件值是直接拼进 SQL 字符串的,那就是 SQL 注入的口子;参数值一律走占位符(? / $1 / :name),只有条件本身(哪一段 SQL 要不要出现)才由程序决定。
能用 ORM 的 where builder 就用,它把「条件可选」这件事封装成对象拼接,参数始终走绑定变量,注入风险从源头消失。
10. 几条会咬人的细节
字符串用双引号,等于给自己埋雷 默认
sql_mode下双引号是字符串定界符,能跑。但ANSI_QUOTES一开,双引号变成标识符引用,NOT IN ("abc")直接报Unknown column。字符串一律用单引号
NOT IN的列表里有 NULL,整个结果为空x NOT IN (1, 2, NULL)永远不返回行,因为任何值跟 NULL 比较都得不到 TRUE。过滤 ID 列表时先确保列表里没有 NULL
逗号连接和 JOIN 混用会报错 官方文档提醒过:逗号运算符的优先级低于 INNER / CROSS / LEFT JOIN。混着写容易出Unknown column 'xxx' in 'on clause'
一张 SQL 最多关联 61 张表 这是官方文档给的硬上限,包含被合并进外层查询块的派生表和视图。报表 SQL 串六七个派生表很安全,别想着串更多
还有一条不在 SQL 层面、但同样影响报表正确性的:过滤条件里那几个 AND 的顺序。像 is_deleted = 0、company_id = ? 这种能大幅缩小范围的条件,放在最前面。能走索引的话,优化器会自己重排,顺序影响不大;但索引失效的字段参与了运算(比如 DATE(data_dt) = '2026-01-01'),顺序就救不了——那是索引本身选错了,字段类型和查询条件的类型对不上,索引里的有序性直接失效。
💡 补充:报表 SQL 还有一个常见套路是先聚合再连接。很多人在一个大查询里把明细表、维表、流水表全连起来最后再 GROUP BY,中间产生几十亿行中间结果。拆成两步——每张明细表先在自己那层聚合到目标粒度,再把聚合结果连起来——中间数据量会小几个数量级。这条在 MySQL 优化与版本细节 那篇有更完整的清单。
🔥 一句话总结:同环比报表就是三个时间窗各聚合一次、用一个恒等于 1 的常量列横向拼成一行,累计值取 MAX、增量值取 SUM、空值一律 IFNULL 兜成 0;折线图的连续日期用递归 CTE 造序列再 LEFT JOIN 补零,桶边界交给 DATE_FORMAT 和 LAST_DAY;同一张表连多次就换别名,ON 管连接、WHERE 管过滤,混着写就把 LEFT JOIN 变成了 INNER JOIN。