
05-MySQL 优化与版本细节:SQL 优化清单与行为差异
📝 笔记摘要:一份能照着改的 SQL 优化清单,和几个跨版本才会变的行为
同一句 SQL,在 5.7 和 8.0 上跑出来的结果可能不一样;utf8 这个名字在不同版本里指的东西也不同。这篇前半部分是一份能对着改的清单——哪些写法要改,改成什么,理由是什么;后半部分讲三个最容易踩的版本差异:VARCHAR 的长度到底按字符还是按字节、整数类型里那个括号数字是什么、字符串里的单引号该怎么转义。
MySQL 系列 共 5 篇,这是第 5 篇
01 MySQL 基础 类型、建表与查询
02 MySQL 事务、锁与索引 ACID、隔离级别、锁层级与索引失效
03 MySQL 函数专题 CONCAT、CONCAT_WS 与 GROUP_CONCAT
04 MySQL 报表实战 同环比、日期序列与多表连接
05-MySQL 优化与版本细节 优化清单、版本行为差异与转义 ← 本篇
这篇的结构
1. 优化先看执行计划
2. 查询写法的五条硬规矩
3. 前导百分号是反模式
4. 「少用子查询」要打个折
5. 表和索引层面:分库分表什么时候才轮到它
6. 版本差异一:VARCHAR 的长度是字符数
7. 版本差异二:整数类型括号里的数字
8. 版本差异三:字符串里的单引号
9. 版本差异四:JSON 类型
10. 版本差异五:utf8 这个名字
11. 版本差异六:认证插件
12. 版本怎么选
索引的底层结构和失效场景在 MySQL 事务、锁与索引 那篇,这篇不重复讲 B+ 树,只讲怎么用执行计划定位问题。类型怎么选在 MySQL 基础。
1. 优化先看执行计划
凭感觉优化是效率最低的做法。一条 SQL 慢,可能性有好几种:没走索引、走了索引但回表太多、估算的行数偏差大导致优化器选错了连接顺序、排序没利用上索引。这些在 SQL 文本里看不出来,得看执行计划。
EXPLAIN SELECT ...;
EXPLAIN FORMAT=JSON SELECT ...;
EXPLAIN ANALYZE SELECT ...;三者的分工不一样:EXPLAIN 给的是优化器估算的行数和选的计划,FORMAT=JSON 给出更多细节(比如哪个条件用了哪个索引),EXPLAIN ANALYZE 则是真正跑一遍,把实际行数和耗时跟估算值摆在一起对比。
实际行数远大于估算行数,是最有价值的信号:说明统计信息过期了,优化器基于错误的基数选了计划。这时候第一反应应该是 ANALYZE TABLE 更新统计信息,而不是加索引。
估算和实际差得离谱还有个常见原因:列上的统计信息是采样出来的,采样比例默认是 innodb_stats_persistent_sample_pages 控制的那几页。数据倾斜严重的时候(某个状态占了 99% 的行),采样容易失真。这时候可以考虑 ANALYZE TABLE t INDEX FOR COLUMN c 做直方图分析,或者手工调高采样页数。
2. 查询写法的五条硬规矩
SELECT 务必写明字段名,不要
SELECT *理由有三层:一是网络和序列化开销,二是多取出来的列会打断覆盖索引——本来索引里就有的数据,因为要回表才能拿到剩下的列,索引白建了;三是表结构一改,SELECT *的结果集就跟着变,代码里按下标取值的逻辑全乱
只要一条数据就加LIMIT 1注意,LIMIT本身不会让全表扫描变快,服务器照样要把符合条件的行扫出来。但配合ORDER BY时,MySQL 会走「排序后取前 N 条」的路径,扫够就停。写「取最新的一条」一定要ORDER BY id DESC LIMIT 1,光写LIMIT 1拿到的是任意一条
查询条件要能走索引 字段类型和字面量类型对不上,索引的有序性就废了。WHERE create_time = '2026-01-01'能走索引,WHERE DATE(create_time) = '2026-01-01'走不了——索引里存的是原始值,不是函数算出来的值
IN的值不要塞太多 几百个值没问题,多了有两个麻烦:一是 SQL 文本变长,解析开销上升,参数占位符的数量也受max_allowed_packet限制(默认 64 MB);二是优化器可能放弃常量查找改成别的策略,plans 反而变差。真要传几千个 ID,改成 JOIN 一张临时表
排序要有对应的索引ORDER BY的字段顺序和索引顺序一致时,MySQL 直接顺着索引读,不用额外排序(有Using filesort就是没走上的信号)
这几条里,ORDER BY 那条还有个常被忽略的细节:排序字段上建了索引,但查询条件把它截断了,索引依然用不上。联合索引 (a, b, c) 上,WHERE a = 1 ORDER BY b, c 能用,WHERE b = 1 ORDER BY c 用不了——因为跳过了最左边的 a,b 的有序性已经断了。
3. 前导百分号是反模式
模糊查询要分两种情况看,结论完全相反。
-- 前缀匹配:能用上索引
SELECT * FROM t WHERE name LIKE '张%';

-- 前导百分号:索引直接失效
SELECT * FROM t WHERE name LIKE '%三';
B+ 树索引是按值排序存的,name LIKE '张%' 相当于一个范围查询,MySQL 能定位到「张」开头的连续区间。LIKE '%三' 里的开头是通配符,等于说「所有以三结尾的」,没有任何一个前缀可以定位,只能一张表一张表扫。
所以「建议使用 % 前缀模糊查询」是反的。正确的说法是:不要用前导 %。真要支持任意位置的模糊搜索,有三条路:
改业务需求 搜索框拆成几个字段,用户选「姓名」「手机号」「订单号」,各自走前缀匹配。绝大多数搜索场景根本不需要后缀模糊
用全文索引 InnoDB 从 5.6 起支持FULLTEXT索引,中文要配 ngram 解析器:WITH PARSER ngram。它建的是倒排索引,能处理词中间出现的情况,但索引体积大,LIKE语法也用不上,得用MATCH ... AGAINST
上独立搜索引擎 ES / OpenSearch 之类的,MySQL 只留一份主键做同步。数据量大、搜索要求高的时候这条路最干净
还有一个折中方案:反转存储。需要在末尾查找的时候,把字段值反过来存一份专用的列,然后对这列做前缀匹配。字段名结尾固定的那类需求(比如按手机号后四位查)很适合这个办法。
4. 「少用子查询」要打个折
「少用子查询和嵌套查询」这条规矩在 5.7 时代基本成立,8.0 之后要打个折。
5.7 的优化器处理 IN 子查询的能力有限,遇到 WHERE id IN (SELECT ...) 经常退化成「对每一行去执行一次子查询」。8.0 引入了 semi-join 改写,优化器能把这类子查询改写成一次连接,执行计划和手写 JOIN 几乎一样。
-- 8.0 上这两种写法,优化器通常会改写成同一种计划
SELECT * FROM orders WHERE user_id IN (SELECT id FROM vip_users);
SELECT * FROM orders o JOIN vip_users v ON o.user_id = v.id;真正该警惕的是相关子查询——子查询里引用了外层的列:
-- 外层每一行都要跑一次子查询
SELECT o.id, (SELECT COUNT(*) FROM items i WHERE i.order_id = o.id) AS cnt
FROM orders o;
这种写法在数据量大时是灾难。改法是拆成两步,或者用 JOIN 加 GROUP BY:
SELECT o.id, IFNULL(COUNT(i.id), 0) AS cnt
FROM orders o
LEFT JOIN items i ON i.order_id = o.id
GROUP BY o.id;再补一条:别用子查询做循环里的单行查询。那已经不是 SQL 优化的问题了,是应用层发起了 N 次网络往返。批量查出来在内存里配对,差距是数量级的。
5. 表和索引层面:分库分表什么时候才轮到它
分库分表是最后手段,不是优化手段。走到这一步之前,下面这些都该做完:
索引建对了 缺索引、索引顺序不对、索引列上套了函数,这些是收益最大、改动最小的优化
SQL 写法收敛了SELECT *、前导 %、N+1 查询、无 LIMIT 的全表拉取
表结构瘦身了 大字段拆到副表,冷热数据分表,历史数据归档。这三招能把单表压下去一大截,而且不用改架构
读写分离了 读多写少的话,一主多从是最省事的横向扩展
做完上面这些还扛不住,再考虑拆表。拆的时候有三个点要想清楚:
分片键的选择决定了后面所有的麻烦程度。按用户 ID 分,用户的订单都在一个分片上,查询简单;但如果业务有「按商家查订单」的需求,这个商家散落在所有分片上,就成了全分片查询。反过来按商家分,用户看自己的订单就要扫全部分片。选分片键的原则是:绝大多数查询能带上它。
跨分片的事务和聚合是硬骨头。分片之后,「转账」这种跨两个用户的操作没法用本地事务,只能靠最终一致性或者补偿。分片键选得对,这类操作就会少很多。
MySQL 自带的分区表是个更轻的选项。按时间做 RANGE 分区,老数据可以直接 DROP PARTITION 掉,不用搬数据。缺点是分区键必须包含在所有唯一索引里,用起来限制不少。数据量在千万级、时间维度清晰的话,先试分区表往往比直接上分库分表划算。
索引数量这件事常被带偏:索引不是越多越好。每个索引都会占空间,而且每次 INSERT / UPDATE / DELETE 都要维护。一个表十几个索引,写入性能会明显掉。判断标准很简单:这个索引有没有被某条真实查询用上,用不上的就是纯负担。
6. 版本差异一:VARCHAR 的长度是字符数
VARCHAR(100) 里的 100 是什么单位,这是最常被记错的一个点。官方文档写得很明确:M represents the maximum column length in characters——是字符数,不是字节数。
-- utf8mb4,一个汉字占 4 字节
CREATE TABLE t (name VARCHAR(100)) CHARSET=utf8mb4;
-- 这个字段能存 100 个汉字,存不下 emoji 之外的第 101 个字更早的版本是按字节算的。5.0.3 之前,VARCHAR(100) 在 utf8 下最多存 33 个汉字(一个汉字 3 字节),5.0.3 之后改成按字符算,才能存满 100 个。从 5.0.3 到今天,这条规则一直没变。
但字符数只是声明,实际能存多长还受两个限制:
一行的总长度上限是 65,535 字节,全表所有列共享 所以
VARCHAR的最大声明长度是 65,535,但实际值受行大小限制。官方文档给 utf8mb3 的例子:一个 utf8mb3 的VARCHAR列最多能声明 21,844 个字符,因为 65,535 字节除以 3
utf8mb4 下单个字符最多 4 字节 所以 utf8mb4 的VARCHAR声明长度上限是 16,383(65,535 除以 4)
存储上 VARCHAR 前面还有一个长度前缀:内容不超过 255 字节用 1 个字节记长度,可能超过就用 2 个字节。这点在做行大小估算时别忘了。
7. 版本差异二:整数类型括号里的数字
INT(11)、BIGINT(20) 这类写法里的括号数字,不是取值范围,也不是存储字节数,它只是显示宽度——配合 ZEROFILL 用来补零显示,比如 INT(5) ZEROFILL 存 42 会显示成 00042。
取值范围跟括号里的数字一点关系都没有:INT 永远是 32 位有符号,范围 -2147483648 到 2147483647;INT UNSIGNED 是 0 到 4294967295。
8.0 版的 What Is New 文档里写明:ZEROFILL 属性和整数类型的显示宽度属性都已废弃。官方给的替代方案是:用 LPAD() 函数补零,或者把格式化后的数字存进 CHAR 列。
-- 8.0.17 之前
CREATE TABLE t (id INT(11) ZEROFILL);
-- 8.0.17 之后
CREATE TABLE t (id INT);

-- 显示层面的补零,交给应用或 LPAD
SELECT LPAD(id, 5, '0') FROM t;
新写 DDL 直接省略括号就行。存量表里的 INT(11) 留着也没问题,它不影响任何行为,只是文档里那一条废弃提示。
8. 版本差异三:字符串里的单引号
SQL 字符串用单引号包,字符串里面又有单引号时,就得处理。MySQL 给的规则在官方文档的「Special Character Escape Sequences」那节:除非开启 NO_BACKSLASH_ESCAPES,否则反斜杠是转义字符。
-- 方式一:反斜杠转义(默认 sql_mode 下可用)
SELECT 'It\'s';

-- 方式二:把单引号写成两个(任何 sql_mode 下都可用)
SELECT 'It''s';
两种方式的差别在于 NO_BACKSLASH_ESCAPES:
默认情况 反斜杠是转义字符,
'It\'s'能解析出It's。同时反斜杠后面跟不属于转义序列的字符时,反斜杠会被直接忽略——'\x'解析出来就是x,不是\x。而且转义序列区分大小写:\b是退格符,\B就是字母 B
开了NO_BACKSLASH_ESCAPES反斜杠变成普通字符,'It\'s'解析不了,会在反斜杠那里截断报错。这时候只能用重复单引号
这带来一个实际的风险:同一段代码在生产库能跑,换个环境就炸。有些运维会给 MySQL 加 NO_BACKSLASH_ESCAPES 来防注入,代码里的反斜杠转义就全废了。
正确做法是根本不转义。所有主流数据库驱动都支持参数化查询,值走绑定变量,SQL 文本里根本不出现用户数据:
-- Python
cursor.execute("SELECT * FROM t WHERE name = %s", (name,))

-- Java
stmt = conn.prepareStatement("SELECT * FROM t WHERE name = ?");
stmt.setString(1, name);
参数化之后,引号、百分号、反斜杠、emoji 都是普通字符串,数据库不需要做任何转义判断。拼接 SQL 是注入的根源,也是转义出错的根源——一次都不该做。
9. 版本差异四:JSON 类型
5.7 GA 起有原生 JSON 类型。在此之前想把 JSON 存进 MySQL,只能用 TEXT 装字符串,查询的时候全靠应用层解析,或者用 JSON_EXTRACT 在文本上硬抠。
CREATE TABLE orders (
  id      INT PRIMARY KEY,
  payload JSON
);

-- 存进去自动校验格式,非法 JSON 直接报错
INSERT INTO orders VALUES (1, '{"user": {"id": 100, "name": "李四"}}');

-- 取值:-> 返回 JSON,->> 返回去引号的字符串
SELECT payload->>'$.user.name' AS user_name FROM orders;
两个细节值得注意:
->和->>的区别->返回的是 JSON 类型(带引号),->>返回的是解包后的字符串(不带引号)。想要一个能直接跟字符串比较的值,用->>
JSON 列不能直接建普通索引 它跟其他二进制类型一样,不能直接索引。官方给的两种办法是:建一个生成列把标量值抽出来再对生成列建索引;或者用 多值索引——8.0.17 起 InnoDB 才支持给 JSON 数组建多值索引
多值索引的写法:
CREATE TABLE t (
  j JSON,
  KEY idx_j (CAST(j->'$.tags' AS CHAR(64) ARRAY))
);
这样查 WHERE JSON_CONTAINS(j->'$.tags', '"a"') 就能用上索引了。在 8.0.17 之前没这个能力,只能靠生成列。
要不要用原生 JSON 类型,取决于数据形态:结构固定、需要频繁按字段查询的时候,拆成普通列建索引永远更快;结构多变、以整体存取为主的时候,JSON 类型才划算。把 JSON 当什么都能塞的垃圾桶,是另一个常见坑——JSON 列没法有效建索引,查询全靠扫。
10. 版本差异五:utf8 这个名字
utf8 是 MySQL 里最著名的历史包袱。它不是真正的 UTF-8,是 utf8mb3 的别名——最多三个字节,存不了 emoji 和部分生僻字。
官方文档的态度已经很明确:
utf8mb3 已被标记为废弃 文档原文是「The utf8mb3 character set is deprecated」,并且写了「Expect utf8mb3 to be removed in a future major release of MySQL」
推荐字符集是 utf8mb4 文档原文:「All new applications should use utf8mb4」
8.0 起 SHOW 和 INFORMATION_SCHEMA 里显示的是 utf8mb3 你敲utf8,回显给你的是utf8mb3,这能提醒你它到底是什么
26.7 提供了缓冲带:新增了一个 sql_mode 值 INTERPRET_UTF8_AS_UTF8MB4,打开之后,utf8 这个名字按四字节的 utf8mb4 来解释。默认是关的,属于过渡期工具。存量库要改字符集是件麻烦事(要改列类型、重建索引、校验数据),所以官方建议是:新库一律 utf8mb4,老库有计划地迁。
-- 新建库:新名字,没有歧义
CREATE DATABASE app CHARACTER SET utf8mb4 COLLATE utf8mb4_0900_ai_ci;

-- 存量库过渡:临时按四字节解释
SET SESSION sql_mode = 'INTERPRET_UTF8_AS_UTF8MB4';排查老库问题的时候,第一个要确认的就是这个库、表、列的字符集到底是不是 utf8mb4。中文乱码、九成是字符集在建表时和应用侧对不上。
11. 版本差异六:认证插件
MySQL 8.0 换掉了默认的认证方式:默认插件从 mysql_native_password 变成了 caching_sha2_password。这个名字听着像内部实现,对外的行为区别却是实实在在的——老版本的客户端不认识新插件,握手阶段就失败。
官方在 8.0 的 What's New 里给了两个应对方式:客户端升级,或者服务端加载 caching_sha2_password 插件同时把 mysql_native_password 也开着,两个插件并存。新客户端连老服务端时就是这么协商的。
再往后就是硬切换:
8.4.0 起,
mysql_native_password默认禁用 要继续用得在启动参数里显式打开这个开关。官方文档给出的命令行格式是--mysql-native-password[={OFF|ON}],方括号里的值可以省略,单独写就是打开
9.0.0 起,mysql_native_password彻底移除 插件不存在了,没有开关能打开
客户端这边也要跟上:mysql_native_password 的认证流程在 libmysqlclient 里已经废弃,客户端库太老的话,握手报文都解析不了。升级路径是先升客户端库,再升服务端,反过来做会在第一步就卡住。
12. 版本怎么选
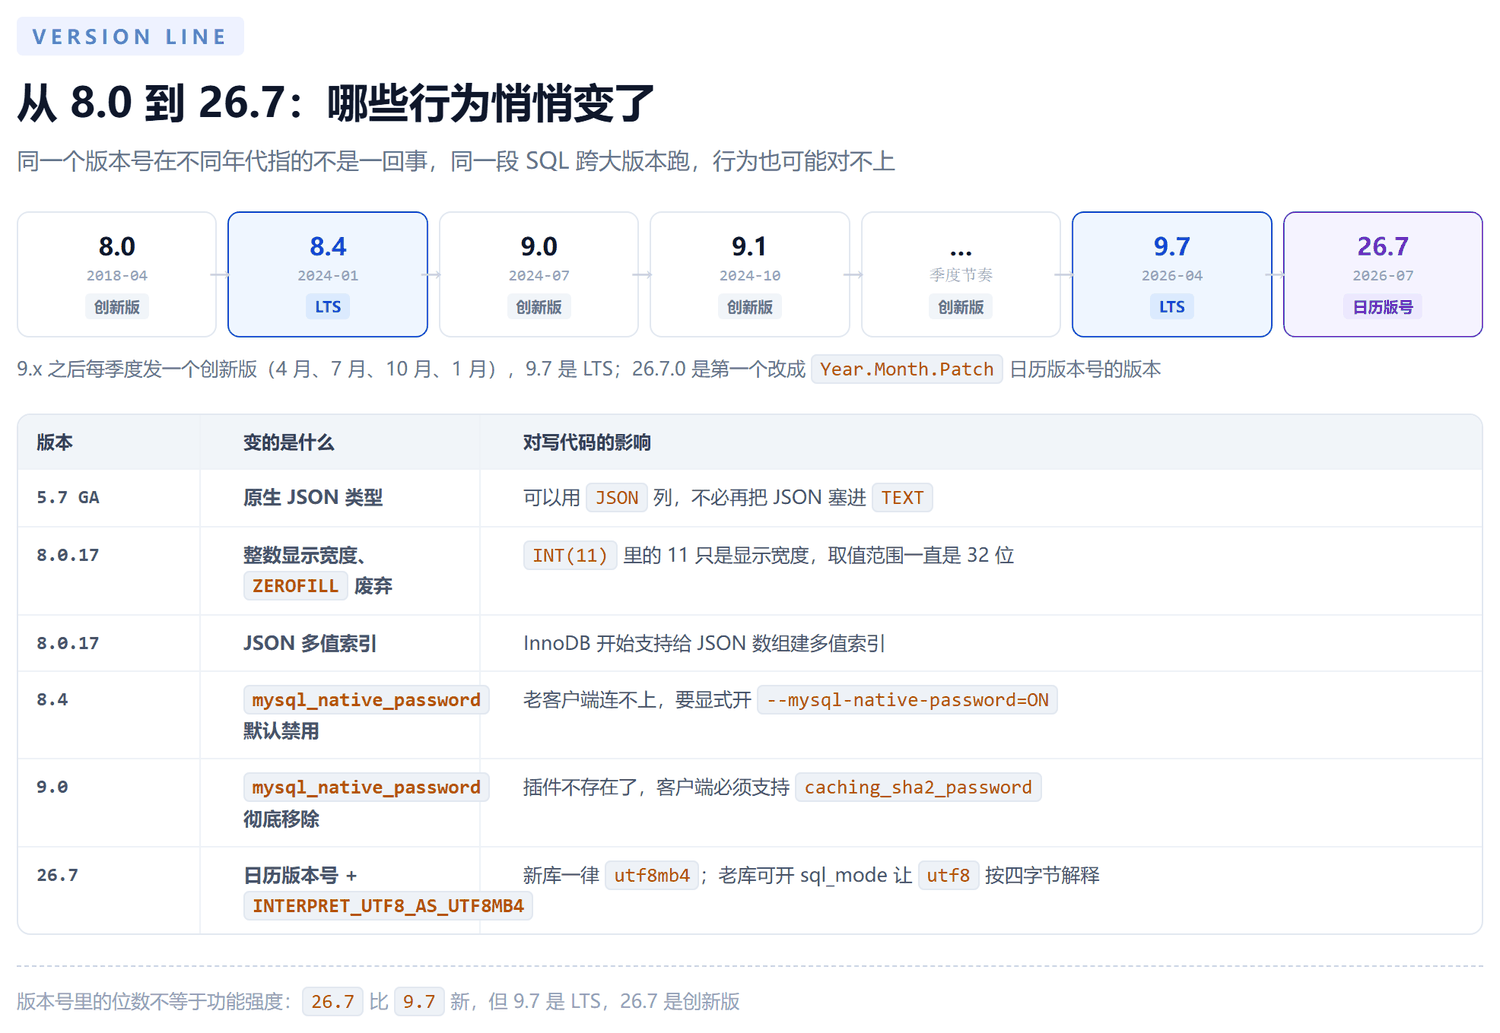
9.x 之后是季度创新版的节奏:4 月、7 月、10 月、1 月各发一个,每个只加新功能,小版本号累加。9.7 是 LTS,走 LTS 系列的维护节奏。
然后版本号改了规则。26.7.0 的发布说明里有一段标了「Important Change」:
MySQL Server now uses calendar-based versioning for releases after the
9.7 LTS series. Version values use Year.Month.Patch (YY.M.P) format.
MySQL 26.7.0 is the first such calendar-version release.翻译过来就是:9.7 LTS 之后改用日历版本号,格式是年.月.补丁,26.7.0 是第一个。以后就是 26.10、27.1、27.4 这样往下走,不再是 9.x 的小版本累加。
选版本的时候,判断依据是要什么而不是要新:
生产环境选 LTS 9.7 是当前的 LTS。它有长期的功能冻结和 bug 修复,第三方工具和驱动的兼容性验证也更充分
要用新特性就上创新版 创新版的功能领先,但 API 和行为还可能变,适合先在测试环境跑一段时间
版本号的大小不代表功能的强弱 26.7 比 9.7 新,但 26.7 是创新版、9.7 是 LTS,两条线的支持周期完全不同
升级路径本身也是有讲究的:不要跨大版本跳。5.7 到 8.0、8.0 到 8.4、8.4 到 9.0,一步一步走,每一步都有官方支持的升级检查工具(mysql_upgrade 工具在 8.4 已经被移除了,改用 mysql_tzinfo_to_sql 那套新工具链处理升级前检查)。跨版本直跳的失败原因,绝大多数不是 SQL 不兼容,是数据字典和表空间格式的转换,而这部分只有逐版本走才有保证。
💡 补充:sql_mode 是一组开关,MySQL 5.7.5 起默认是 ONLY_FULL_GROUP_BY, STRICT_TRANS_TABLES, NO_ZERO_IN_DATE, NO_ZERO_DATE, ERROR_FOR_DIVISION_BY_ZERO, NO_ENGINE_SUBSTITUTION。其中 ONLY_FULL_GROUP_BY 会让「SELECT 列表里没在 GROUP BY 出现的非聚合列」直接报错——这正是 5.7 升级到 8.0 时最常见的一批报错来源。老代码要么把列加进 GROUP BY,要么用 ANY_VALUE() 显式声明「这一列取任意一个值就行」。NO_AUTO_CREATE_USER 这个模式在 8.0.11 已经被移除,8.0.11 同时移除的还有 GRANT 直接建用户的写法和 DB2、MAXDB、MSSQL、ORACLE、POSTGRESQL 这几个兼容模式。升级前拿 SELECT @@sql_mode 对一遍,能省掉后面很多调试时间。
🔥 一句话总结:优化先看 EXPLAIN ANALYZE,查询写法守住写明字段、LIMIT 配 ORDER BY、条件能走索引、IN 别太长、排序有索引这几条,前导 % 是反模式,子查询在 8.0 上多数能被改写不用怕,真正要躲的是相关子查询;版本差异集中在四个地方——VARCHAR 的长度按字符算(5.0.3 之前按字节)、INT(11) 里的 11 只是显示宽度且已在 8.0.17 废弃、引号用参数化代替转义、utf8 实际是已废弃的 utf8mb3;生产上选 LTS,9.7 是当前的 LTS,9.7 之后版本号改成了日历格式。