
04-Redis 缓存实战:穿透击穿雪崩、双写一致与分布式锁
📝 笔记摘要:Redis 做缓存时的穿透击穿雪崩、数据一致性与分布式锁
把 Redis 挂在数据库前面,难点全在「缓存和数据库对不上」的时候。这篇讲三类经典故障的根因和各自的对策,写和读两条路径上的一致性怎么保证,以及分布式锁和限流怎么用 Redis 落地。
Redis 系列 共 4 篇,这是第 4 篇
01 Redis 核心 数据结构、持久化与内存治理
02 Redis 部署与高可用 容器化部署、主从复制、哨兵切换
03 Spring Boot 整合 Redis 连接配置、序列化、工具类
04-Redis 缓存实战 穿透击穿雪崩、双写一致、分布式锁 ← 本篇
这篇的结构
1. 缓存的读写路径
2. 缓存穿透
3. 缓存击穿
4. 缓存雪崩
5. 双写一致性
6. 分布式锁
7. 限流
8. 这套方案挡不住什么
1. 缓存的读写路径
先明确一件事:缓存不是数据的副本,是数据库前面的一层加速器。它存的是「最近被算过的那一份」,随时可以被清掉重建。
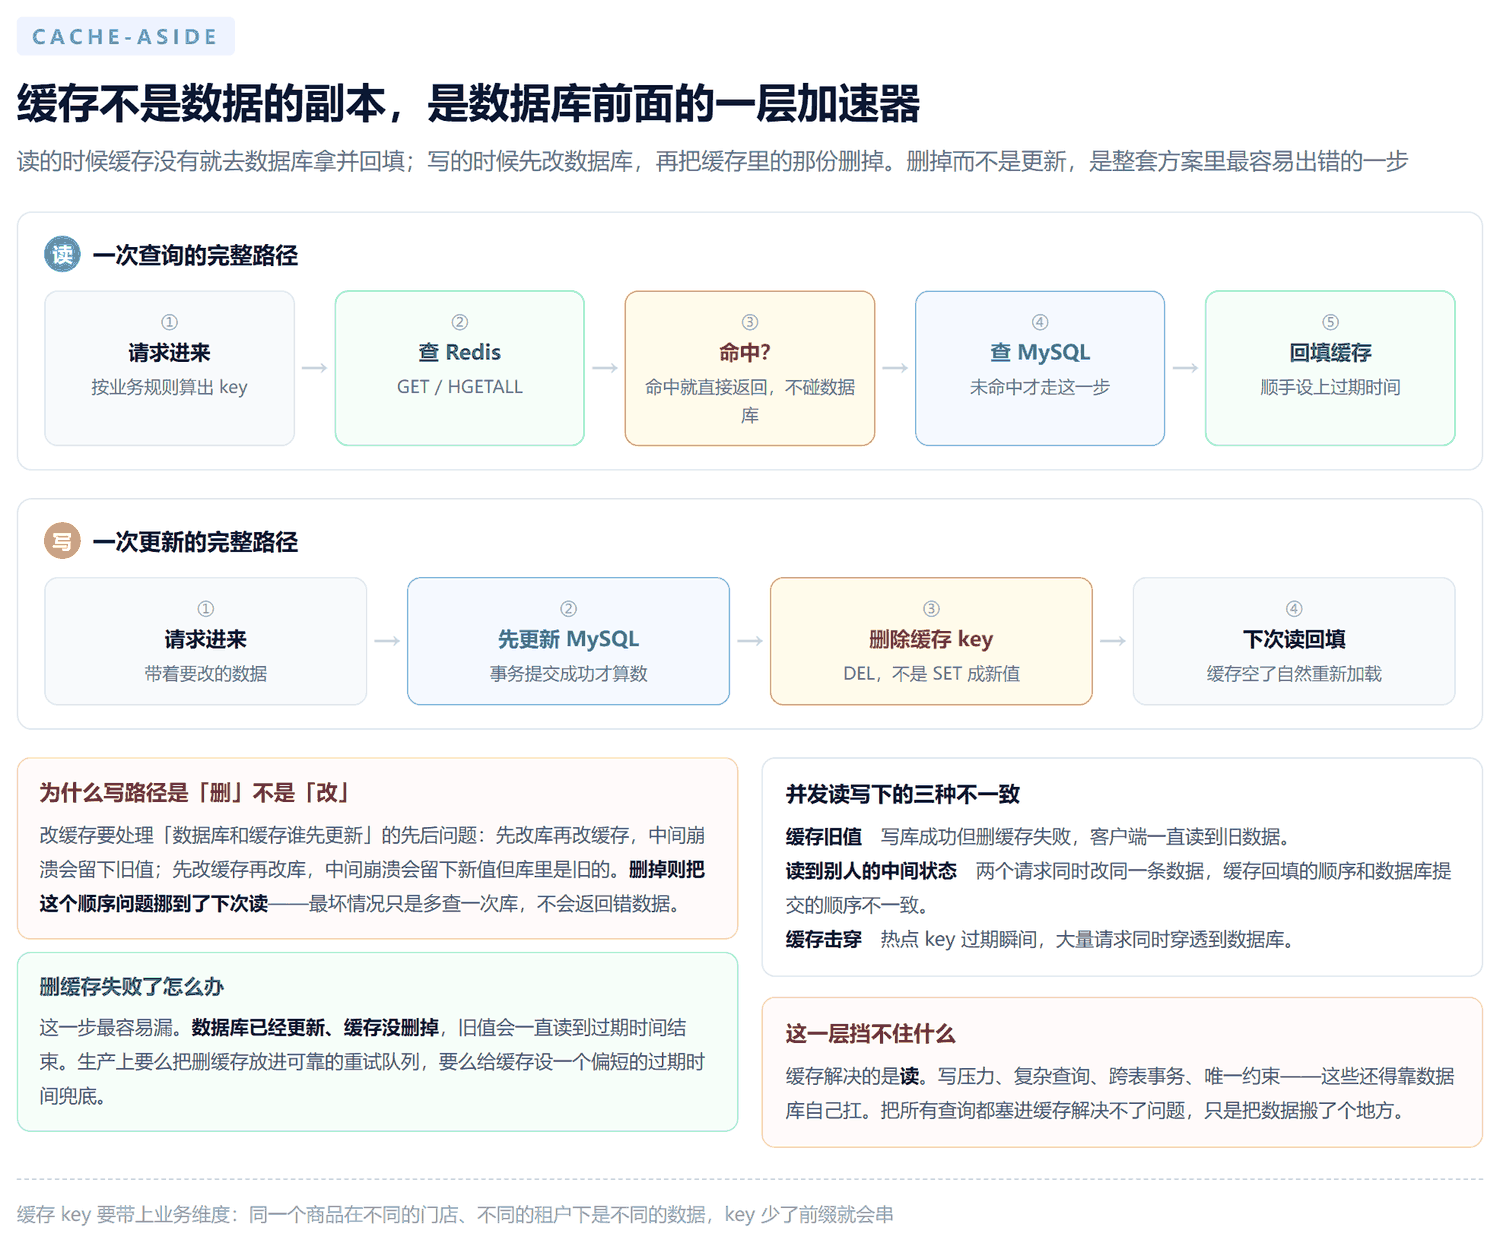
读 算好 key → 查 Redis → 命中直接返回 → 没命中查数据库 → 顺手回填并设过期时间
写 先更新数据库,提交成功后再删掉缓存 key。删掉之后,下次读自然重新加载
为什么是删不是改 改缓存要处理「库和缓存在哪边先更新」的先后问题,中间崩溃会留下不一致的值。删掉则把这个问题挪到下次读——最坏情况只是多查一次库,不会返回错数据
Spring Boot 侧的具体接法在 Spring Boot 整合 Redis 那篇,这里只讲策略。
2. 缓存穿透
查一个根本不存在的数据。Redis 里没有,数据库里也没有。请求每次都穿过缓存直接打到数据库。
典型场景 攻击者用不存在的 ID 疯狂刷接口;或者用户输入了一个从未存在过的查询条件
后果 正常流量被这部分请求吃掉,数据库连接池耗尽,整个服务垮掉——但看 Redis 的命中率一切正常,很难第一时间联想到缓存
特征 缓存和数据库都没命中,而且请求的 key 高度重复
三个对策,通常一起用:
参数校验 明显非法的输入(ID 是负数、格式就不对)在进缓存之前直接挡掉。成本最低,但挡不住「格式合法但不存在」的请求
布隆过滤器 把数据库里已存在的 key 预先放进去,查询时先问过滤器:说不在,就一定不在,直接返回,不碰数据库
空值缓存 查不到也往 Redis 里写一个空标记,给个很短的 TTL(比如 60 秒)。第二次同样的请求就不会再打数据库了
布隆过滤器的原理是用空间换准确率:一个位数组加多个哈希函数。插入时把每个哈希算出的位置置 1,查询时只要有一位是 0 就一定不存在;全是 1 只能说「可能存在」。
Redis 8.0 起可以直接用 当年要另装的 Bloom 模块已经并进核心,命令是
BF.RESERVE、BF.ADD、BF.EXISTS、BF.MADD。不用自己实现
不能删 位数组一旦建好就不能删单个 key,删了会影响其他 key 的判断。数据有增删的话,定期重建整个过滤器
误判率可调 建的时候指定误判率(BF.RESERVE key 0.01表示千分之一),内存用量和误判率直接挂钩
空值缓存有两个坑:TTL 不能太长(否则新数据插入后读到的还是空值),也不能太短(等于没挡)。另外空值的 key 要和正常 key 区分开,别用同一个前缀。
3. 缓存击穿
和穿透不一样:这个 key 是真实存在、非常热门的,只是刚好过期了。比如秒杀活动的主商品。
成因 热点 key 的 TTL 到期的瞬间,缓存里没有它,成千上万个请求同时穿透到数据库
放大条件 重建缓存的动作很慢(一次复杂计算、一次远程调用),空挡期越长冲进来的请求越多
和穿透的区别 穿透查的是不存在的 key,击穿查的是存在但刚过期的 key。区分清楚,对策完全不同
两个对策:
互斥锁 用分布式锁保证同一时刻只有一个线程去重建缓存,其他线程要么等、要么直接返回旧值。锁的粒度是那个热点 key
逻辑过期 不设真正的 TTL,把过期时间写在值里。读到发现逻辑上过期了,直接返回旧值,同时在后台起一个线程去重建。读永远不阻塞,代价是可能返回一点点旧数据
逻辑过期的代价很明确:数据可能不是最新的。商品价格、库存这类场景能接受,余额、库存扣减就不能接受。选哪个看业务对一致性的容忍度。
4. 缓存雪崩
大量 key 在同一时刻集中失效,或者 Redis 整个挂了。结果是一瞬间所有请求穿透到数据库。
成因一:TTL 设得太整齐 批量写入时 TTL 都是同一个值,就会同时到期。这是自己埋的雷
成因二:Redis 实例宕机 整个缓存层没了,所有流量直接压到数据库
区别 击穿是一个热点 key,雪崩是大面积的
对策:
过期时间加随机扰动 TTL 落库时加一个随机偏移,比如 30 分钟加 0 到 10 分钟的随机数。几十万 key 的到期时间就散开了
多级缓存 本地缓存挡一层,Redis 挡一层。Redis 挂的时候本地缓存还能顶一阵
Redis 自身高可用 主从 + 哨兵,节点挂了自动切换。部署与高可用 那篇讲的就是这套
服务降级 缓存不可用时直接返回兜底数据或者友好提示,而不是让请求全部压到数据库。这一条比前面几条都重要
5. 双写一致性
数据库和缓存是两套存储,更新的时候必然会有一瞬间它们对不上。问题是这一瞬间能有多长,以及出错时怎么兜底。
先更新库再删缓存 这是标准做法。中间崩溃的最坏结果是缓存里留着旧值,直到它自己过期——数据错了,但下次读会自我修复
先删缓存再更新库 更糟。中间崩溃的话,缓存已经被删了、数据库还是旧值,下次读会把旧值重新加载进缓存并长期保留
直接更新缓存 要处理「库和缓存在哪边先更新」的先后问题,而且缓存写失败时数据库已经改了,没法回滚
所以是先更新数据库,提交成功后再删缓存。但这还留了两个尾巴:
尾巴一:删缓存失败 数据库更新成功了,删除没成功,旧值一直留着。要么把删除放进可靠的重试队列,要么配一个消息订阅机制
尾巴二:并发读写 两个请求同时改同一条数据,一个先删缓存、另一个后删,中间的窗口里可能把旧值又加载回去了
第二个尾巴的解法叫延迟双删:更新库之后先删一次缓存,等一个业务能接受的时间(比如 500 毫秒)再删一次。第二次删除是为了清掉「并发请求在窗口期内把旧值重新回填」造成的那份脏数据。
提示:延迟双删的延迟时间没有理论值,要大于一次数据库读加上回填缓存的总耗时,靠压测估。估小了等于没做。
更彻底的做法是订阅数据库的变更日志:用 Canal 或 Debezium 监听 binlog,拿到变更事件后去删对应的缓存 key。这样业务代码只管写数据库,缓存的失效由旁路进程负责,业务代码不再需要关心缓存。代价是多一个组件和一个延迟。
无论用哪种方式,都得有一条兜底:给缓存设过期时间。最坏情况下缓存里的旧值会一直错到过期为止,过期时间就是你能接受的最大不一致窗口。
6. 分布式锁
缓存重建、扣减库存、定时任务抢执行权,这些场景都需要一把跨进程的锁。Redis 是最常见的实现方式,因为它够快、而且带 TTL 能自动释放。
正确姿势是一条命令搞定加锁:
SET lock:order:1001 <唯一标识> NX PX 30000NX 只在键不存在时设置。键已存在就返回 nil,表示没抢到锁
PX 毫秒 设置过期时间。抢到锁的进程如果崩了、没来得及释放,锁会在 30 秒后自动过期
唯一标识 一个随机 UUID。必须有它,原因见下面释放那一段
提示:不要用
SETNX加EXPIRE两条命令。中间崩了或者网络抖了,锁就变成了一个永不过期的死锁,所有后来的请求全部卡住。SET key val NX PX是一条原子命令,不存在这个窗口。
释放锁同样有坑。直接 DEL 会误删别人的锁:自己的锁已经超时自动释放了,别的进程拿到了锁,这时你再 DEL 就把人家的锁删了。正确做法是比对标识再删,而且这个比对和删除必须原子:
-- 释放锁的 Lua 脚本
if redis.call("get", KEYS[1]) == ARGV[1] then
    return redis.call("del", KEYS[1])
else
    return 0
end
# 调用方式
redis-cli EVAL "if redis.call('get', KEYS[1]) == ARGV[1] then return redis.call('del', KEYS[1]) else return 0 end" 1 lock:order:1001 <你的唯一标识>为什么必须用 Lua 「先 GET 再判断再 DEL」这三步在 Redis 客户端看来是三条命令,中间可能插进别的请求。Lua 脚本在 Redis 里是整段原子执行的,执行期间不会有别的命令插进来
锁的三个工程细节:
TTL 要大于业务耗时 锁过期了业务还没做完,锁就失效了,别人能进来同时改。业务时间不好估就留足余量
加锁失败要怎么办 抢不到锁就重试(带退避)或者直接返回「处理中,请稍后」。无脑无限重试会把客户端线程池打满
业务异常要释放 try-finally 保证释放。靠 TTL 兜底只是最后一道保险
Redisson 把这套封装好了,自带看门狗:任务没结束时会自动给锁续期,任务卡住或者进程崩溃时停止续期,锁自然过期。用它比手写省心得多:
<dependency>
    <groupId>org.redisson</groupId>
    <artifactId>redisson-spring-boot-starter</artifactId>
</dependency>
RLock lock = redissonClient.getLock("lock:order:1001");
try {
// 拿不到锁就等,默认 30 秒,每 10 秒续期一次
if (lock.tryLock(30, TimeUnit.SECONDS)) {
// 临界区
}
} finally {
// 只有拿到锁才释放
if (lock.isHeldByCurrentThread()) {
lock.unlock();
}
}提示:
unlock()之前一定要判断isHeldByCurrentThread()。没拿到锁还去解锁会抛 IllegalMonitorStateException,而这个异常往往出现在 finally 里,会把真正的业务异常盖掉。
7. 限流
限流的语义是「某段时间内访问次数不能超过规定值」。Redis 做限流的好处是天然分布式,多个实例共享一份计数。
固定窗口计数器 最简单。
INCR加一,超阈值就拒绝,再给键设个 TTL。问题是临界点:窗口末尾的一批请求和下一个窗口开头的一批请求叠起来,实际通过量是阈值的两倍
滑动窗口 用 ZSet 存每个请求的时间戳,统计窗口内的条数。精确,代价是每次请求都要 ZADD + ZRANGEBYSCORE + ZREMRANGEBYSCORE,数据量大时开销明显
令牌桶 桶按固定速率生成令牌,请求取一个,取不到就拒绝。允许一定程度的突发,大部分 API 网关用的就是它
固定窗口的实现:
local key = KEYS[1]
local limit = tonumber(ARGV[1])
local window = tonumber(ARGV[2])

local current = redis.call("incr", key)
if current == 1 then
    redis.call("expire", key, window)
end
if current > limit then
    return 0
end
return 1
令牌桶的实现,生成和消费都在一段 Lua 里,天然原子:
-- KEYS[1] 桶的键,ARGV[1] 每秒生成几个令牌,ARGV[2] 桶容量,ARGV[3] 当前时间戳
local tokens = tonumber(redis.call("get", KEYS[1]) or "0")
local last = tonumber(redis.call("get", KEYS[1] .. ":ts") or ARGV[3])
local capacity = tonumber(ARGV[2])
local rate = tonumber(ARGV[1])

-- 按流逝的时间补充令牌
tokens = math.min(capacity, tokens + (tonumber(ARGV[3]) - last) * rate)

local allowed = 0
if tokens >= 1 then
    tokens = tokens - 1
    allowed = 1
end

redis.call("set", KEYS[1], tokens)
redis.call("set", KEYS[1] .. ":ts", ARGV[3])
redis.call("expire", KEYS[1], math.ceil(capacity / rate) * 2)
redis.call("expire", KEYS[1] .. ":ts", math.ceil(capacity / rate) * 2)
return allowed
Redis 7.0 之后 Lua 脚本里不能用全局变量 所有变量都要用
local声明,否则脚本报错。上面这段所有变量都是local的
限流之外,Redis 8.0 并进核心的概率统计模块也值得留意:count-min sketch 做基数统计、t-digest 做分位数、Top-K 取最热的若干项,都是限流和监控里用得上的东西。
8. 这套方案挡不住什么
最后说说边界。缓存解决的是读,下面这些它一样都解决不了:
写压力 所有写还是落在数据库上。缓存不减轻写的压力,只减轻读的压力
复杂查询 多表关联、聚合、排序,缓存层做不了,只能靠数据库自己的索引和执行计划
唯一约束 并发插入同一唯一键,靠数据库约束才可靠。缓存里判断「有没有」再插入,中间是有窗口的
跨表事务 缓存不在事务里,数据库事务回滚了,缓存删不掉就会留下脏数据
把数据从 MySQL 挪到 Redis 解决不了这些问题,只是搬了个地方。真要解决存储层面的能力瓶颈,方向是 对象存储 那类方案,而不是把关系数据硬塞进缓存。
💡 补充:限流和缓存是两回事,别用一套机制干两件事。限流保护的是下游(数据库、第三方接口),缓存加速的是读路径。一个接口可以既限流又缓存,但它们的 key 空间、过期策略、失败降级方式都不一样,混在一起会让两边的故障互相影响。
🔥 一句话总结:缓存的三个经典故障各有各的解法——穿透用布隆过滤器和空值缓存挡,击穿用互斥锁或逻辑过期,雪崩用 TTL 加随机扰动和多级缓存;数据一致性靠「先更新库再删缓存」加一条兜底过期时间,分布式锁靠 SET NX PX 加一段比对标识再删的 Lua 脚本。