
01-MongoDB 基础:文档模型、CRUD 与聚合管道
📝 笔记摘要:MongoDB 的文档模型、增删改查与聚合管道
MongoDB 存的不是「行」,是「文档」——一个能带嵌套结构、类型自己说了算的 JSON 对象。这份自由度是它的优势,也是它最容易出事的地方:同一个字段,写进去是字符串、查的时候按数字来筛,什么都匹配不到,而且不报错。
这篇按 2026 年的现状写:服务端当前稳定版是 MongoDB 9.0,9.0.0 在 2026-09-28 GA,9.0.4(2026-10-13)修掉一批 CVE。insert() / update() / remove() 三个老 API 已经被官方标注为 Deprecated mongosh Method。writeConcern 的默认 w 不是 1,而是 "majority"。Spring Boot 4.x 把 MongoDB 的配置前缀从 spring.data.mongodb.* 挪到了 spring.mongodb.*,照着 3.x 的老文章抄会静默连到默认库。
MongoDB 系列 共 3 篇,这是第 1 篇
01-MongoDB 基础 文档模型、CRUD 与聚合管道 ← 本篇
02 MongoDB 索引与查询性能 复合索引、覆盖查询与执行计划
03 MongoDB 关联查询 N+1 慢查询、两次查询法与 $lookup
这篇的结构
1. MongoDB 是什么,不是什么
2. 跑起来:Docker、官方包与认证
3. 三个概念:数据库、集合、文档
4. BSON、JSON 与 _id
5. 建模:嵌入还是引用
6. 写入:insertOne、insertMany 与 writeConcern
7. 查询:find、投影与比较操作符
8. AND、OR 与 $type
9. 更新:updateOne、updateMany 与更新操作符
10. 删除:deleteOne 与 deleteMany
11. 分页与排序:skip、limit、sort
12. 聚合管道:$match → $group → $project → $sort → $limit → $lookup
13. 三个老 API 已经废弃
14. Java 侧接入:驱动与 Spring Data MongoDB
15. 2026 年的 MongoDB 9.0 变了什么
1. MongoDB 是什么,不是什么
一句话说清:MongoDB 是文档型数据库,集合里放的是 BSON 文档,每个文档自带结构,集合之间不强制外键。
它是 文档型数据库、结构随需求变的存储层、能做聚合计算的计算引擎
它不是 关系型数据库的等价替代品、强一致的金融账务系统、无限横向扩展的银弹
默认端口 27017
两个进程名mongod是服务端,mongosh是客户端 shell,5.0 起取代了老的mongoshell
和关系库比,差别落在三处:
结构 表要先定列,文档不用。字段可以有也可以没有,类型也能一个文档一个样
关系 靠应用代码保证,没有外键约束,跨集合的一致性得自己兜
事务 副本集上有多文档事务,但 MongoDB 的强项从来不是这个,是灵活和吞吐
刚接触的时候容易拿它当「MySQL 换个皮」,那样用会处处别扭。关系库的概念先看站内那篇 MySQL 入门概念,两边对着看差别更清楚。
2. 跑起来:Docker、官方包与认证
最快的路径是 Docker。官方现在维护的镜像是 mongodb/mongodb-community-server——不是那个更早的 mongo 标签,官方安装文档里给的一直是前者:
docker run --name mongodb -p 27017:27017 -d mongodb/mongodb-community-server:9.0:9.0 这种 tag 会跟着 9.0 系列的补丁号往前走。要可复现就钉到小版本 :9.0.4。
数据必须挂卷 不加
-v,容器一删数据就没了
AVX 是硬门槛 MongoDB 5.0 以上的镜像要求 CPU 支持 AVX,不支持只能退回 5.0 之前的镜像
7.0 之前已 EOL 官方明确说 7.0 之前的版本不再支持,只适合测试
生产用别的镜像 官方推荐mongodb/mongodb-enterprise-server,它和 Kubernetes Operator 配套
带上持久化和认证:
docker run -d --name mongodb \
  -p 27017:27017 \
  -v mongo-data:/data/db \
  -e MONGO_INITDB_ROOT_USERNAME=appuser \
  -e MONGO_INITDB_ROOT_PASSWORD=${MONGO_ROOT_PASSWORD} \
  mongodb/mongodb-community-server:9.0
MONGO_INITDB_ROOT_USERNAME 和 MONGO_INITDB_ROOT_PASSWORD 只在数据目录第一次初始化时生效。容器已经建过库之后再改这两个变量,密码是不会变的。想改密码得进容器里改,或者把卷删掉重建——数据一起没。
不想用 Docker 就走官方包。Linux 上先加 MongoDB 自己的软件源(/etc/apt/sources.list.d/mongodb-org-9.0.list 或 /etc/yum.repos.d/mongodb-org-9.0.repo),再装 mongodb-org:
# Ubuntu / Debian
sudo apt-get install -y mongodb-org

# RHEL / CentOS / Rocky
sudo yum install -y mongodb-org
别装错包 Ubuntu 自带的
mongodb包不由 MongoDB 维护,而且和官方的mongodb-org冲突,已经装着的要先卸掉
装完是系统服务sudo systemctl enable mongod让它开机自启,sudo systemctl status mongod看状态
客户端单独装 服务端包里不带 shell,mongosh要单独装
客户端连上去:
mongosh --port 27017连上之后敲一句 db.runCommand({ hello: 1 }),返回 ok: 1 就说明服务是活的。
3. 三个概念:数据库、集合、文档
MongoDB 只有三个必须记住的名词,剩下的一切都是从这三个往上搭的。
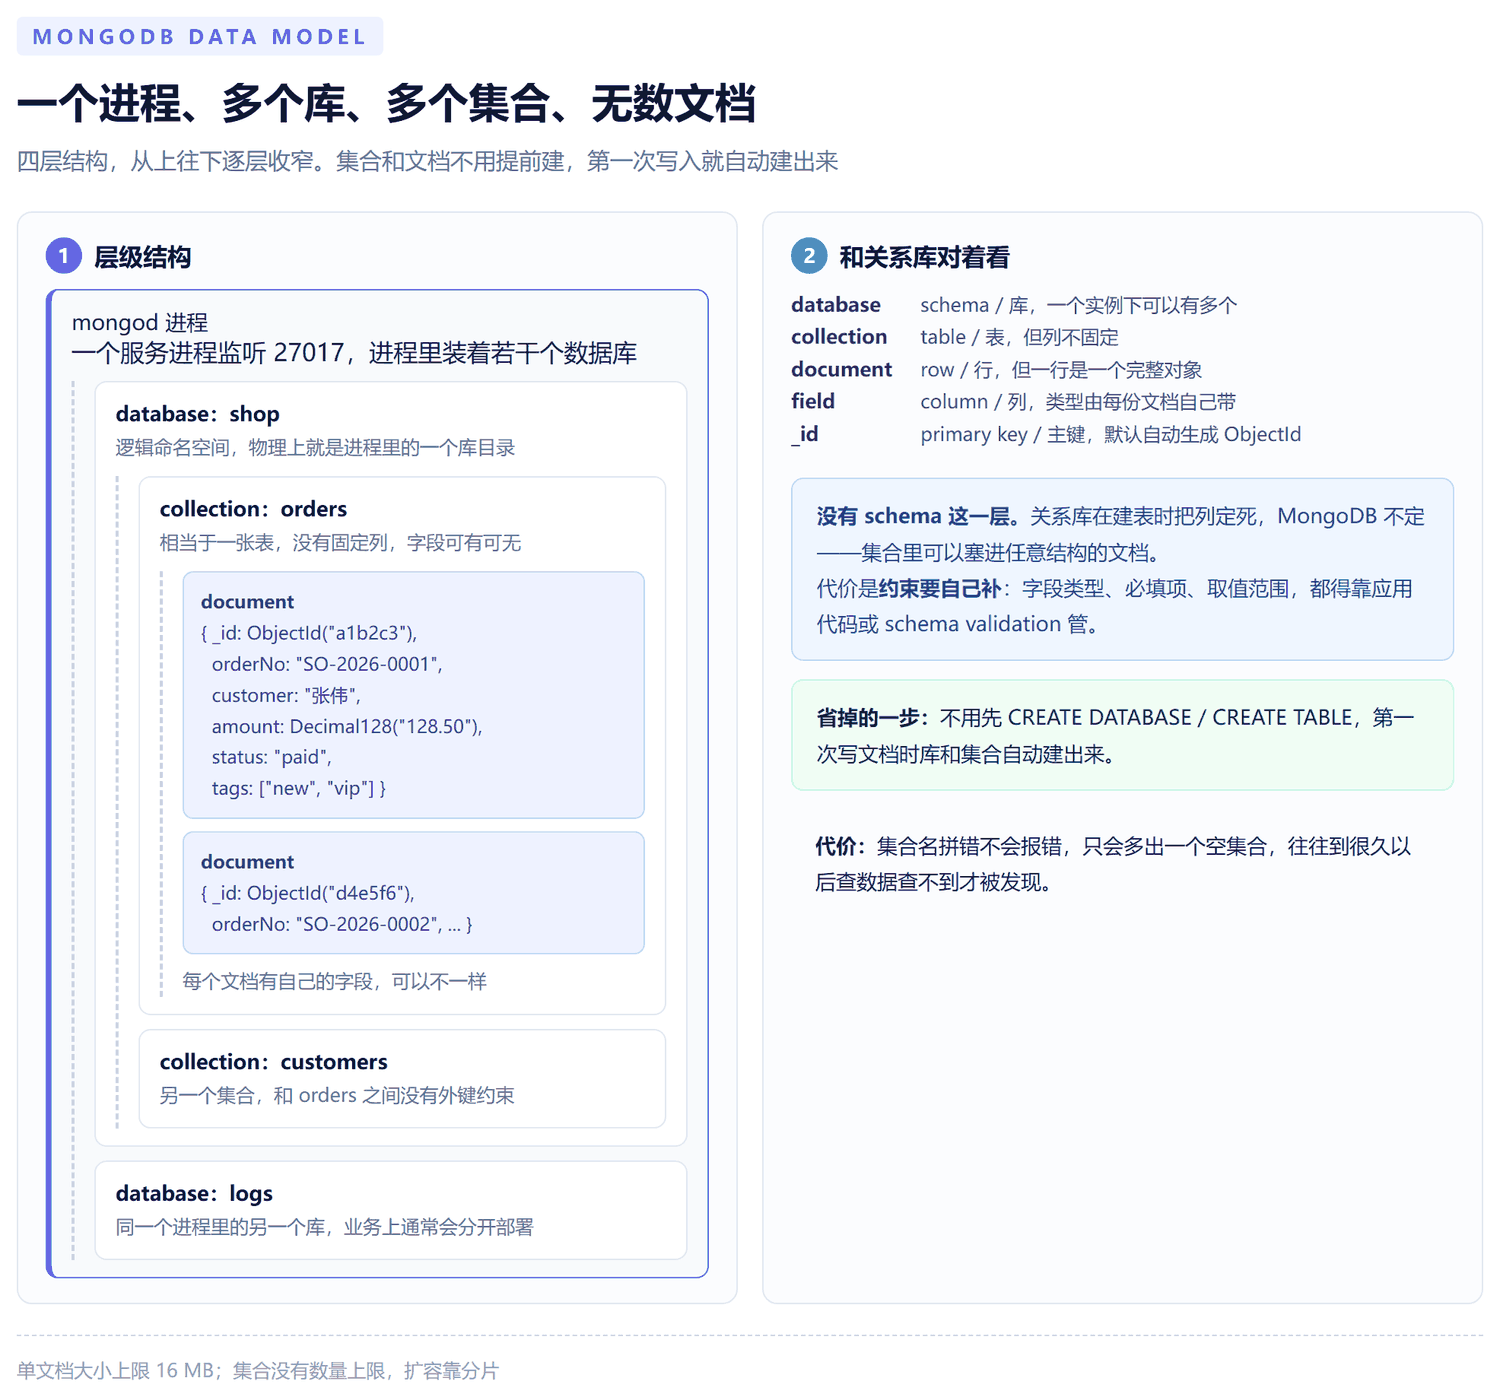
数据库 database 逻辑上的命名空间,一个
mongod进程管着好几个
集合 collection 对应关系库的表,没有固定列
文档 document 对应关系库的行,但是一个完整对象,可以嵌套
用 use shop 切库,db.orders 这种写法里 shop 是库、orders 是集合。
最容易误解的一点:库和集合都不需要提前创建。第一次往 db.orders 里写文档,库和集合会自动建出来。这个设计让「先建表再灌数据」的两步能省掉,但也有代价——拼错集合名不会报错,只会多出一个空集合,等到半年后查数据查不到才发现名字写错了。
什么时候必须提前建 要设 schema validation、要指定分片键、要配 collation,这些都得在集合建好之后做
怎么提前建db.createCollection("orders"),或者db.createCollection("orders", { validator: {...} })带上校验规则
4. BSON、JSON 与 _id
MongoDB 在网络上传输和磁盘上存的都是 BSON,不是 JSON。BSON 是 JSON 的二进制超集,多出来的东西是 JSON 表达不了的那部分:
数值分了四种
int(32 位)、long(64 位)、double(浮点)、decimal(高精度十进制)
有时间类型date是 64 位毫秒时间戳,不是字符串
有二进制binData,带子类型,能标记「敏感数据,日志里只打码」
有 ObjectId 12 字节,MongoDB 自己的主键格式
有正则regex,可以直接存成 BSON 而不是字符串
JSON 里所有的数字都是「数」,BSON 里不是。BSON 是强类型的,MongoDB 的比较也是按类型来的——{ amount: 100 } 和 { amount: "100" } 在 MongoDB 眼里是两个值,{ amount: 100 } 查不到字符串那批。这是 MongoDB 里最常见的一类「查不出数据」的根因。
金额这类不能丢精度的字段,用 Decimal128("9823.1297"),它支持 34 位十进制有效数字;Java 侧对应 BigDecimal,Python 侧对应 decimal.Decimal。
每份文档必须带 _id,它是主键,也是自动建出来的唯一索引。
不写 _id 也有 驱动会自动生成一个 ObjectId
ObjectId 的结构 4 字节秒级时间戳 + 5 字节进程随机值 + 3 字节进程内自增,总共 12 字节
大致有序,不是严格有序 同一秒内生成的没有保证先后,多台机器时钟也不一定同步,所以按_id排序只是「约等于」按创建时间排序
要自己控制主键也完全可以,直接写自己的 _id 字段(业务单号、雪花 ID 都行),但要想清楚代价:非 ObjectId 的 _id 不再自带时间序,按它做范围查询会退化成全表扫。
5. 建模:嵌入还是引用
关系库里「一对多」要建外键表;MongoDB 里有两条路,选错了性能差一个数量级。
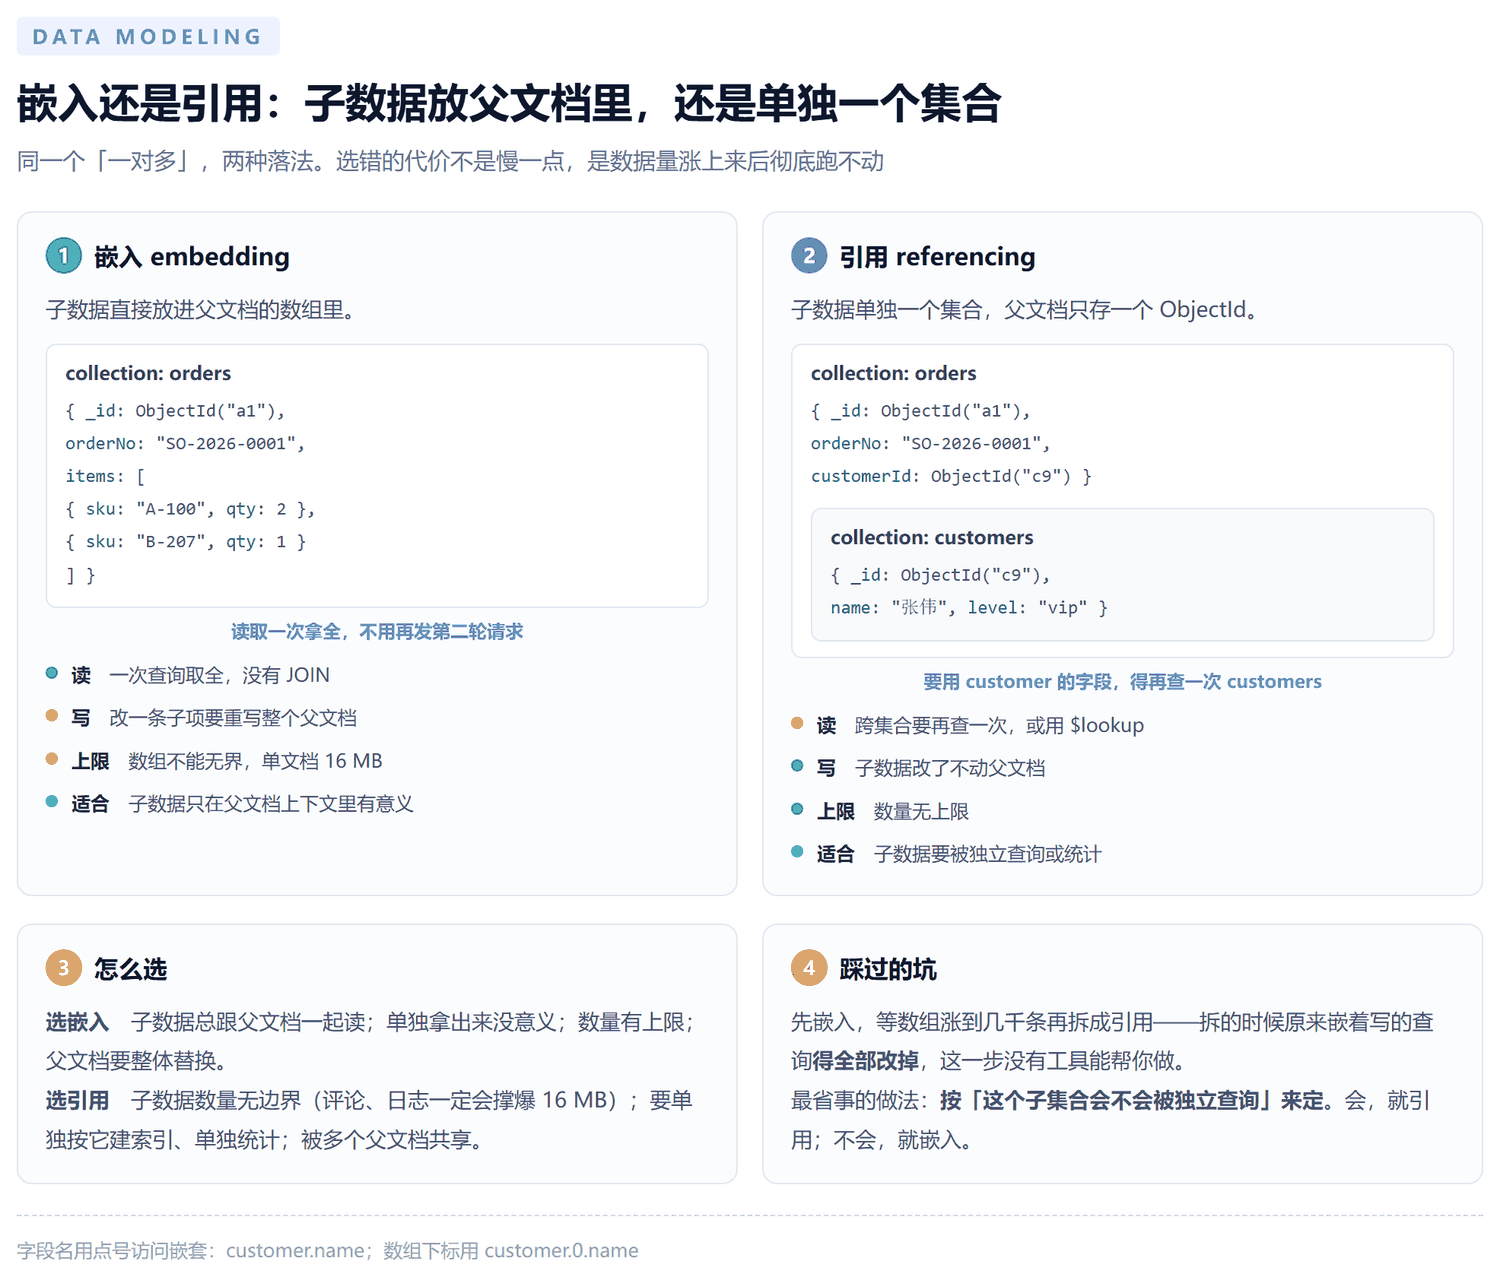
嵌入 embedding 子数据直接放进父文档的数组或子对象里
引用 referencing 子数据单独一个集合,父文档里只存一个 ObjectId
选嵌入的条件:
子数据总是跟着父文档一起读 一次查询就能拿全,不用再发一轮请求
子数据只在父文档的上下文里有意义 单独拿出来没有意义
子数据有上限 数组不会无限增长
父文档要整体替换 写入时不希望连带改别的集合
选引用的条件:
子数据数量无上限 MongoDB 单文档上限 16 MB,评论、日志这类一定会撑爆
子数据要独立查询 要单独按子数据建索引、单独统计
子数据被多个父文档共享 嵌进去就是复制多份,改一处要改很多处
实战里最常见的是「先嵌后拆」:一开始嵌进去,等哪天发现数组涨到几千条、或者需要单独查它了,再拆成引用。拆的时候记得把原来嵌着的查询全部改掉,这一步没有工具能帮你做。
还有第三条路是拆成引用之后,在查询的时候用 $lookup 把两边关联回来。嵌入、引用、关联这三者怎么选,MongoDB 关联查询 那篇专门讲。
6. 写入:insertOne、insertMany 与 writeConcern
写入有两个入口,单条用 insertOne,批量用 insertMany:
db.orders.insertOne({
  orderNo: "SO-2026-0001",
  customer: "张伟",
  amount: Decimal128("128.50"),
  status: "paid",
  tags: ["new", "vip"],
  createdAt: new Date()
})
db.orders.insertMany(
[
{ orderNo: "SO-2026-0002", customer: "李娜", amount: Decimal128("59.00"), status: "paid" },
{ orderNo: "SO-2026-0003", customer: "王强", amount: Decimal128("899.90"), status: "shipped" }
],
{ ordered: false }
)返回值
insertOne返回{ acknowledged: true, insertedId: ObjectId(...) };insertMany返回{ acknowledged, insertedIds: { 0: ..., 1: ... } }
ordered 默认 true 按数组顺序写,第一条失败就停。改成false就是能写的都写,失败项在返回结果里单独列出来
批量没有条数上限 但一次别塞十万条,拆成几千条一批
writeConcern 决定「写成功」这两个字意味着什么。它有三个字段:w(要几个节点确认)、j(要不要落磁盘日志)、wtimeout(等确认的毫秒上限,超了报 WriteConcernError)。
w
1只要主节点确认,"majority"要过半数据节点确认,0不要确认(主节点挂了数据可能丢)
jtrue表示要等写进磁盘日志才算完
wtimeout 等确认的时限,毫秒
默认值是 w: "majority",不是 1。官方的隐式默认规则写得很清楚:副本集和分片集群的全局默认写关注是 majority,只有「投票节点里仲裁员占多数」这种边缘部署才回落到 { w: 1 }。多数部署下 w: "majority" 会顺带要求副本集等待 on-disk journaling,代价是写延迟高一点,换来的是不会丢已确认的写。
db.orders.insertOne(
  { orderNo: "SO-2026-0004", customer: "赵敏", amount: Decimal128("199.00"), status: "paid" },
  { writeConcern: { w: "majority", wtimeout: 100 } }
)
事务里的写不要自己设 writeConcern,事务级别的设置才作数,单条操作上设了会被忽略。
7. 查询:find、投影与比较操作符
查询入口是 find,签名是 find(query, projection):
// 全部
db.orders.find()

// 按条件
db.orders.find({ status: "paid" })

// 只取要看的字段,_id 显式排除
db.orders.find({ status: "paid" }, { orderNo: 1, amount: 1, _id: 0 })
投影里写 1 是「要这个字段」,写 0 是「不要这个字段」。两种不能混用:
包含式
{ orderNo: 1, amount: 1 },只返回列出的字段,_id默认还会带上,要去掉得显式写_id: 0
排除式{ amount: 0, tags: 0 },返回除列出的之外的所有字段
比较操作符:
等于
{ status: "paid" },等于号直接写在 key 后面
不等于{ status: { $ne: "paid" } }
大于 / 不小于{ amount: { $gt: 100 } }、{ amount: { $gte: 100 } }
小于 / 不大于{ amount: { $lt: 100 } }、{ amount: { $lte: 100 } }
在列表里 / 不在{ status: { $in: ["paid", "shipped"] } }、{ status: { $nin: ["cancelled"] } }
字段存不存在{ paidAt: { $exists: true } }
正则匹配{ customer: { $regex: "^张" } }
金额字段带类型,比的是同类型的值。Decimal128("128.50") 和整数 100 比大小时,MongoDB 会按数值比较,不要求字段类型完全一致;但字符串 "100" 和数字 100 就是两个世界,谁也匹配不上谁。
8. AND、OR 与 $type
AND 不用写操作符,同一个文档里并列多个 key 就是 AND:
db.orders.find({ status: "paid", amount: { $gte: 100 } })OR 用 $or,值是一个条件数组:
db.orders.find({
  $or: [
    { status: "paid" },
    { status: "shipped" }
  ]
})
两者可以混用,同级的 key 是 AND,$or 整体是其中一个分支:
db.orders.find({
  amount: { $gte: 100 },
  $or: [
    { status: "paid" },
    { customer: "王强" }
  ]
})
按字段类型筛用 $type,数字和字符串别名都认:
db.orders.find({ amount: { $type: "decimal" } })
db.orders.find({ orderNo: { $type: 2 } })
完整的 BSON 类型编号:
double 1 string 2 object 3 array 4 binData 5 objectId 7 bool 8 date 9
null 10 regex 11 javascript 13 int 16 timestamp 17 long 18 decimal 19
minKey -1 maxKey 127
已废弃 undefined 6、dbPointer 12、symbol 14、javascriptWithScope 15
别名number同时匹配 int、long、double、decimal
两个容易记错的点:Min key 是 -1 不是 255;decimal 单独占 19 号,不是 double 的别名。已经被废弃的四种类型还留在规范里,但新代码不要写。
9. 更新:updateOne、updateMany 与更新操作符
两个入口,语义和 SQL 的 UPDATE 一一对应:
updateOne 只改匹配到的第一条
updateMany 改所有匹配的
// 改第一条
db.orders.updateOne(
  { orderNo: "SO-2026-0001" },
  { $set: { status: "shipped", shippedAt: new Date() } }
)

// 改所有
db.orders.updateMany(
  { status: "paid" },
  { $set: { status: "confirmed" } }
)返回结果里三个数要看懂:matchedCount 是匹配上的条数,modifiedCount 是真的改动了的条数。两个数不一样说明有些文档的值本来就等于新值,不是没匹配上。
更新操作符:
$set 给字段赋值,最常用
$inc 数值自增,{ $inc: { views: 1 } };字段不存在就当 0 起算
$unset 删字段,{ $unset: { remark: "" } },值给什么都行
$push 往数组尾部追加
$addToSet 追加但去重,$push的安全版
$pull 把数组里匹配的元素删掉
$rename 改字段名
// 计数 +1
db.orders.updateOne(
  { orderNo: "SO-2026-0001" },
  { $inc: { viewCount: 1 } }
)

// 追加标签,重复的不会进
db.orders.updateOne(
  { orderNo: "SO-2026-0001" },
  { $addToSet: { tags: "vip" } }
)
upsert 解决「没有就插入」:
db.orders.updateOne(
  { orderNo: "SO-2026-0009" },
  { $set: { customer: "孙丽", amount: Decimal128("88.00"), status: "paid" } },
  { upsert: true }
)匹配到了就更新,没匹配到就按这条文档插入一条新的(_id 由驱动生成)。
10. 删除:deleteOne 与 deleteMany
删只有两个入口,没有「默认删全部」这种危险默认值,这点比老 API 好:
deleteOne 删匹配到的第一条
deleteMany 删掉所有匹配的
// 删一条
db.orders.deleteOne({ orderNo: "SO-2026-0003" })

// 删掉所有已取消的
db.orders.deleteMany({ status: "cancelled" })
删整个集合用 db.orders.drop(),比一条条删快得多,而且不写 oplog 里的删除记录——但它不进回收站,drop 掉就没了。
要真删之前先看一眼,别手抖:
db.orders.countDocuments({ status: "cancelled" })11. 分页与排序:skip、limit、sort
limit(n) 最多返回 n 条
skip(n) 跳过前 n 条
sort({ 字段: 1 }) 按字段排序,1升序,-1降序,多字段按书写顺序逐级比较
// 每页 20 条,跳过前 40 条
db.orders.find({ status: "paid" })
  .sort({ createdAt: -1 })
  .skip(40)
  .limit(20)
sort 的位置很重要:先排再跳再截,顺序换一下结果就不对。
skip 有个明显的代价:翻到第 100 页时,前 99 页的数据还是被读了一遍、然后扔掉。数据量一大,深分页就是慢查询。MongoDB 提供了游标批量取的做法(第一批用 skip,后面用大于上一页最后一个值的条件接着往下捞),这属于性能话题,挪到 MongoDB 索引与查询性能 那篇讲。
12. 聚合管道:$match → $group → $project → $sort → $limit → $lookup
聚合管道是 MongoDB 的另一条主路:find 负责取数,管道负责算。一个管道由若干个 stage 组成,数据像水一样从左流到右,每个 stage 加工一次。
db.orders.aggregate([
  { $match: { status: "paid" } },
  { $group: { _id: "$customer", total: { $sum: "$amount" }, count: { $sum: 1 } } },
  { $project: { _id: 0, customer: "$_id", total: 1, count: 1 } },
  { $sort: { total: -1 } },
  { $limit: 10 }
])
常用的 stage:
$match 过滤,永远放第一个,放前面才能走索引
$project 投影和算新字段,1保留、0去掉、表达式算新值
$group 分组聚合
$sort 排序
$limit / $skip 截断和跳过
$unwind 把数组拆成多份,一份文档一个元素
$lookup 关联另一个集合
$count 计数
$out / $merge 把结果写回集合或合并进集合,这两个是唯二会改数据的 stage
$group 后面跟累加器:
$sum 求和
$avg 平均
$min / $max 最值
$first / $last 组内第一条、最后一条
$push 把值收进数组
$addToSet 去重后收进数组
$stdDevPop / $stdDevSamp 总体 / 样本标准差
$lookup 是关系库里 JOIN 的对应物,用法是指定「从哪个集合、按哪个字段对、结果放哪」:
db.orders.aggregate([
  { $match: { status: "paid" } },
  {
    $lookup: {
      from: "customers",
      localField: "customerId",
      foreignField: "_id",
      as: "customer"
    }
  },
  { $unwind: "$customer" }
])
$unwind 这一步是把数组摊平成多条文档,不加它的话 customer 是个数组,取字段要写 $customer.0.name,很难用。
还有一点:map-reduce 从 MongoDB 5.0 起就废弃了。新代码一律用聚合管道,老的 map-reduce 逻辑改写成管道以后性能也普遍更好。
13. 三个老 API 已经废弃
老教程和运维脚本里到处都是这三个方法,官方文档现在给它们挂的都是同一句警告:Important: Deprecated mongosh Method。
db.collection.insert() →
insertOne()/insertMany()
db.collection.update() →updateOne()/updateMany()
db.collection.remove() →deleteOne()/deleteMany()
为什么不只是「不推荐」而是「废弃」:老的 update() 靠 multi 参数控制改一条还是改多条,remove() 靠 justOne 控制,两个默认值都是「改全部」。手滑一次就是整库级别的数据变更。新 API 把这个行为从参数里拆出来做成了两个不同的方法,调用方想误伤都难。
老的 mongo shell 本身也已经被 mongosh 取代(MongoDB 5.0 起),ObjectId() 的方法名在新 shell 里也不一样。
14. Java 侧接入:驱动与 Spring Data MongoDB
Java 驱动坐标是 org.mongodb:mongodb-driver-sync,当前最新是 5.13.0;用 Spring Boot 的话不用自己管版本,starter 会带:
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-data-mongodb</artifactId>
</dependency>
Spring Boot 4.x 的配置前缀变了。3.x 是 spring.data.mongodb.*,4.x 挪到了 spring.mongodb.*:
spring:
  mongodb:
    uri: "mongodb://localhost:27017/shop"
    database: "shop"
Spring Boot 4.1.1 自己管理的驱动版本是 5.8.1。照着 3.x 的文章写 spring.data.mongodb.uri 的话,属性不生效,应用不会报错,会直接连上 mongodb://localhost/test——连接是通的,就是库连错了,这种错最难查。
不用 URI 时可以拆开写:
spring:
  mongodb:
    host: "mongodb.internal"
    port: 27017
    database: "shop"
    username: "appuser"
    password: ${MONGO_PASSWORD}
两种写法用起来:
MongoRepository 继承 Spring Data 的 CRUD 接口,按方法名自动派生查询,
findByStatusAndAmountGreaterThan这种
MongoTemplate 底层接口,要写复杂条件、或者用聚合管道时用它
CriteriaCriteria.where("status").is("paid").and("amount").gte(100),链式拼条件
@Repository
public interface OrderRepository extends MongoRepository<Order, String> {

    List<Order> findByStatusAndAmountGreaterThan(String status, BigDecimal amount);

    List<Order> findByCustomerIdOrderByCreatedAtDesc(String customerId);
}
Query query = new Query(Criteria.where("status").is("paid")
.and("amount").gte(new BigDecimal("100")))
.with(Sort.by(DESC, "createdAt"))
.limit(20);
List<Order> orders = mongoTemplate.find(query, Order.class);实体类上用 @Document("orders") 映射集合名,@Id 标主键,@Field("orderNo") 映射字段名。
15. 2026 年的 MongoDB 9.0 变了什么
当前稳定版是 9.0,9.0.0 在 2026-09-28 GA,9.0.4 在 2026-10-13 修了 CVE-2026-96297、CVE-2026-96299、CVE-2026-103965、CVE-2026-104004、CVE-2026-104005。
升级前值得知道的几处行为变化:
服务端 JS 换成 WASM 引擎 本地时间操作(
getHours()、toString())一律按 UTC 算,不再跟宿主机时区走。要按某个时区算,改用带timezone参数的日期操作符
索引字段变 multikey 时正在跑的查询可能被杀 往一个已建索引的字段里写数组值,会让索引变成 multikey,此时并发的引用该字段的查询可能报QueryKilledError,重跑一次就好
2dsphere 的错误码换了 键提取失败从 16755 / 16756 改成具名的 510 / 511,按老错误码匹配的代码要改
跨库 renameCollection 锁变强 副本集上重命名集合时会对源和目标集合持独占锁,整个操作期间都挡着,老版本存在写丢失的窗口
$group 不接受空字段名 累加器表达式写成空名会直接报错
change stream 在选举后强制校验 readPreference 角色变了不再满足偏好时返回InterruptedDueToReplStateChange(错误码 11602),合规驱动会自动用 resume token 续上,手写的getMore循环得自己处理
许可这条也得知道:MongoDB 服务端至今是 SSPL v1(2018-10-16 版),官方文档里对 MongoDB Community 的定义是「source-available, free-to-use, self-managed」。它不是 OSI 认可的开源许可,云厂商不能直接拿去转售托管服务。选型做商用评估时这一条要过法务。
副本集、事务、分片这些「部署侧」的话题这里只点到为止。副本集的思路和 Redis 哨兵有对照关系——都是「多节点 + 选主 + 故障切换」,细节见 Redis 部署与高可用;而把 MongoDB 当数据源做离线同步,站内那篇 DataX 离线同步 里提过 MongoDB 的 reader 和 writer。
💡 补充:MongoDB 的灵活是双刃剑,schema 校验要自己上。默认情况下集合里可以塞进任意结构的文档,一个字段写错类型、拼错名字,服务端照单全收也不报错,等到查询结果不对才暴露。真要投产,用 db.createCollection 的时候带 validator 和 validationLevel: "strict",让脏数据在入口就被挡掉——这一步比事后查数据省事得多。
🔥 一句话总结:MongoDB 的强项是结构随需求变、查询和聚合都在一个引擎里;用之前先把三件事钉死——_id 用不用 ObjectId、嵌入还是引用、字段类型从第一天就统一,前两个决定性能上限,第三个决定你会不会在半夜对着空结果集发呆。