
02-MongoDB 索引与查询性能:复合索引、覆盖查询与执行计划
📝 笔记摘要:MongoDB 的索引类型、复合索引、覆盖查询与执行计划
MongoDB 不用索引的时候,只有一种干活方式:把整个集合从头扫到尾,叫 COLLSCAN。集合一百万条就是扫一百万条,一条匹配的都没有也照扫不误。索引就是把这个行为反过来——先在有序的键值结构里定位,再去把文档捞出来。
这篇讲索引怎么设计、怎么验证、怎么评估代价。两个最常见的坑:复合索引的字段顺序随手写,导致查询根本用不上;建完索引不看执行计划,以为走索引了其实还在全表扫。执行计划怎么读、哪个数字该看哪一栏,第 5 节讲。
MongoDB 系列 共 3 篇,这是第 2 篇
01 MongoDB 基础 文档模型、CRUD 与聚合管道
02-MongoDB 索引与查询性能 复合索引、覆盖查询与执行计划 ← 本篇
03 MongoDB 关联查询 N+1 慢查询、两次查询法与 $lookup
这篇的结构
1. 没有索引的时候,MongoDB 在干什么
2. 索引类型全集
3. 复合索引:字段顺序决定能用什么查询
4. 覆盖查询:让索引自己把数据读完
5. explain 与 executionStats:执行计划怎么读
6. 深分页的代价:skip 为什么越翻越慢
7. 唯一索引、部分索引与稀疏索引
8. TTL 索引:让数据自己过期
9. 索引的代价
10. 建索引时常犯的错
1. 没有索引的时候,MongoDB 在干什么
官方对索引的描述很直白:索引通常能极大提高查询效率。没有索引,MongoDB 在读取数据时必须扫描集合里的每个文档,再挑出符合条件的那些。这种全量扫描在执行计划里叫 COLLSCAN。
小集合上感觉不出来。几万条的时候还能忍,几十万条开始变慢,几百万条的时候一个查询几十秒甚至几分钟都很常见。
索引本身是一份特殊的数据结构,用 B-tree 存集合里一小部分数据,整理成便于遍历的形式。注意它不存整份文档,只存「键值 + 指向文档的引用」,所以索引比原集合小得多——小到能整个塞进内存。
建一个单字段索引:
db.orders.createIndex({ status: 1 })1 是升序,-1 是降序。索引名不指定的话 MongoDB 自己拼,规则是「字段名 + 排序方向」,比如上面这个叫 status_1,复合索引 { status: 1, createdAt: -1 } 叫 status_1_createdAt_-1。
管理索引的四个命令:
// 看有哪些索引
db.orders.getIndexes()

// 看索引占了多少空间
db.orders.totalIndexSize()

// 删掉全部索引(_id 索引会保留)
db.orders.dropIndexes()

// 删掉指定索引
db.orders.dropIndex("status_1")
dropIndexes() 丢的是 _id 索引和最后一个分片键兼容索引之外的全部索引。MongoDB 8.3 起这个命令是幂等的,指定一个不存在的索引不会报错。
2. 索引类型全集
官方文档把索引类型列成了一份完整清单,2026 年的版本是八种:
Single Field 单字段索引 最常见,一个字段一个索引
Compound 复合索引 多个字段按指定顺序排序,字段顺序决定它能支持哪些查询
Multikey 多键索引 字段值是数组时自动创建,数组里每个不同的值各占一条索引项
Wildcard 通配索引 给结构不定的集合用,支持按任意字段名查,写法见下
Geospatial 地理索引2dsphere/2d,地理空间查询用
Hashed 哈希索引 存字段值的哈希,主要给哈希分片当分片键
Text 全文索引 给$text查询用
Clustered 聚簇索引 决定集合在磁盘上的存放顺序,用聚簇索引建的集合叫聚簇集合
通配索引的键写法比较特别,两个星号表示「所有字段」:
// 给文档里所有字段建通配索引
db.events.createIndex({ "$**": 1 })

// 也可以只给某个字段路径下的所有子字段建
db.events.createIndex({ "payload.$**": 1 })
多键索引有几条限制值得单独记住,因为它们不是「建索引时报错」,而是「建的时候没拦住,跑到生产上才炸」:
不用声明 在数组字段上建索引,MongoDB 自动把它变成多键索引
一条索引最多一个数组字段 复合索引里有两个数组字段直接建不出来;已经建好了再插这种文档,插入会失败
不能当分片键 多键索引不能做分片键索引
不能排序 在多键索引字段上排序,除非边界条件全部满足,否则执行计划里会多一个内存排序阶段
不能覆盖数组字段的查询 但能覆盖非数组字段,前提是索引是复合的
$expr 用不上$expr不支持多键索引
唯一索引倒是可以建在多键索引上:同一个文档内部出现重复的索引键值是允许的,只要不跟别的文档撞就行。
顺带说一句:索引不只是为了查得快,$lookup 的性能也完全取决于被关联表上有没有索引,没有的话官方用词是「likely has poor performance」。这一层展开在 MongoDB 关联查询 里。
3. 复合索引:字段顺序决定能用什么查询
复合索引的字段顺序不是随便写的。B-tree 里先按第一个字段排,第一个字段相同的再按第二个字段排,顺序决定了这个索引能支持哪些查询组合。
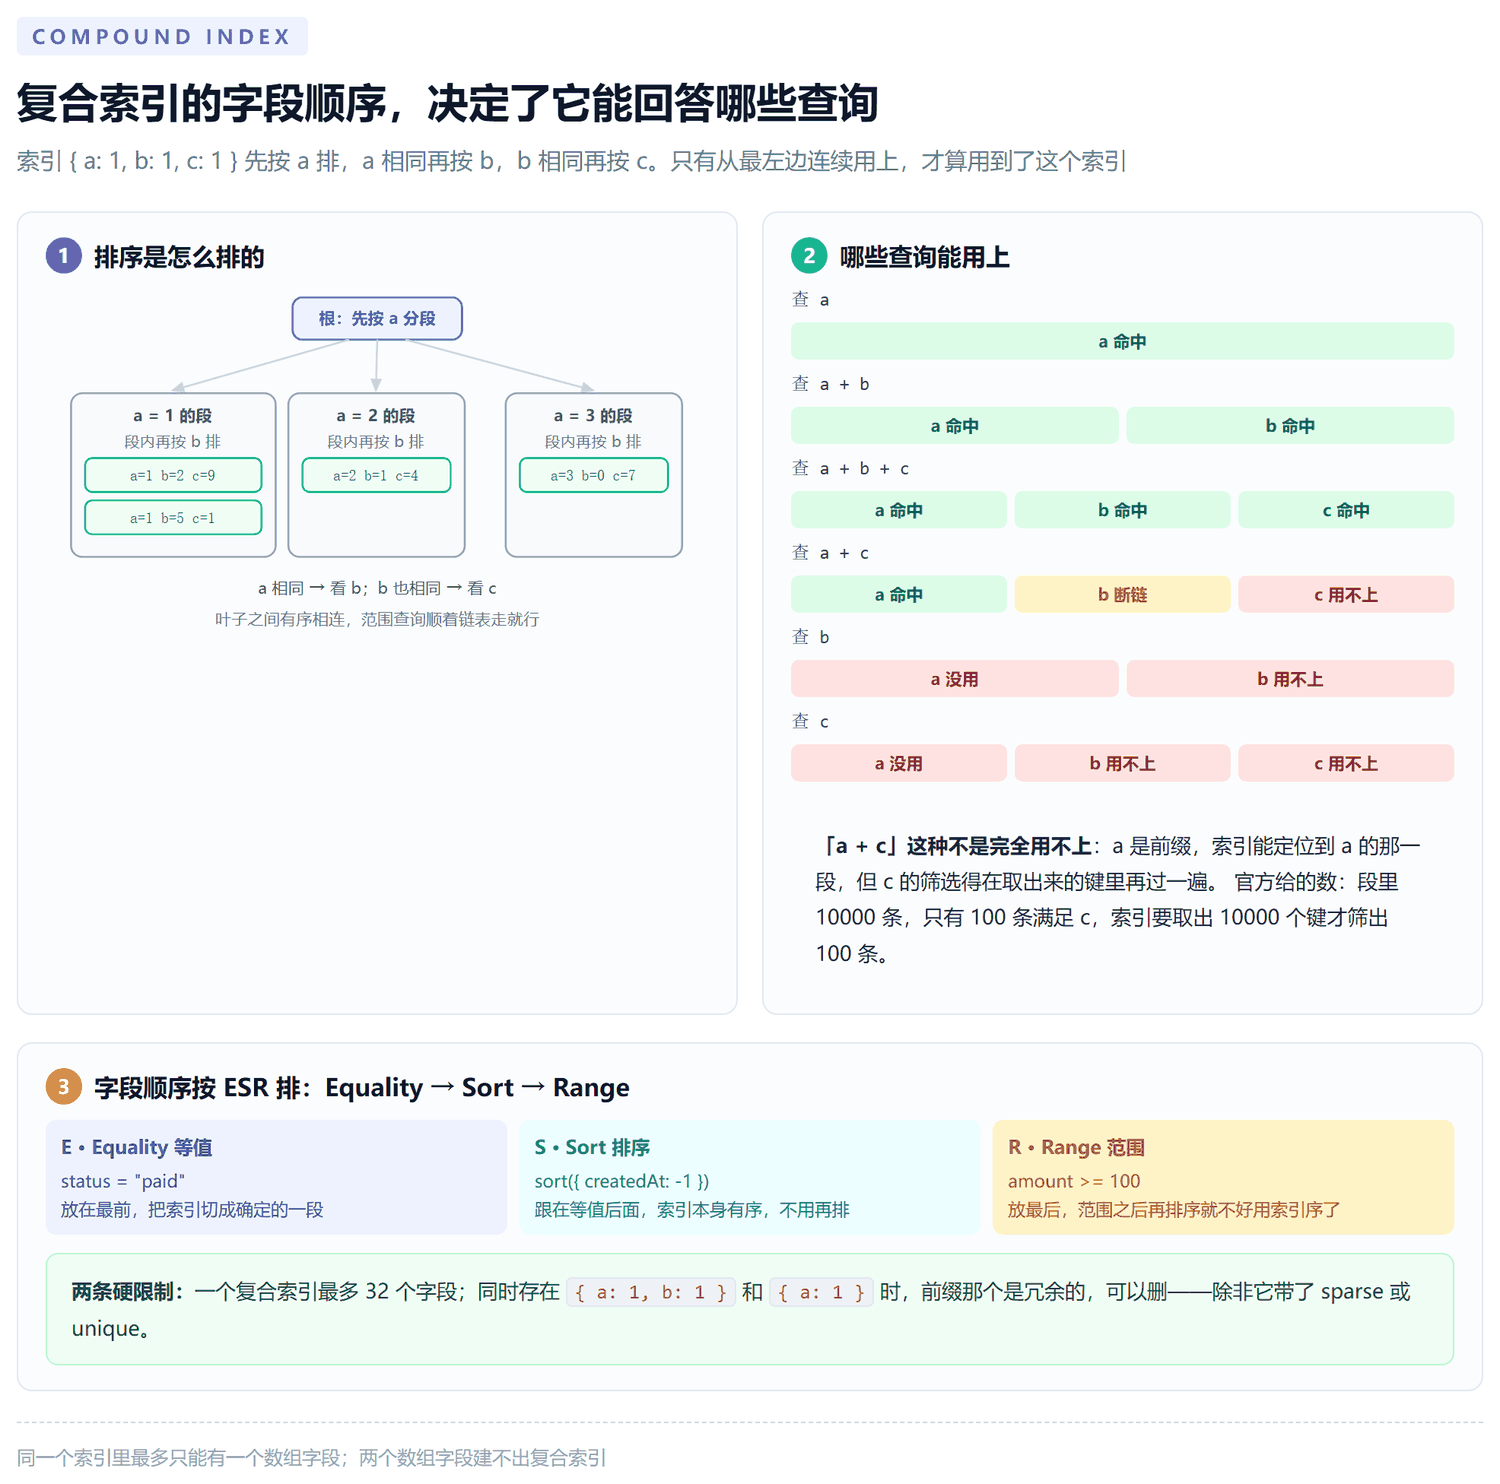
官方给的例子是 { item: 1, location: 1, stock: 1 },它的前缀有这些:
能支持
item、item + location、item + location + stock
也能支持但效率打折item + stock——因为item是前缀,索引能用,但stock的筛选得在索引里过一遍
完全用不上location、stock、location + stock——都不是前缀
官方对「打折」这件事给了具体数字:集合里有 10000 条 item: "saccharomyces cerevisiae",其中只有 100 条 stock: 60。查询 item 和 stock 时,索引会取出 10000 个键,在 IXSCAN 阶段按 stock 过滤,最后只返回 100 条。也就是说扫了 10000 个键,只用上 100 个。
字段顺序按什么排?官方给的规则是 ESR:Equality、Sort、Range。
E 等值条件
{ status: "paid" }这种,字段值完全相等的
S 排序字段sort()里用到的字段
R 范围条件{ amount: { $gte: 100 } }这种带比较的
等值条件放最前,因为它能把索引切成一段确定的范围;排序字段跟在后面,这样索引本身就是有序的,不用额外排;范围条件放最后,因为它会切出一个连续的区间,区间之后再排序就不好利用索引顺序了。
// 查询:status 等于 paid,amount 大于等于 100,按 createdAt 倒序
// 索引:等值 → 排序 → 范围
db.orders.createIndex({ status: 1, createdAt: -1, amount: 1 })
还有两条硬限制:
单个复合索引最多 32 个字段
前缀索引是冗余的 同时有{ a: 1, b: 1 }和{ a: 1 }时,前缀那个可以删——除非它带了sparse或unique约束
4. 覆盖查询:让索引自己把数据读完
正常的一次查询要走两步:索引定位到文档位置(IXSCAN),再把文档本身读出来(FETCH)。覆盖查询(covered query)省掉第二步——需要的所有字段索引里就有,压根不用去读文档。
官方给的成立条件是两条:
查询里用到的所有字段都在索引里 包括应用指定的和内部需要的(比如分片场景)
返回结果里要的所有字段也在同一个索引里
有个容易踩的细节:_id 默认会出现在返回结果里,它不在你的索引里,查询就覆盖不了。要覆盖就得显式把它排掉。
// 建索引
db.orders.createIndex({ status: 1, createdAt: -1 })

// 覆盖查询:_id 必须显式排除
db.orders.find(
  { status: "paid" },
  { status: 1, createdAt: 1, _id: 0 }
)覆盖查询为什么快:索引键通常比文档小得多,而且索引多半在内存里或磁盘上顺序排列,扫一遍连续的键比随机读文档快一个数量级。
用 explain 验证,输出里会有 projectedCovered: true:
db.orders.explain("executionStats").find(
  { status: "paid" },
  { status: 1, createdAt: 1, _id: 0 }
)
覆盖查询有两个限制容易忘:
多键索引覆盖不了数组字段 要覆盖数组字段的查询,多键索引帮不上忙
分片集合上索引必须包含分片键 在mongos上跑的时候,索引里没有分片键就覆盖不了
5. explain 与 executionStats:执行计划怎么读
索引建了不等于用上了。唯一能证明「走没走索引」的办法是看执行计划。
// 简洁写法
db.orders.explain("executionStats").find({ status: "paid" })

// 完整写法,可以额外带 comment
db.runCommand({
  explain: {
    find: "orders",
    filter: { status: "paid" }
  },
  verbosity: "executionStats",
  comment: "订单列表慢查询排查"
})
三种 verbosity:
queryPlanner 只跑优化器选计划,不真正执行。最快,用来快速看选了哪个索引
executionStats 真正执行一遍,返回执行统计。日常排查用这个
allPlansExecution 把所有候选计划都跑一遍,默认值
默认值有个坑:explain 命令默认是 allPlansExecution,而 db.collection.explain() 默认是 queryPlanner。同一条查询用两种写法跑,耗时完全不同——用错模式会以为查询本身很慢。
输出里看三块:
winningPlan 最终选中的计划。看
stage字段:IXSCAN是走了索引,COLLSCAN是全表扫,一眼就能分清
rejectedPlans 被否掉的候选计划,可以看出优化器为什么没选它
executionStats 真正的统计数字,下面细说
executionStats 里最该盯的三个数:
totalKeysExamined 扫了多少个索引键
totalDocsExamined 扫了多少份文档。这一步是真正吃 IO 的
nReturned 最终返回了多少条
判读方法很简单:
// 健康:扫的文档数和返回数几乎相等
"totalKeysExamined" : 1000,
"totalDocsExamined" : 1000,
"nReturned" : 1000

// 有问题:扫了一万份文档只返回 100 条
"totalKeysExamined" : 10000,
"totalDocsExamined" : 10000,
"nReturned" : 100
totalDocsExamined 远大于 nReturned,说明索引没起到筛选作用——常见的两种原因:索引的字段顺序不对,用不上;或者索引用上了,但先取了太多键再在内存里过滤(ESR 里范围条件放太前的典型症状)。
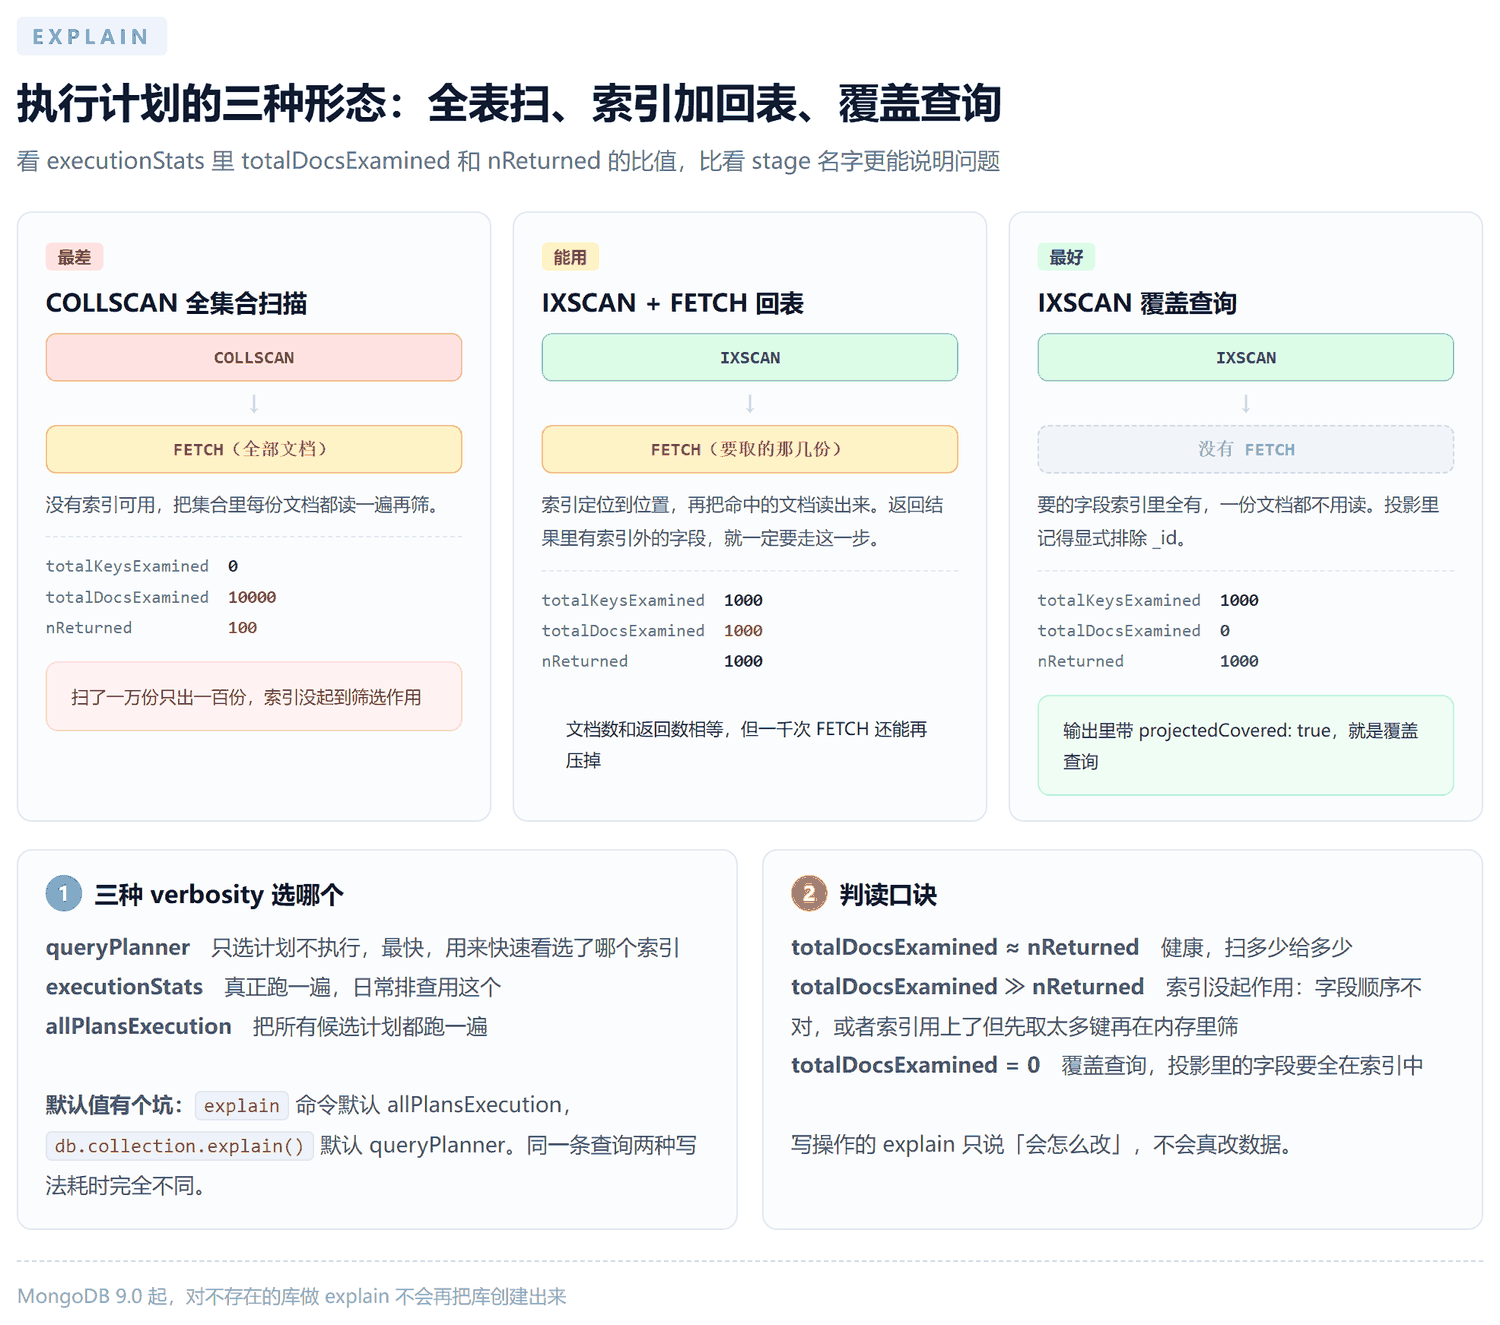
两种情况会让 totalDocsExamined 明显小于 totalKeysExamined:
覆盖查询 不 FETCH,
totalDocsExamined直接是 0
索引命中但条件不精确 比如只按前缀字段过滤,剩下条件在内存里过
两个补充:explain 不会改数据,对写操作来说它只告诉你「会怎么改」,不真改;MongoDB 9.0 起,对一个不存在的库做 explain 也不会把它创建出来。
6. 深分页的代价:skip 为什么越翻越慢
skip(n) 的实现是「取 n 条丢掉,再取 limit 条」。翻到第 100 页,前 99 页的数据还是被完整读了一遍然后扔掉。
页码越靠后越慢,原因是线性的:第 1 页扫 20 条,第 100 页扫 2000 条。数据量再大一点,这一页就是全表扫。
解法是基于游标的翻页:记住上一页最后一条的排序键,下一页从它后面接着取。
// 第一页
db.orders.find({ status: "paid" })
  .sort({ createdAt: -1, _id: -1 })
  .limit(20)

// 下一页:lastCreatedAt 和 lastId 是上一页最后一条的值
db.orders.find({
  status: "paid",
  $or: [
    { createdAt: { $lt: lastCreatedAt } },
    { createdAt: lastCreatedAt, _id: { $lt: lastId } }
  ]
})
  .sort({ createdAt: -1, _id: -1 })
  .limit(20)
这个写法有两个前提,缺一个就会翻错:
排序键必须有索引支撑
{ status: 1, createdAt: -1, _id: -1 },否则条件再对也是 COLLSCAN
排序键要能唯一确定顺序createdAt可能重复,所以后面要跟一个_id做第二排序键;$or里那个「等于 + 小于」的分支就是为它准备的
这个翻页方式和关系库里的「游标分页」是同一个思路,键集分页(keyset pagination)比 offset 分页快,而且并发插入时不会漏数据——offset 分页在别人插了新数据后会错位。
7. 唯一索引、部分索引与稀疏索引
三种索引都在 createIndex 的 options 里,但解决的是不同问题。
唯一索引保证键值不重复:
db.orders.createIndex({ orderNo: 1 }, { unique: true })建唯一索引有两个时机要注意:
数据已经有重复时建不出来 报错 DuplicateKey,先把重复数据清掉
副本集和分片上建唯一索引要停写 官方给的滚动建索引流程要求整个过程停写;不能停写的话,就直接在主节点(分片集群则是mongos)上跑createIndex
唯一索引还有一层保险作用:upsert 在并发下可能插出重复数据,两个请求同时没查到、同时插入。有唯一索引时第二个请求会撞 DuplicateKey,捕获后重试就行。
部分索引只索引一部分文档:
// 只给未归档的订单建索引
db.orders.createIndex(
  { customerId: 1, createdAt: -1 },
  { partialFilterExpression: { status: { $in: ["paid", "shipped"] } } }
)
条件字段大量重复、而且大部分文档不需要被查的时候,部分索引能省掉索引里的一大半条目。
稀疏索引只索引「确实有这个字段」的文档:
// 只给有 remark 字段的文档建索引
db.orders.createIndex({ remark: 1 }, { sparse: true })和部分索引的关系,官方文档说得很直接:部分索引的功能是稀疏索引的超集,除非应用有特殊需求,用部分索引代替稀疏索引。区别在于稀疏是「按字段是否存在」这个隐式条件,部分索引是你自己写的显式条件。
两者可以叠加:partialFilterExpression 加 unique: true 时,唯一约束只对满足过滤条件的文档生效。这是做「条件唯一」的标准做法——比如只让未归档的订单号唯一。
分片上的唯一索引有限制 范围分片的集合里,只有分片键索引、或者以分片键为前缀的复合索引能是唯一索引
_id 只在单分片内唯一 如果_id不是分片键,两个分片上可以各有一个_id: 1,跨分片的唯一性得应用自己保证
哈希索引不能唯一unique选项对 hashed 索引不可用
8. TTL 索引:让数据自己过期
TTL 索引是带 expireAfterSeconds 的单字段索引,到期后 MongoDB 自己把文档删掉:
// 30 天后自动删除
db.sessions.createIndex(
  { lastActiveAt: 1 },
  { expireAfterSeconds: 60 * 60 * 24 * 30 }
)
几个必须知道的点:
只能建在单字段索引上 复合索引不支持 TTL,写了
expireAfterSeconds也会被忽略
不是立刻删 后台任务每 60 秒跑一次,所以文档过期到被删掉之间最多差 60 秒,负载重的时候还要更久
单线程、不可并发 过期删除是一个单线程后台任务,数据量大时跑得慢,中途每 60 秒会停一次当前循环再开新的一轮
只删文档,不删集合 集合空了也还在
改不了只能删了重建createIndex()不能改已有 TTL 索引的expireAfterSeconds,要改得用collMod命令
同一个字段上如果已经有普通单字段索引,就建不了 TTL 索引——键定义一样、只有选项不同,MongoDB 不允许。要转换也得用 collMod。
典型用途:会话过期、日志清理、临时验证码、订单超时关闭。
9. 索引的代价
索引不是免费的。它换来读性能,付出的是写放大和存储空间。
写放大 每插一条文档,所有相关的索引都要更新一遍。索引建得越全,写得越慢
占内存 索引一般在内存里,一个集合的索引总量超过可用内存时就开始走磁盘
占磁盘 用db.orders.totalIndexSize()看,跟集合本身的大小对比一下
建索引本身很贵 在有数据的集合上建索引是一次全量扫描 + 排序,大集合上要规划时间窗口
这就是为什么「给每个字段都建一个索引」是反模式——读查询确实都快了,但每一次写入都要多维护 N 棵 B-tree,写吞吐直接掉下来。
还有两条来自文档的硬限制:
哈希索引不能唯一
unique选项对 hashed 索引不可用
唯一索引在分片集群上受限 只有分片键索引或以分片键为前缀的复合索引能做唯一索引
10. 建索引时常犯的错
把这篇的要点收一下,最容易踩的六件事:
复合索引字段顺序随手写 不按 ESR 排,最常见的直接后果是查询用不上索引,explain 一看还是 COLLSCAN
建完不验证createIndex返回成功不代表查询会用它,一定要explain("executionStats")看totalDocsExamined和nReturned的比例
前缀索引和复合索引并存{ a: 1 }和{ a: 1, b: 1 }同时存在,前缀那个是冗余的,除非它带sparse或unique
该用部分索引的地方用了全量索引 归档数据占了九成还给它建全量索引,白白多占空间和写放大
用 skip 做深分页 翻页越往后越慢,改成基于游标的翻页,排序键记得带_id做第二排序键
在数组字段上建复合索引 一个复合索引里最多只能有一个数组字段,第二个数组插进来就会失败
还有一个顺序问题:索引应该跟着查询来,而不是跟着字段来。先把线上跑得慢的查询捞出来(db.setProfilingLevel(2) 打开慢查询日志,或者看 serverStatus),对着这些查询建索引,比凭感觉给字段加索引有效得多。
和关系库对照着看会更快一些——复合索引、覆盖查询、EXPLAIN 读执行计划这几件事在 MySQL 里是同一套思路,站内那篇 MySQL 优化与版本 可以对着读。差别在于 MongoDB 默认没有 schema,字段类型和字段该不该存在都是应用自己说了算的——所以 MongoDB 的索引设计必须从实际查询出发,而不是从「表结构」出发。
数据模型怎么定、字段类型怎么统一,见 MongoDB 基础 那篇的第 4、5 节。
💡 补充:索引不是越多越好,但「够用」这件事有客观标准——每次上线新查询之前,先把这条查询的 explain("executionStats") 存下来,看 totalDocsExamined 和 nReturned 是不是同一个量级。这一条检查加上「索引改动必须复跑全部既有查询的 explain」,索引膨胀基本就控制住了。反过来,删索引之前也用 explain 确认一遍:dropIndex 之后优化器可能选到另一个更差的索引。
🔥 一句话总结:MongoDB 的索引只有一条铁律——字段顺序按 ESR 排,建完必须用 explain("executionStats") 验证 totalDocsExamined 和 nReturned 是不是同一个量级;做到这两点,慢查询基本不会活到上线那天。