
03-MongoDB 关联查询:N+1 慢查询、两次查询法与 $lookup
📝 笔记摘要:MongoDB 的关联查询:N+1、两次查询法与 $lookup
关系库里 JOIN 一行能写完的事,MongoDB 默认不让写。于是就有了那条在 NoSQL 项目里非常常见的路子:先查主表拿到一批 id,再拿着这些 id 去查另一张表,最后在内存里拼起来。
这条路子本身没问题——问题在于它是 N+1 还是 两次查询法,中间差了整数量级的性能。而且它在三种场景下会直接失效:关联数据要参与过滤、要参与排序、或者关联表比主表大得多。这篇把三种解法的边界划清楚:什么时候两次查询法就够,什么时候必须上 $lookup,以及 $lookup 自己有哪些坑。
MongoDB 系列 共 3 篇,这是第 3 篇
01 MongoDB 基础 文档模型、CRUD 与聚合管道
02 MongoDB 索引与查询性能 复合索引、覆盖查询与执行计划
03-MongoDB 关联查询 N+1 慢查询、两次查询法与 $lookup ← 本篇
这篇的结构
1. 关联查询:NoSQL 里最常被问倒的题
2. 先分清两种「内存查询」:N+1 和两次查询法
3. 两次查询法:怎么写才不是 N+1
4. 两次查询法的三个失效场景
5. $lookup:把 join 放回数据库
6. $lookup 的三个坑
7. let + pipeline:等值匹配不够用的时候
8. $unwind 与一对多的行数放大
9. 怎么发现 N+1:慢查询日志
10. 最终选型:嵌入、引用、还是关联
1. 关联查询:NoSQL 里最常被问倒的题
「MongoDB 能不能 join」这个问题,几乎每个从关系库转过来的人都会问一遍。答案是:没有 JOIN 这个语法,但有三条路能把关联做出来,代价各不相同。
嵌入 写入时就把关联数据冗余进主文档,读的时候零成本
引用 主文档只存一个 id,关联时自己去查另一张集合
服务端关联 用聚合管道的$lookup,把 join 放回数据库里做
选哪条路,取决于三个问题:
关联数据和主数据是不是总在一起读写? 是 → 考虑嵌入
关联数据要不要参与过滤、排序、分页? 要 → 引用方案不够用
关联表比主表大还是小? 大 → 拉回内存就是灾难
第一个问题的答案在 MongoDB 基础 第 5 节(嵌入 vs 引用)讲过;第二个问题的答案在 02 篇的索引部分也铺垫过(MongoDB 索引与查询性能)。这篇专门讲第三条路,以及「引用方案到底什么时候够用」这个判断。
2. 先分清两种「内存查询」:N+1 和两次查询法
「先查主表,再拿 id 查另一张表」这个描述,覆盖了两种完全不同的实现,成本差得很远。
第一种:N+1。拿到一条就查一次:
List<Order> orders = orderRepository.findByStatus("paid");
for (Order order : orders) {
    order.setCustomer(customerRepository.findById(order.getCustomerId()).orElse(null));
}
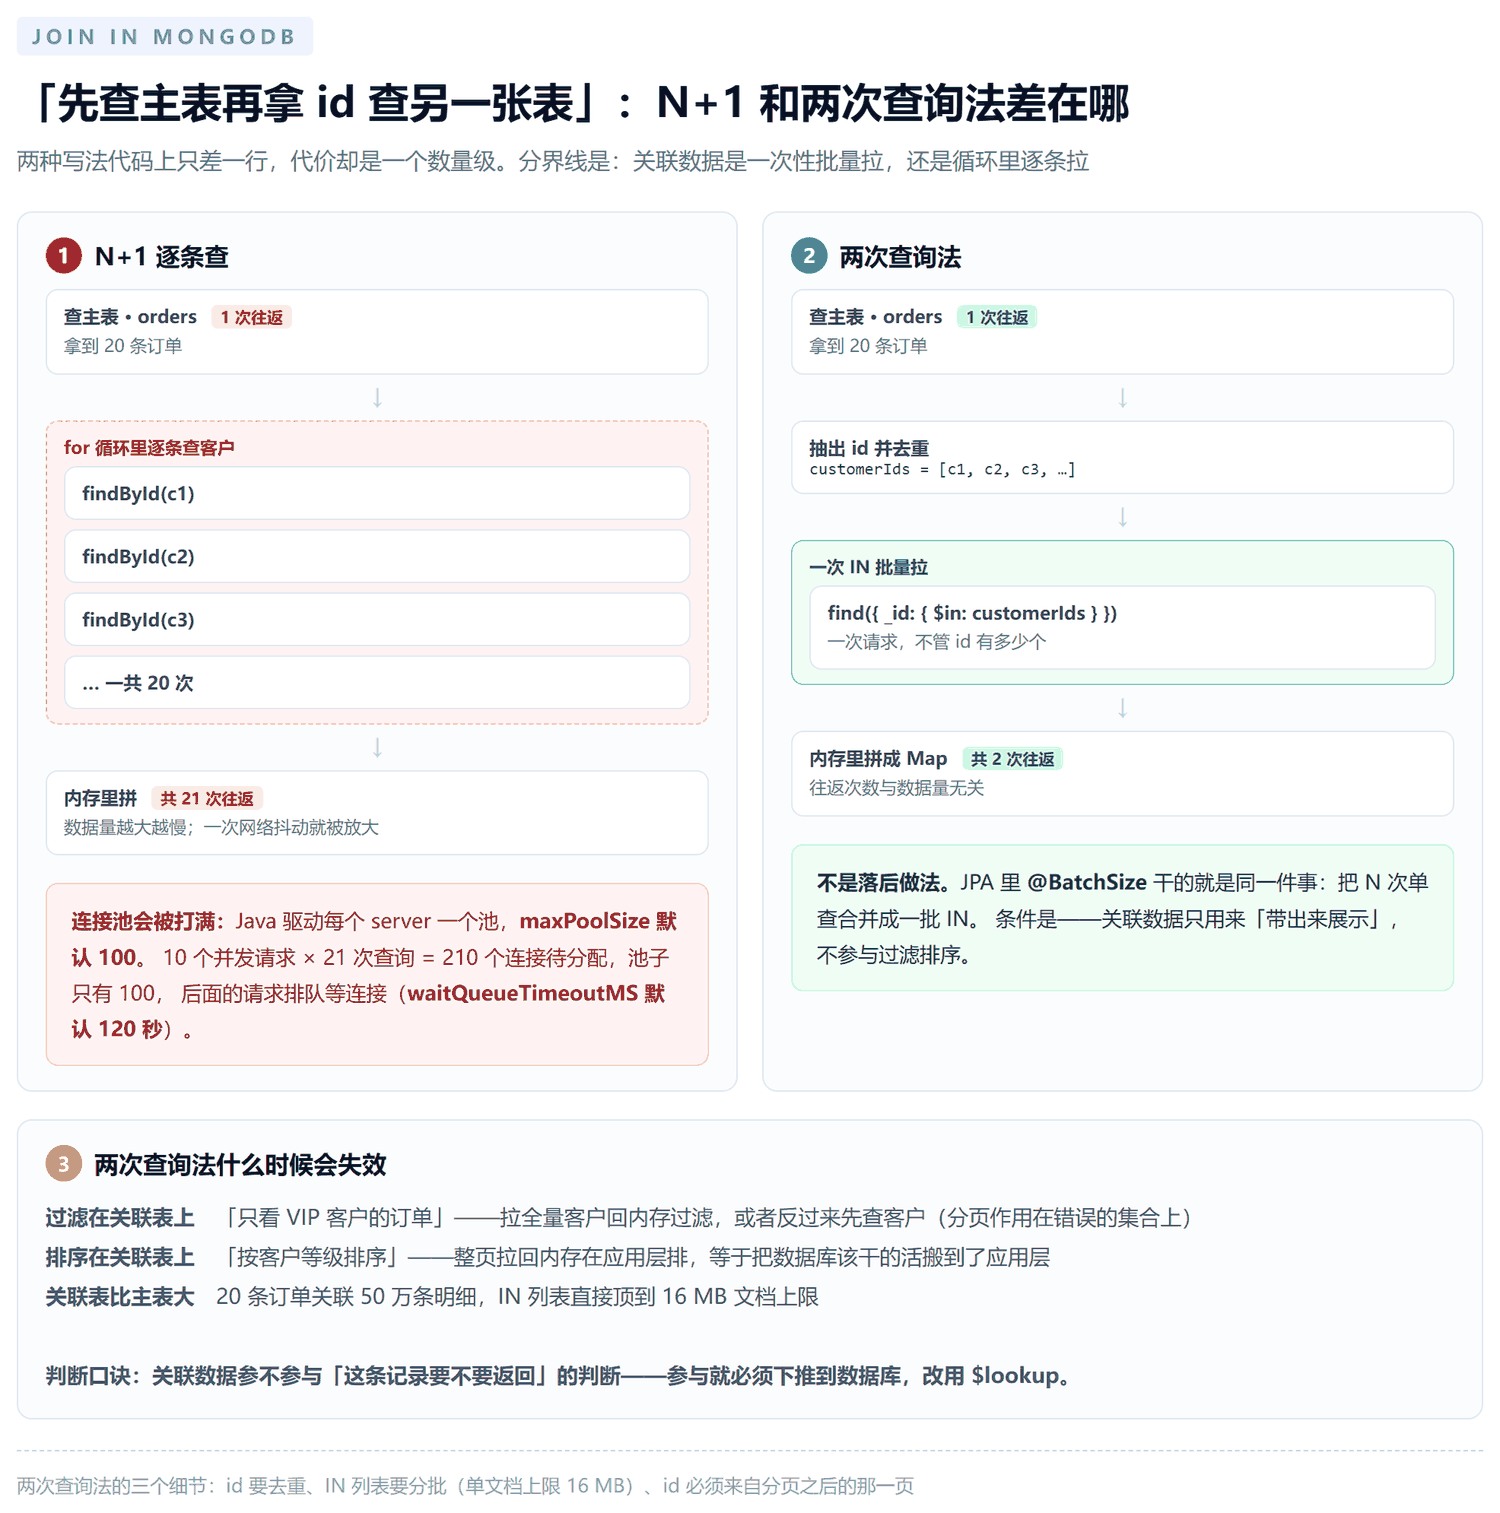
20 条订单就是 21 次网络往返。MongoDB 单次查询在同机房内可能只要 1 毫秒,但 20 次串行下来,一次网络抖动就足以把它放大到秒级。
还有个更隐蔽的代价:连接池。Java 驱动里每个 MongoClient 对拓扑里的每台 server 维护一个连接池,maxPoolSize 默认是 100。用满了,后面的请求就得排队等连接(waitQueueTimeoutMS 默认 120 秒)。
10 个并发请求 × 每请求 21 次查询 瞬间要 210 个连接,池子只有 100
表现 接口平时很快,偶尔卡几十秒,日志里是一堆Timed out while waiting for a connection
根因 不是 MongoDB 慢,是应用把连接池当成了队列
第二种:两次查询法(Two Phase Loading)。先把 id 收齐,一次 IN 批量拉回来,在内存里拼:
List<Order> orders = orderRepository.findByStatus("paid");

List<String> customerIds = orders.stream()
        .map(Order::getCustomerId)
        .distinct()
        .toList();

Map<String, Customer> customerMap = customerRepository.findAllById(customerIds).stream()
        .collect(Collectors.toMap(Customer::getId, Function.identity()));

orders.forEach(o -> o.setCustomer(customerMap.get(o.getCustomerId())));
往返次数固定是 2,和主表有多少条完全无关。
这不是落后做法 它是权衡之后的正确选择。JPA 生态里
@BatchSize干的就是同一件事:把 N 次单查合并成一批IN
什么时候用 关联数据只用来「带出来展示」,不参与过滤排序
什么时候不用 见第 4 节,三个场景直接失效
两种写法的差别只有一行代码,代价却是一个数量级:
3. 两次查询法:怎么写才不是 N+1
如果确定要走两次查询法,下面几个细节决定它是不是退化回 N+1。
一、必须一次 IN 拉,不要循环。这是 N+1 和两次查询法的分界线:
// 一次批量
List<Customer> customers = customerRepository.findAllById(customerIds);

// 等价的原生写法
Query query = Query.query(Criteria.where("_id").in(customerIds));
List<Customer> customers = mongoTemplate.find(query, Customer.class);
二、id 要去重。一个客户有十张订单,不去重的话 IN 列表里就是十份同样的 id,查询本身没错,但列表白白变大,MongoDB 还得去重。
三、id 列表要分批。$in 的数组是 BSON 文档的一部分,单文档上限 16 MB,几万个 id 就可能顶到天花板。经验值是一批几千个,超了就切。
List<String> ids = ...;
List<Customer> all = new ArrayList<>();
for (int i = 0; i < ids.size(); i += 2000) {
    all.addAll(customerRepository.findAllById(
            ids.subList(i, Math.min(i + 2000, ids.size()))));
}
四、id 必须来自分页之后的那一页。这是最容易出错的地方:先全量查一遍主表拿 id,再对 id 列表做分页——分页作用在了错误的集合上,而且每次翻页都要全量重查。正确顺序是先分页主表,再拿这一页的 id 去关联。
五、空列表要短路。$in: [] 匹配不到任何文档,结果本来就是对的,但没必要发这一趟请求。
if (customerIds.isEmpty()) {
    return orders;   // 一次往返都省下
}
六、拼装用 Map,别用嵌套循环。用 List.contains() 在内存里找,是 O(n²),数据量一大就成新的瓶颈。
4. 两次查询法的三个失效场景
两次查询法能用的前提是:关联数据只被「带出来」,不参与任何数据库侧的判断。一旦关联数据要参与过滤、排序或者分页,这条路就断了。
场景一:过滤条件落在关联表上
需求是「只看 VIP 客户的订单」。两次查询法只有两个选择,两个都不好:
拉全量客户回内存过滤 客户表有多少拉多少,为了筛出 20 条订单把几十万条客户拖进内存
反过来先查客户 查客户那一步没法分页,因为limit加在客户查询上;而且客户到订单是反的一对多,翻页语义直接错乱
场景二:排序在关联表上
「按客户等级排序、按客户名称分页」。两次查询法只能把整页拉回内存,在应用层排序——这正是数据库该干的活,而且数据量一大就 OOM。
场景三:关联表比主表大
主表 20 条订单,关联表 50 万条商品明细。两次查询法的 IN 列表要装进 50 万个 id,文档直接顶到 16 MB 上限,而且拉回来的数据量是主表的几十倍。
判断口诀 关联数据只用来显示 → 两次查询法;关联数据要参与过滤或排序 → 必须下推到数据库
5. $lookup:把 join 放回数据库
要把过滤、排序、分页全放在数据库侧做,MongoDB 的工具是聚合管道里的 $lookup。
db.orders.aggregate([
  { $match: { status: "paid" } },
  {
    $lookup: {
      from: "customers",
      localField: "customerId",
      foreignField: "_id",
      as: "customer"
    }
  },
  { $unwind: "$customer" },
  { $match: { "customer.level": "vip" } },
  { $sort: { amount: -1 } },
  { $limit: 20 }
])
和两次查询法比,差别全在「在哪做」:
过滤 在数据库里按
customer.level筛完再返回,不用把不相关的客户拉回内存
排序 在数据库里排完,索引也可能用得上
分页$limit作用在最终结果上,返回多少就是多少
数据量 不受关联表大小影响,这是两次查询法做不到的
Java 侧用 Spring Data 写:
Aggregation aggregation = Aggregation.newAggregation(
        match(Criteria.where("status").is("paid")),
        lookup("customers", "customerId", "_id", "customer"),
        unwind("customer"),
        match(Criteria.where("customer.level").is("vip")),
        sort(DESC, "amount"),
        limit(20));

AggregationResults<OrderView> results = mongoTemplate.aggregate(
        aggregation, "orders", OrderView.class);

List<OrderView> list = results.getMappedResults();
注意 lookup 在 Aggregation 上是静态方法,四参数版本是 lookup(from, localField, foreignField, as),参数全是字符串。unwind 也有三参数版本 unwind(path, includeArrayIndex, preserveNullAndEmptyArrays),下面第 8 节要用。
$lookup 从 MongoDB 5.1 起,from 集合可以是分片集合。
6. $lookup 的三个坑
坑一:被关联的集合必须有索引
官方文档说得很直接:等值匹配的 $lookup 在 from 集合的 foreignField 上有索引时性能才好;没有索引时,官方用词是「likely has poor performance」。
关联
_id天然有索引,不用管
关联业务键skuCode、tenantId这类,必须自己先建索引
没建索引的表现 不报错,只是慢;explain里能看到子查询在做全集合扫描
这条和 02 篇的索引那套是连着的:$lookup 的性能问题,八成是被关联表上缺索引,不是 $lookup 本身慢。
坑二:$unwind 默认是 INNER JOIN 语义
$lookup 的结果放在 as 指定的字段里,而且是个数组——哪怕只匹配到一条,数组里也只有一条。真正能当对象用的是 $unwind。
但 $unwind 的默认行为是:字段缺失、为 null、或者是空数组的文档,整条被丢弃,不会输出。
// 默认:$unwind "$customer" 时,关联不上的订单会凭空消失
{ $unwind: "$customer" }

// LEFT JOIN 语义:关联不上的订单保留,customer 为空
{ $unwind: { path: "$customer", preserveNullAndEmptyArrays: true } }
为什么这是个坑
$lookup+$unwind写出来像 JOIN,但默认行为是 INNER JOIN。要展示「订单 + 客户名,没有客户的订单也要显示」的时候,订单会莫名其妙少一批
排查方向 数据看着少了,先想到preserveNullAndEmptyArrays
坑三:相关子查询是逐条跑的
$lookup 的 pipeline 如果引用了外层文档的字段($$cid),就是相关子查询:外层每输出一条文档,子查询就跑一遍。外层出 1 万条,子查询就跑 1 万次。
不引用外层字段的叫无关子查询,只跑一次然后把结果缓存起来,后续复用。
相关子查询慢 能减少传给
$lookup的文档数量——在$match里把条件卡死,别指望在$lookup之后才筛
官方给的第二招 重新审视数据模型,确认这个查询形态是不是模型本身带来的
7. let + pipeline:等值匹配不够用的时候
localField / foreignField 只能做等值匹配。条件一复杂,就得换成 let + pipeline 写法:
{
  $lookup: {
    from: "customers",
    let: { cid: "$customerId", amt: "$amount" },
    pipeline: [
      {
        $match: {
          $expr: {
            $and: [
              { $eq: ["$_id", "$$cid"] },
              { $gte: ["$creditLimit", "$$amt"] }
            ]
          }
        }
      }
    ],
    as: "customer"
  }
}
let 定义的变量在 pipeline 里用 $$变量名 引用。Java 侧对应的就是 Aggregation.lookup() 那个无参的流式入口:
lookup()
    .from("customers")
    .localField("customerId")
    .foreignField("_id")
    .let(newVariable("cid").forField("customerId"))
    .pipeline(match(ctx -> new Document("$expr",
            new Document("$eq", List.of("$_id", "$$cid")))))
.as("customer")这里有一条最容易踩、也最反直觉的规则,关于索引能不能用上:
$expr 里的比较运算符能用上 from 集合上的索引 但索引只能用于「字段和常量」的比较,
let操作数必须解析成常量
能用索引{ $gte: ["$creditLimit", 1000] }——右边是常量
用不上索引{ $gte: ["$creditLimit", "$$amt"] }——右边是外层文档的值,逐条不同
let 操作数解析为空或缺失 索引同样用不上
multikey、partial、sparse 索引 在$lookup里一律不参与
也就是说:关联条件里只要带了外层文档的字段值,索引就帮不上忙了。这种时候只有两条路——把条件下推成常量,或者改数据模型。
还有一条限制:pipeline 里不能直接访问输入文档的字段,必须通过 let 变量转一手;pipeline 里也不能带 $out 和 $merge。
8. $unwind 与一对多的行数放大
关联到一对多的数据时,$lookup 的 as 里是多个元素的数组,$unwind 摊平之后,行数被放大了。
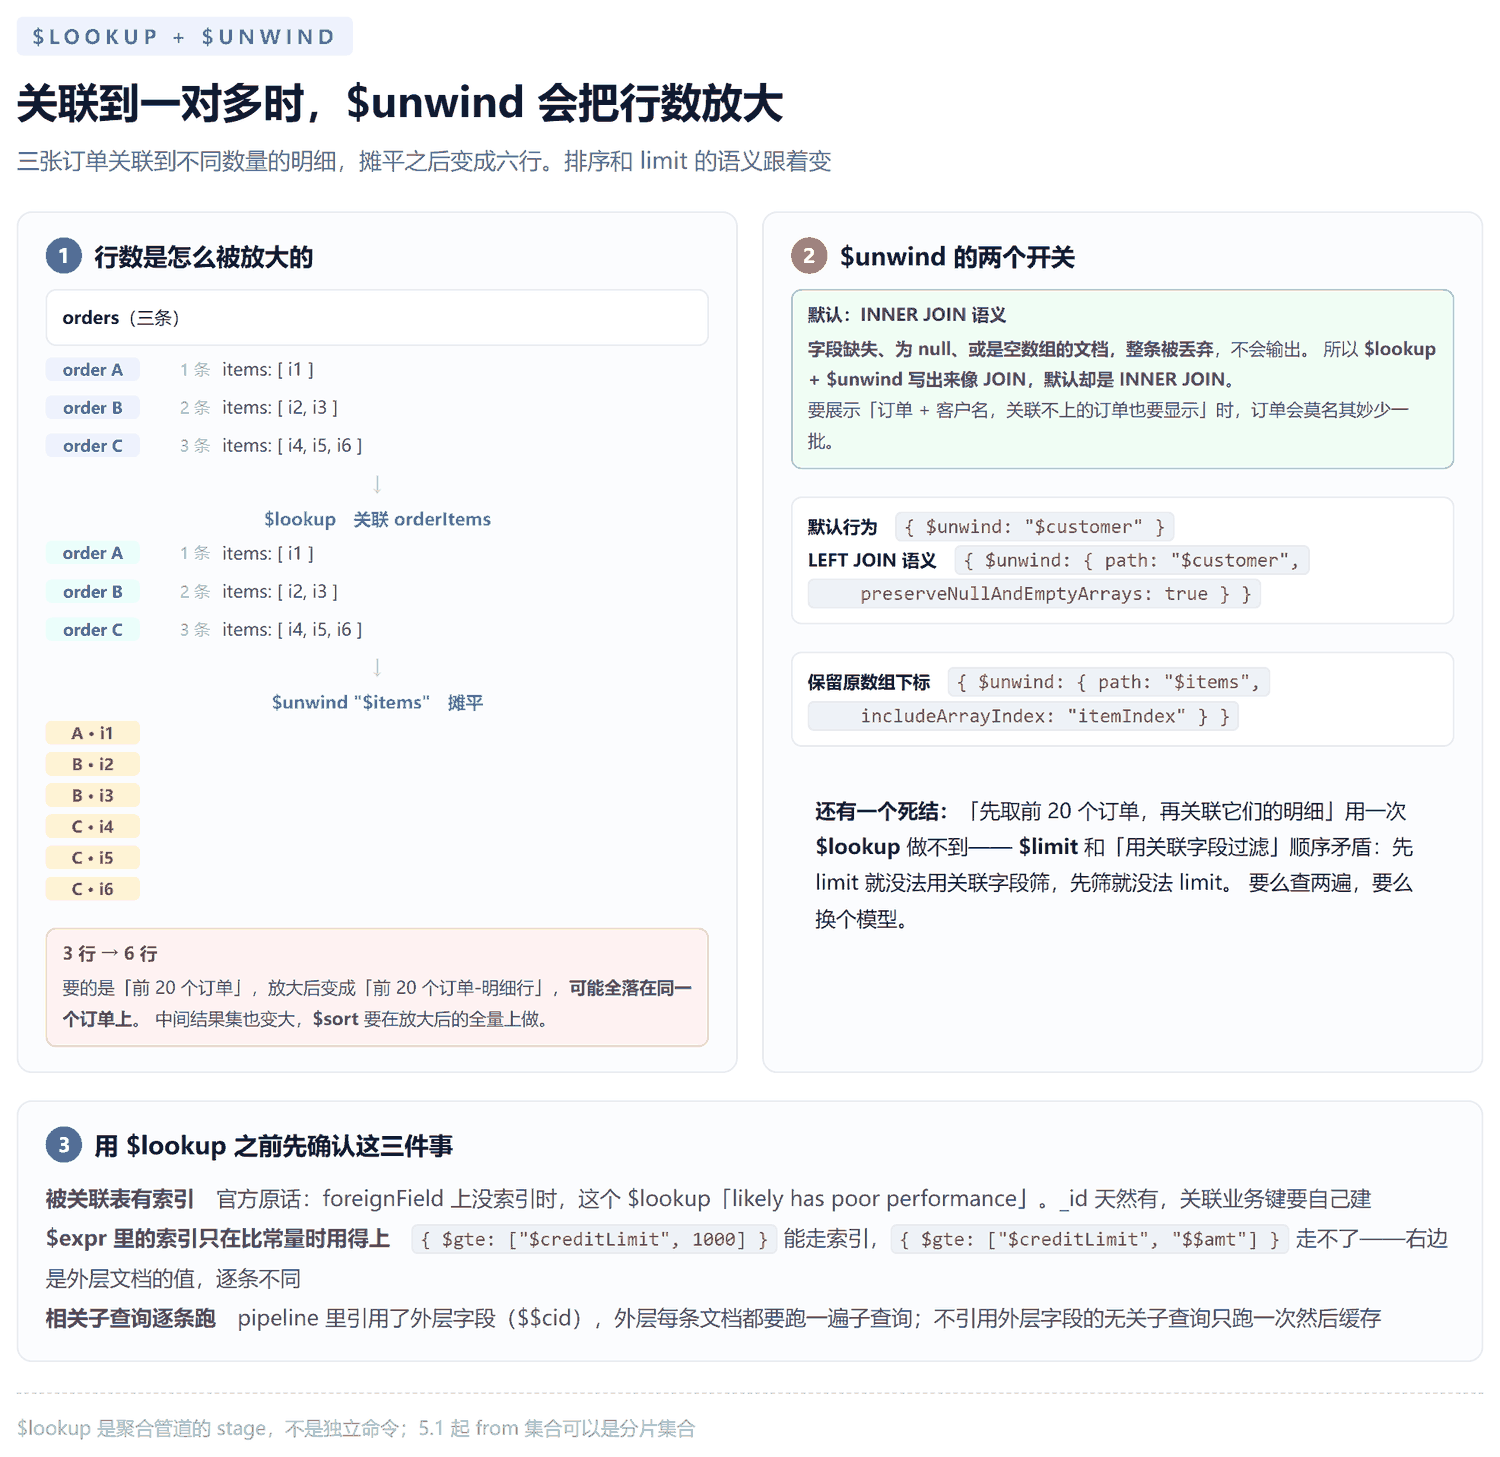
放大之后有两个后果:
排序的语义变了 要的是「前 20 个订单」,放大后变成「前 20 个订单-明细行」,可能全落在同一个订单上
内存和排序开销 中间结果集是放大后的行数,$sort要在全量上做
还有两个参数能控制摊平行为:
{
  $unwind: {
    path: "$items",
    includeArrayIndex: "itemIndex",              // 保留原数组下标
    preserveNullAndEmptyArrays: true              // 空数组的文档也保留
  }
}
「先取前 20 个订单,再关联它们的明细」这种需求,用一次 $lookup 做不到——因为 $limit 和过滤在关联字段上的 $match 顺序是矛盾的:先 $limit 就没法用关联字段过滤,先过滤就没法 $limit。真要做,要么查两遍(先取 id 再关联),要么换个模型。
9. 怎么发现 N+1:慢查询日志
N+1 在代码里很难看出来,因为循环写得很自然。得让数据库把现场记录下来。
// 打开分析器
db.setProfilingLevel(2)

// 看最近的查询
db.system.profile.find().sort({ ts: -1 }).limit(20)

// 用完关掉
db.setProfilingLevel(0)
level 2 全量记录,写进 profiler 和 diagnostic log
level 1 只记超过slowms的慢操作
level 0 关闭
默认是关的 不主动开就什么都没有
官方给的警告要认真看:profiling 会降低性能,而且会把未加密的查询数据写进 system log。生产环境开之前先想清楚这两条。
mongos 上开不了
mongos没有集合可写,database profiler 用不了,只能写 diagnostic log
5.0 起的变化 profiler 的level、slowms、sampleRate、filter的改动都会记进 log 文件
Atlas Infinite 只支持 level 为 0
看什么特征:同一个 ns(命名空间)在很短时间窗口里出现大量重复的查询,而且参数只差一个 id——这就是 N+1 的指纹。
10. 最终选型:嵌入、引用、还是关联
把三条路放一起,按优先级往下走:
第一步:能不能嵌入? 关联数据总跟主数据一起读写、数量有上限、单独拿出来没意义 → 嵌入,读取零成本,一次查询搞定
第二步:两次查询法够不够? 关联数据只用来带出来展示,不参与过滤排序 → 两次查询法,固定两次往返
第三步:上 $lookup 关联数据要参与过滤、排序、分页,或者关联表比主表大 →$lookup,把判断下推到数据库
官方对 $lookup 的态度也印证这个顺序——文档里写着:为了减少对 $lookup 的依赖,可以考虑用嵌入的数据模型,把关联数据存在同一个集合里。
最后补一条容易被忽略的:如果关联表很大,考虑「引用 + 冗余关键字段」的折中。比如订单里不只存 customerId,还冗余一份 customerName 和 customerLevel。列表页只按这两个冗余字段展示,完全不用关联;真要查客户详情时再按 id 查一次。这种「读多写少」的场景,冗余的收益远大于成本。
💡 补充:关联查询这一块最容易被忽略的其实是「两次查询法」和「N+1」的区别。很多团队看到「在内存里拼数据」就当成反模式,其实只要做到了「一次 IN 批量拉、往返次数与数据量无关」,它就是标准解法,很多 ORM 在背后也是这么干的。真正要警惕的是循环里逐条查,以及把本该下推到数据库的过滤和排序搬到了应用层。判断标准就一条:关联数据参不参与「这条记录要不要返回」的判断——参与就必须下推,不参与就可以在内存里拼。
🔥 一句话总结:关联查询没有银弹,顺序是先想能不能嵌入,再看两次查询法够不够,最后才上 $lookup;用了 $lookup 就要记住三件事——被关联表要有索引、$unwind 默认是 INNER JOIN 语义、$expr 里的索引只在比常量时才用得上。