
03-MyBatis 分页:三种写法与一个真实项目的落地
📝 笔记摘要:分页的 SQL 在哪一层被改写
分页看着只是一句 LIMIT,但「谁来加这个 LIMIT」有三种完全不同的做法:自己在 SQL 里写、用拦截器改写、用框架的 API 包一层。三种做法的 SQL 长得不一样,性能也不一样,而最常见的线上事故——startPage 调了却没生效——就出在没搞清楚自己用的是哪一种。
这篇按 2026 年的现状写:PageHelper 的 starter 是 4.1.1,MyBatis-Plus 的分页插件在 3.5.9 之后从主包拆了出去,要单独引 mybatis-plus-jsqlparser。底层原理在 MyBatis 基础,插件链的挂法在 MyBatis-Plus,这里不重复,只说分页这一件事。
这篇的结构
1. 分页发生在哪一层
2. 原生 LIMIT:count 查询和深分页的代价
3. MyBatis-Plus 分页插件
4. PageHelper
5. 一个真实项目里的分页写法
6. 三个高频坑
7. 插件生态速览
1. 分页发生在哪一层
同一句「查第 2 页、每页 5 条」,三种写法最后到数据库的 SQL 完全不同。
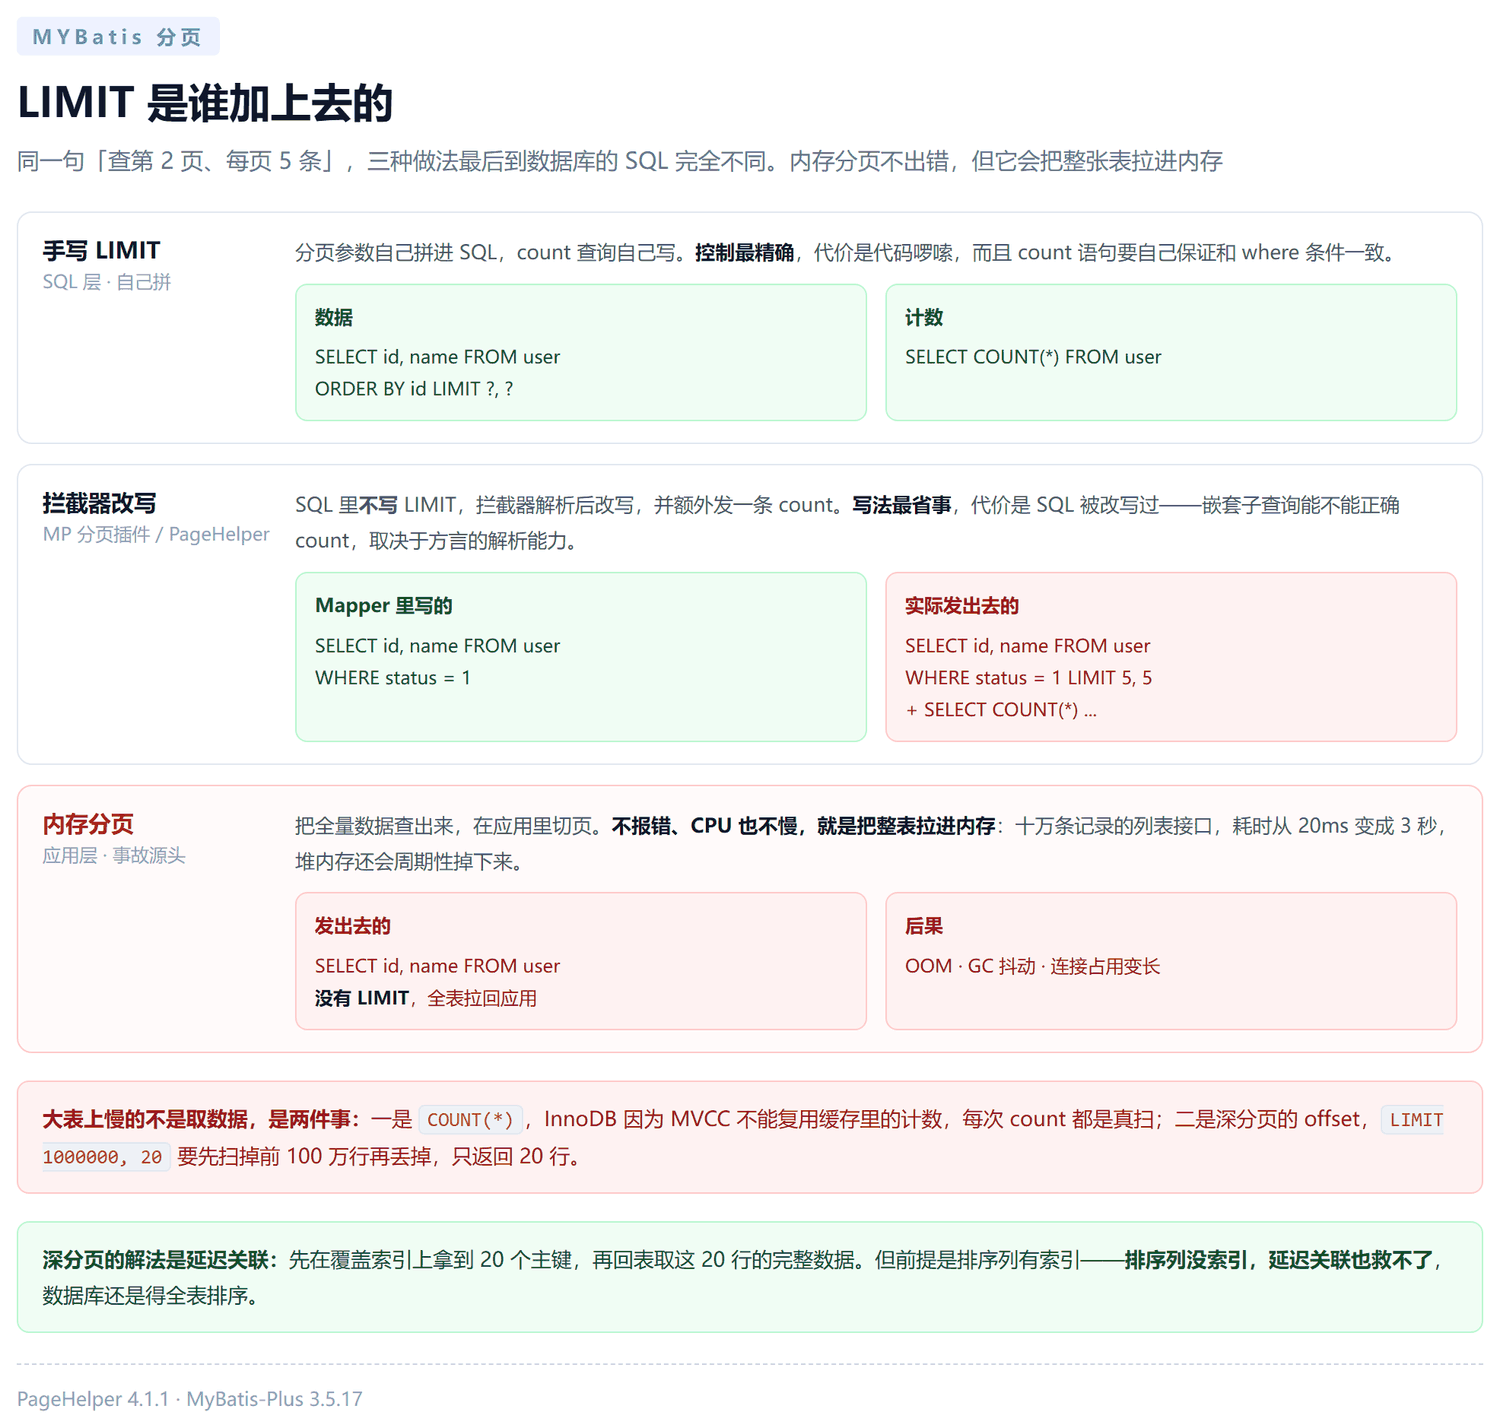
手写 LIMIT 分页参数自己拼进 SQL,count 查询自己写。控制最精确,代码最啰嗦
拦截器改写 SQL 里不带 LIMIT,拦截器解析 SQL 后改写,并额外发一条 count。写起来最省事,代价是 SQL 被改写过
内存分页 把全量数据查出来在应用层切。数据量小的时候无所谓,几万条就是事故
三种里最该警惕的是内存分页。它不报错、不慢在 CPU 上,就是把全表拉进内存:十万条记录的列表接口用内存分页,接口耗时从 20ms 变成 3 秒,堆内存还会周期性掉下来。排查这种问题不能只看代码,要看实际发出去的 SQL 有没有 LIMIT。
2. 原生 LIMIT:count 查询和深分页的代价
最朴素的分页,两条 SQL:
-- 数据
SELECT id, user_name, age FROM user
ORDER BY id
LIMIT ?, ?;

-- 总条数
SELECT COUNT(*) FROM user;
能跑,但有两个问题。
count 查询在大表上很贵
COUNT(*)要扫数据。InnoDB 因为 MVCC 不能复用二级缓存的计数,每次 count 都是真扫。千万级表上这一条就能拖垮接口
深分页越翻越慢LIMIT 1000000, 20要先扫掉前 1000000 行再丢掉,只返回 20 行。offset 越大越慢
深分页的解法是延迟关联——先在覆盖索引上拿到主键,再回表取数据:
-- 慢:扫 1000020 行,取 20 行
SELECT * FROM user ORDER BY id LIMIT 1000000, 20;

-- 快:覆盖索引扫 1000020 个 id,取 20 个 id,再回表 20 次
SELECT u.* FROM user u
JOIN (
    SELECT id FROM user ORDER BY id LIMIT 1000000, 20
) t ON u.id = t.id;覆盖索引扫描比回表便宜得多,深分页能快一个数量级。前提是排序列有索引。排序列没有索引,延迟关联也救不了——数据库还是得全表排序。
count 查询也有优化空间:用估算值代替精确值。很多列表页只需要「大约多少条」来渲染分页器,精确到个位没必要:
精确 count
SELECT COUNT(*) FROM user WHERE status = 1,给用户显示第 1 / 892 页
估算 count 用EXPLAIN的 rows 或者统计信息表的估算值,显示「第 1 / 约 900 页」,翻页不卡
数据量大、又要精确总数的场景,可以做计数缓存:把 count 结果按条件维度缓存起来,定时刷新。这套东西在 MySQL 报表实战 里有更完整的展开——同环比报表里怎么把几十个指标各算各的再横向拼成一行,和分页计数是同一类问题:结果能不能复用。
3. MyBatis-Plus 分页插件
MP 的分页插件做两件事:改写 SQL 加 LIMIT,再发一条 count 查询。配置要两个前提。
一是引依赖(3.5.9 起必须单独引):
<dependency>
    <groupId>com.baomidou</groupId>
    <artifactId>mybatis-plus-jsqlparser</artifactId>
    <version>3.5.17</version>
</dependency>二是注册内部拦截器,而且分页要放最后:
@Bean
public MybatisPlusInterceptor mybatisPlusInterceptor() {
    MybatisPlusInterceptor interceptor = new MybatisPlusInterceptor();
    interceptor.addInnerInterceptor(new PaginationInnerInterceptor(DbType.MYSQL));
    return interceptor;
}
然后就能用了:
Page<User> page = new Page<>(2, 5);
IPage<User> result = userMapper.selectPage(page, wrapper);

result.getRecords();   // 当前页数据
result.getTotal();     // 总条数
result.getPages();     // 总页数
result.getCurrent();   // 当前页码
Page 的两个参数是页码和每页条数,注意不是 offset:new Page<>(2, 5) 是第 2 页、每页 5 条,对应 LIMIT 5, 5。
插件有五个可调属性:
overflow 默认
false。页码超出总页数时返回空列表;设成true则返回最后一页
maxLimit 单页条数上限。不设的话前端传size=999999就能把整表拉走,这个参数要设
dbType 方言类型,单库项目建议显式写DbType.MYSQL,多库时不写会按连接自动猜
dialect 自定义方言实现
optimizeCountSql 自动优化 count SQL,能省掉不必要的子查询
排序字段是另一个注入入口。插件自己发的 count 语句里,ORDER BY 会被优化掉,但数据查询里的排序字段是原样拼进 SQL 的:
<!-- 危险 -->
ORDER BY ${sortColumn} ${sortDirection}官方文档里明确写了这条:OrderItem 的 column 属性建议不要让前端传入,如果一定要允许前端传,必须做白名单校验:
private static final Set<String> SORTABLE = Set.of("id", "created_at", "name");
private static final Set<String> DIRECTIONS = Set.of("asc", "desc");

String column = SORTABLE.contains(req.getSortColumn()) ? req.getSortColumn() : "id";
String direction = DIRECTIONS.contains(req.getSortDirection()) ? req.getSortDirection() : "desc";
4. PageHelper
PageHelper 的思路和 MP 分页插件一样,也是拦截器改写 SQL,区别在调用方式:它不改变方法的返回类型,而是用一个 ThreadLocal 记住「下一次查询要分页」。
坐标:
<dependency>
    <groupId>com.github.pagehelper</groupId>
    <artifactId>pagehelper-spring-boot-starter</artifactId>
    <version>4.1.1</version>
</dependency>
用法就一行,位置很关键:
PageHelper.startPage(currentPage, itemsPerPage);
List<EmployeeListPageVO> list = mapper.queryEmployeeList(condition);
startPage 之后紧接着的那一次查询会被改写,返回值是 Page 的子类(它继承自 ArrayList),所以类型声明成 List 也能编译,但拿不到总数。
想拿总数就得强转成 Page:
Page<EmployeeListPageVO> page = (Page<EmployeeListPageVO>) mapper.queryEmployeeList(condition);

long total = page.getTotal();      // 总条数
int pages = page.getPages();       // 总页数
List<EmployeeListPageVO> rows = page.getResult();  // 当前页数据
这一行强转是 PageHelper 用法里最容易出问题的地方,编译期完全查不出来,写错了运行时就 ClassCastException。
提示:
startPage之后如果中间插了别的查询(记日志的、查权限的),分页会作用到那一条上去,返回的列表页数据反而没分页。这是最难查的一类问题。
5. 一个真实项目里的分页写法
这套写法来自一个多租户的组织架构项目,PageHelper 负责分页,PageVO 负责把结果包成前端要的结构。
Service 层:
public PageVO<EmployeeListPageVO> getEmployeeListPage(EmployeeListPageDTO u) {
    PageVO<EmployeeListPageVO> pageResult = new PageVO<>();

    PageHelper.startPage(u.getCurrentPage(), u.getItemsPerPage());

    Page<EmployeeListPageVO> page = (Page<EmployeeListPageVO>) mapper
            .queryEmployeeByEntityId(u.getEntityId(), SystemContext.getCompanyId());

    if (page != null && CollectionUtils.isNotEmpty(page.getResult())) {
        pageResult.setTotal((int) page.getTotal());
        pageResult.setList(page.getResult());
        pageResult.setTotalPages(page.getPages());
    }
    return pageResult;
}
三个细节值得单独说:
startPage 和查询之间不能插别的 SQL 这行代码和下一行查询之间隔着一次强制类型转换,转换本身不查库,安全;但只要中间多一次查询,分页就跑了
空结果也要把结构填回去 只设置total和totalPages,list保持空集合。返回null的 list 会让前端判空逻辑出错
总数从page.getTotal()取,不是getResult().size()后者是当前页条数,页数一多就完全不对
Mapper 接口,多参数必须用 @Param:
public interface EmployeeMapper extends BaseJdbcMapper<EmployeePO, Long> {

    List<EmployeeListPageVO> queryEmployeeByEntityId(
            @Param("entityId") Long entityId,
            @Param("companyId") Long companyId);
}
这里踩过一个坑:多参数方法不加 @Param,XML 里就取不到 #{entityId},报 BindingException: Parameter 'entityId' not found。加上 @Param 之后参数名才是 XML 里能用的那个名字。接口还继承了 BaseJdbcMapper,单表 CRUD 不用写。
XML 部分,条件写在子查询里:
<select id="queryEmployeeByEntityId"
        resultType="com.example.user.model.vo.EmployeeListPageVO">
    SELECT id, identity_card_name, head_pic_url
    FROM employee e
    WHERE e.id IN (
        SELECT udu.user_id
        FROM u_department_user udu
        JOIN u_department ud ON ud.is_deleted = 0
            AND ud.id = udu.department_id
        WHERE ud.entity_id = #{entityId}
          AND ud.entity_type = 2
          AND ud.is_deleted = 0
          AND ud.company_id = #{companyId}
    )
    AND e.id IN (
        SELECT uur.user_id
        FROM u_user_role uur
        JOIN u_role ur ON ur.is_deleted = 0
            AND ur.id = uur.role_id
            AND ur.company_id = #{companyId}
        WHERE ur.platform_id = 5
          AND uur.is_deleted = 0
          AND uur.company_id = #{companyId}
    )
    AND e.is_deleted = 0
    AND e.company_id = #{companyId}
</select>
多租户系统的分页查询有三个绕不开的约束:
每层子查询都要带
company_id漏掉一层就是数据越权。这不是性能问题,是安全问题
软删除条件is_deleted = 0也要带 同样,漏了会查出已删除的记录
count 查询由插件生成 插件会把原 SQL 包一层做 count,嵌套子查询的 SQL 能不能正确 count,取决于各方言的解析能力。复杂查询上线前要把实际发出去的 count SQL 抓出来看
最后一条是重点:分页插件生成的 count 语句你看不到,只能从日志里翻。打开 SQL 日志,确认 count 语句扫的是哪张表、用了什么条件,比在代码里猜靠谱得多。
6. 三个高频坑
startPage 调了但没分页
startPage和查询之间有别的查询,或者查询在别的线程里。startPage用 ThreadLocal 传参,异步线程里取不到
count 查询特别慢 count 语句对大表做全扫。先看它扫的是哪张表、有没有走索引;条件里带函数或隐式类型转换,索引就用不上
页码超出范围返回空 前端算出来的总页数和实际对不上,通常是数据在翻页过程中变了。要么接受空页,要么把页码夹到有效范围
还有两个不是坑、但值得知道的差异:
count 会不会被缓存 MP 插件和 PageHelper 都不缓存 count 结果,每次分页都查一次。这就是为什么大表列表接口的慢点常常在 count 上而不在数据查询上
count 和 limit 查到的不一定同时 两条 SQL 不是一个事务快照的话,中间数据变了,总数和当前页对不上。报表类需求要一致,就自己把两条 SQL 放进同一个事务
7. 插件生态速览
MyBatis 的分页和增强这块,常见的几条路:
PageHelper 最老牌的第三方分页,
com.github.pagehelper:pagehelper-spring-boot-starter,当前4.1.1。用法是startPage+ ThreadLocal,多租户项目里用得多
MyBatis-Plus 内置分页PaginationInnerInterceptor,当前3.5.17,需要额外引mybatis-plus-jsqlparser。返回IPage对象,类型更清楚
通用 Mapper 框架 把单表 CRUD 再抽象一层,BaseMapper那种接口直接继承就能用。MyBatis-Plus 是其中影响最大的一种,另有 tk.mybatis、MyBatis-Flex 等
动态表名 / 字段 多租户、分表场景要动态改表名,MP 提供DynamicTableNameInnerInterceptor,和分页拦截器一样挂在插件链上
选型上有个务实的判断:一个项目只留一套。MP 的分页插件和 PageHelper 同时用,两个拦截器都会改写 SQL,结果是分两次页或者直接报错。选了就别混。
提示:
fastmybatis也是这一路的——DURC 框架下的通用 Mapper 方案,坐标是net.oschina.durcframework:fastmybatis-spring-boot-starter,当前2.11.0,MIT 协议,底层就是 MyBatis3.5.9。它和 MP 解决的问题高度重叠,选一个就行。评估这类框架时重点看两件事:它怎么生成 SQL(能不能生成你需要的形状)、它拦不拦得住你手写的 SQL(有些框架要求所有查询都走它的方法,手写 XML 反而不好用)。
💡 补充:分页真正难的地方从来不是「怎么翻页」,是「翻页的时候数据在变」。列表页展示第 2 页,排序字段的值恰好被改了,用户看到的第 2 页和第 3 页会重叠或漏数据。业务上能接受就按现状做,不能接受就得用游标分页——记住上一页最后一条的排序键,下一页从它往后取,不要用 offset。代价是不能跳页,得改交互。
🔥 一句话总结:分页三种做法,手写 LIMIT 最可控但要自己写 count,MP 插件和 PageHelper 都在拦截器层改写 SQL 并额外发一条 count,内存分页是事故源头;大表慢在 count 和深分页 offset 上,排序字段永远要走白名单。