
DataX 离线数据同步
📝 笔记摘要:DataX 离线数据同步
DataX 是阿里开源的离线数据同步工具,一个 JSON 文件就是一个同步任务,不依赖第三方调度平台,命令行直接跑。这篇按四块串起来:它是什么、能同步什么、任务怎么写和怎么跑、datax-web 怎么部署和使用。
中间穿插了几处踩过的坑:reader 和 writer 的 jdbcUrl 类型不一样,splitPk 选错会让速度上不去,column 用通配符迟早出事。
1. DataX 是什么
DataX 是阿里巴巴内部广泛使用的离线数据同步工具,也是阿里云 DataWorks 数据集成模块的开源版本,Apache License 2.0 协议。
源码在 github.com/alibaba/DataX,编译需要 JDK 1.8,预编译包从仓库的 releases 直接下。它本质是一个跑在命令行里的 Java 程序:读一份 JSON 配置,从数据源拉数据,塞进内存缓冲,再批量写到目标端。
离线是它的定位前提,不是缺陷
全量同步、定时增量同步、日常抽数,都是离线场景
要求秒级实时同步的场景,DataX 不合适,那是 Flink CDC、Canal 的活
一条任务是两个插件的组合
reader 从哪儿读、writer 往哪儿写,两个插件拼起来才是一条链路
同一条任务里 reader 和 writer 可以不是同一种类型,MySQL 读、ClickHouse 写没问题
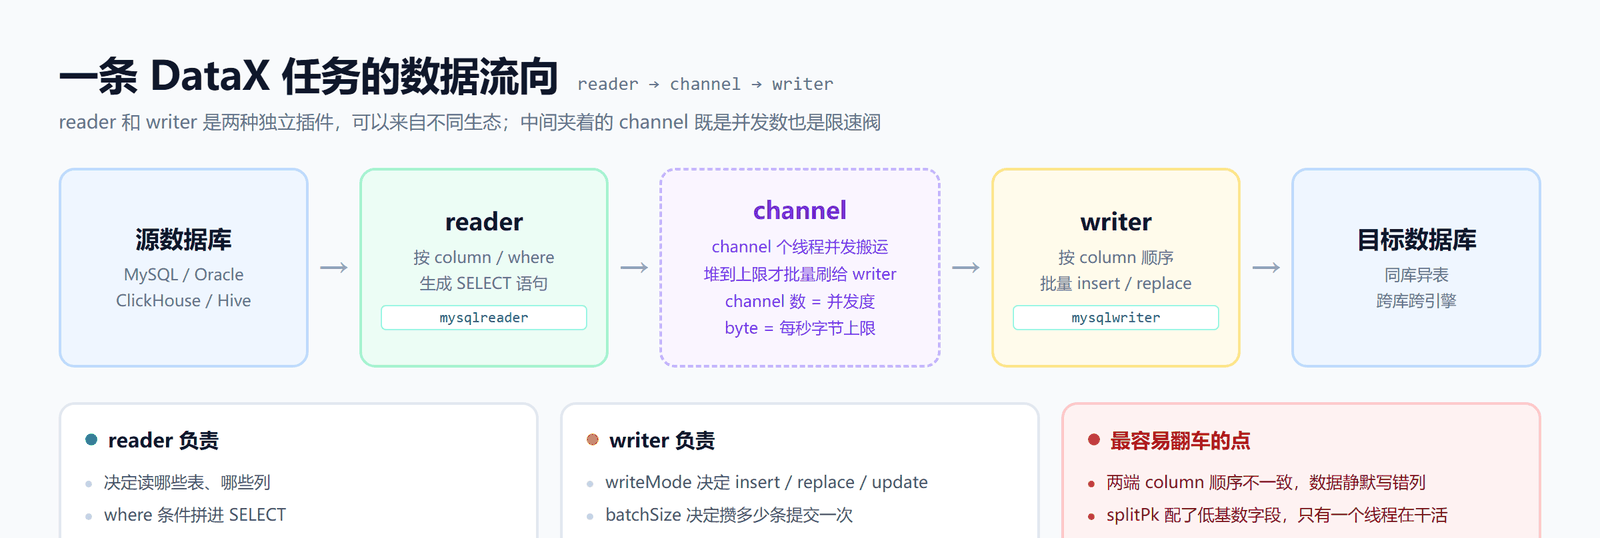
中间那个 channel 是最容易被误解的部分。它不是「连接」,reader 和 writer 之间本来就没有持久连接。channel 是一块内存缓冲,reader 往里塞、writer 从里取,塞满了或者到时间了才批量刷一次。channel 的数量就是并发度,也是限速阀。
2. 能同步什么
插件体系覆盖的主流数据源:
关系型数据库 MySQL、Oracle、PostgreSQL、SQLServer、OceanBase、DRDS、Kingbase、达梦通用 RDBMS
列式与数仓 ClickHouse、Apache Doris、StarRocks、Hive、Greenplum、GaussDB
NoSQL MongoDB、HBase、Cassandra、Neo4j、TDengine、TSDB、OpenTSDB
文件与存储 HDFS、FTP、TxtFile、OSS、Tablestore
阿里云数仓 MaxCompute、Hologres、AnalyticDB、Datahub
每个插件分 reader 和 writer 两半,方向支持不对称。比如 Neo4j 只能读不能写,Greenplum 只有 reader 没有 writer。写任务前先看目标数据源到底有没有对应的 writer 插件。
3. 怎么用
3.1 一个 JSON 文件就是一个任务
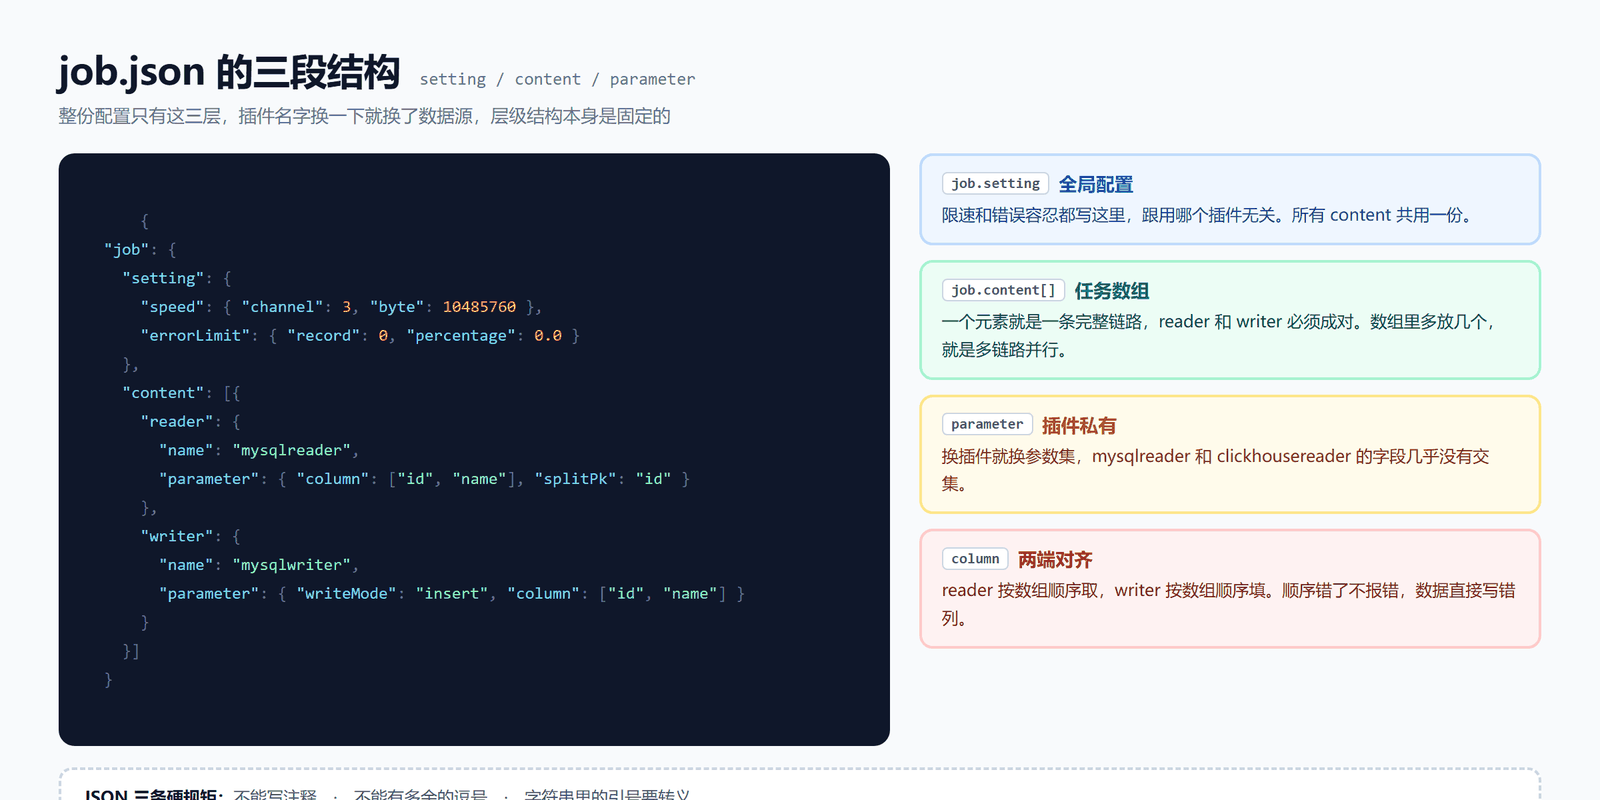
DataX 没有自己的任务模型,全部靠 job.json 描述。整份配置是固定的三层嵌套,换数据源只是换 name 那一个字段:
拿到包解压后目录结构是:
bin/datax.py、datax.py.bat、localjob2dist.py
conf/示例配置,job.json就是从这儿复制改的
plugin/插件目录,每个插件一个文件夹,带plugin.json和 jar 包
plugin_reader/pluginwriter/单独抽出来的读写插件
core.txt引擎和插件的版本号,用来校验是否匹配
Job 的骨架固定三段:
job.setting任务的全局配置,限速和错误容忍都写这里
job.content数组,真正的任务体,一个元素就是一条链路
一个reader加一个writer,配对出现
content[i].parameter插件自己的参数,不同插件完全不同
3.2 第一个 MySQL 到 MySQL 的任务
建一个 mysql_to_mysql.json:
{
  "job": {
    "setting": {
      "speed": {
        "channel": 3,
        "byte": 10485760
      },
      "errorLimit": {
        "record": 0,
        "percentage": 0.0
      }
    },
    "content": [
      {
        "reader": {
          "name": "mysqlreader",
          "parameter": {
            "username": "root",
            "password": "root",
            "column": ["id", "user_name", "age", "city"],
            "where": "id > 1000",
            "splitPk": "id",
            "connection": [
              {
                "table": ["user"],
                "jdbcUrl": [
                  "jdbc:mysql://127.0.0.1:3306/demo?useSSL=false&useUnicode=true&characterEncoding=utf8"
                ]
              }
            ]
          }
        },
        "writer": {
          "name": "mysqlwriter",
          "parameter": {
            "writeMode": "insert",
            "username": "root",
            "password": "root",
            "batchSize": 1024,
            "column": ["id", "user_name", "age", "city"],
            "session": ["set session sql_mode='ANSI'"],
            "preSql": ["truncate table user_copy"],
            "connection": [
              {
                "table": ["user_copy"],
                "jdbcUrl": "jdbc:mysql://127.0.0.1:3306/demo?useSSL=false&useUnicode=true&characterEncoding=utf8"
              }
            ]
          }
        }
      }
    ]
  }
}
JSON 不支持注释,也别加末尾多余的逗号
想写备注就另存一个.txt,别往 JSON 里塞
column 两边的顺序必须一一对应
reader 按数组顺序取字段,writer 按数组顺序填字段
reader 里是id, name, age,writer 里写成id, age, name,数据会静悄悄写错列,不报错
Windows 下双击 bin\datax.py.bat,或者命令行:
cd bin
python datax.py ..\mysql_to_mysql.json
Linux 下:
./bin/datax.py /opt/datax/job/mysql_to_mysql.json正常结束会打一份汇总:
2024-03-19 17:01:46.568 [job-0] INFO JobContainer - 任务启动时刻 : 2024-03-19 17:00:34
任务结束时刻 : 2024-03-19 17:01:46
任务总计耗时 : 71s
任务平均流量 : 1.38MB/s
记录写入速度 : 9958rec/s
读出记录总数 : 697071
读写失败总数 : 0
看这两行就够:读写失败总数非 0 要立刻查,记录写入速度是调优的起点。
3.3 setting 里的两个开关
"speed": {
    "channel": 3,
    "byte": 10485760
},
"errorLimit": {
    "record": 0,
    "percentage": 0.0
}
下面这张速查卡把常用参数的取值和影响集中在一页,调参时对着看:
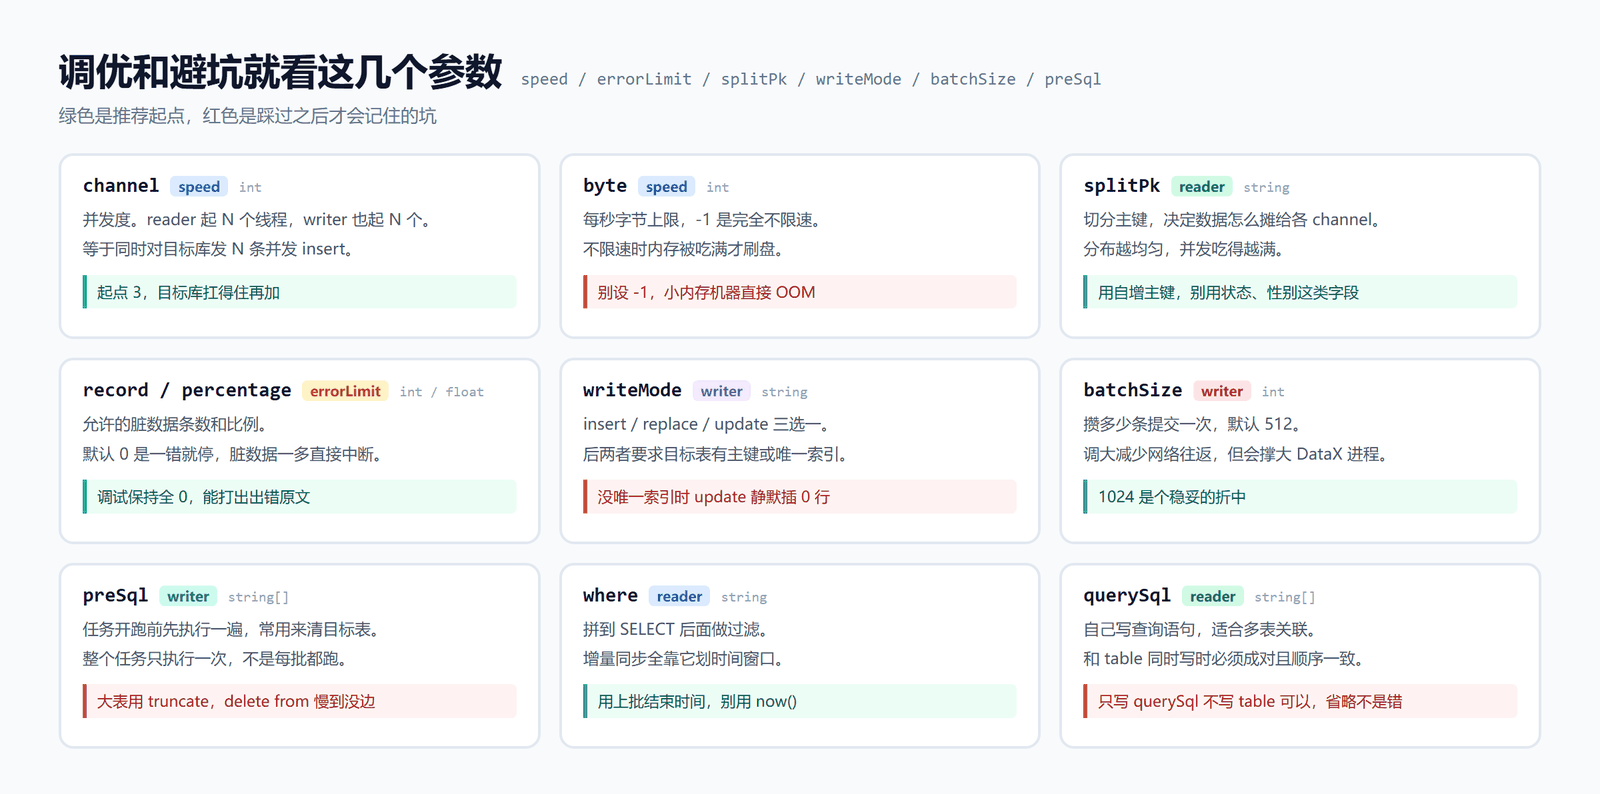
channel channel 数量,也就是并发度
reader 起 channel 个线程,writer 也起 channel 个
channel 不是越多越好,等于同时在目标库跑 channel 条并发 insert
常见起点 3,MySQL 从库扛得住再加
byte 每秒字节上限,-1 表示不限速
不限速时 DataX 会把内存吃满再刷,机器内存不够就 OOM
小内存机器设 5 MB/s 左右,大内存机器设 20 MB/s
errorLimit.record 允许的脏数据条数
errorLimit.percentage 允许的脏数据比例,0.0 是零容忍
调试期保持全 0,能把问题数据一条不漏地打出来
上了生产再放开,比如允许万分之一
提示:
errorLimit默认配置是「一条错就全停」,脏数据一多任务直接中断。想让它跳过脏数据继续跑,必须显式写这两个值,光设channel没用。
3.4 mysqlreader 参数
{
    "name": "mysqlreader",
    "parameter": {
        "username": "root",
        "password": "root",
        "column": ["id", "user_name"],
        "where": "create_time >= '2026-01-01'",
        "splitPk": "id",
        "connection": [
            {
                "table": ["user"],
                "jdbcUrl": ["jdbc:mysql://ip:3306/demo"]
            }
        ]
    }
}
column 要读的列,可以写 SQL 函数做转换
写*合法,但源表加字段那天任务就可能对不上
要全部列就显式列出来,长期维护反而省事
where 过滤条件,会拼到 SELECT 后面
splitPk 切分主键,决定怎么分片并发读
jdbcUrl 这里是数组,可以配多个做容灾
提示:
jdbcUrl传数组时 DataX 会依次连接,前一个连不上自动试下一个,可以顺手配上只读从库地址做容灾。但 writer 的 jdbcUrl 只能是字符串,官方明确不支持一个库配多个地址,写反了直接报解析错误。
3.5 mysqlwriter 参数
{
    "name": "mysqlwriter",
    "parameter": {
        "writeMode": "insert",
        "username": "root",
        "password": "root",
        "batchSize": 1024,
        "column": ["id", "user_name"],
        "session": ["set session sql_mode='ANSI'"],
        "preSql": ["truncate table user_copy"],
        "connection": [
            {
                "table": ["user_copy"],
                "jdbcUrl": "jdbc:mysql://ip:3306/demo"
            }
        ]
    }
}
writeMode
insert插入,主键冲突直接报错
replace替换,冲突时删掉旧行插新行,会触发级联删除
update更新,冲突时只更新字段,不存在的行插不进去
preSql 任务开始前执行一次,常用来清空目标表
大表用truncate,别用delete from,后者慢到能让人等一天
batchSize 批量提交条数,默认 512
调到 1024 吞吐能涨一截,再往上容易把 DataX 自己撑爆
session 建连后执行的 SQL,sql_mode='ANSI'能绕开一部分字段校验
注意:
writeMode设成replace或update时,目标表的主键或唯一索引必须存在。目标表没有唯一约束,update会一条都插不进去,而且不报错,只是行数为 0。
3.6 多表关联
要把两张表 join 后写到一张宽表,用 querySql:
"connection": [
    {
        "jdbcUrl": ["jdbc:mysql://ip:3306/demo"],
        "querySql": [
            "select u.id, u.user_name, c.city_name from user u left join city c on u.city_id = c.id where u.id > 1000"
        ]
    }
]
有个坑很容易踩:
注意:
querySql和table可以同时配,但 必须成对出现且顺序一致。写了两条querySql就得给两条table占位,否则 DataX 拿表名去拼 SQL 直接失败。只写querySql不写table时,table可以省略。
3.7 splitPk 怎么选
splitPk 决定 channel 怎么把数据切开发给各个线程。选得对,多核机器能吃满;选得对,等于单线程跑。
理想切分键 自增主键
分布均匀、单调递增,每个 channel 拿到的区间大小差不多
能用的 均匀分布的业务字段,比如 user_id 的哈希分布
不能用的 性别、状态、地区这种基数低或分布倾斜的字段
全落在同一个值上的话,只有一个 channel 在干活,其他全空转
没主键的表
用where缩小范围,把数据量压到能接受,再考虑分片
4. 怎么部署
裸跑 DataX 就是解压加配置两条命令,没什么可部署的。真正需要动手的是 datax-web——社区做的 Web 管理界面,给不想碰命令行的人用。
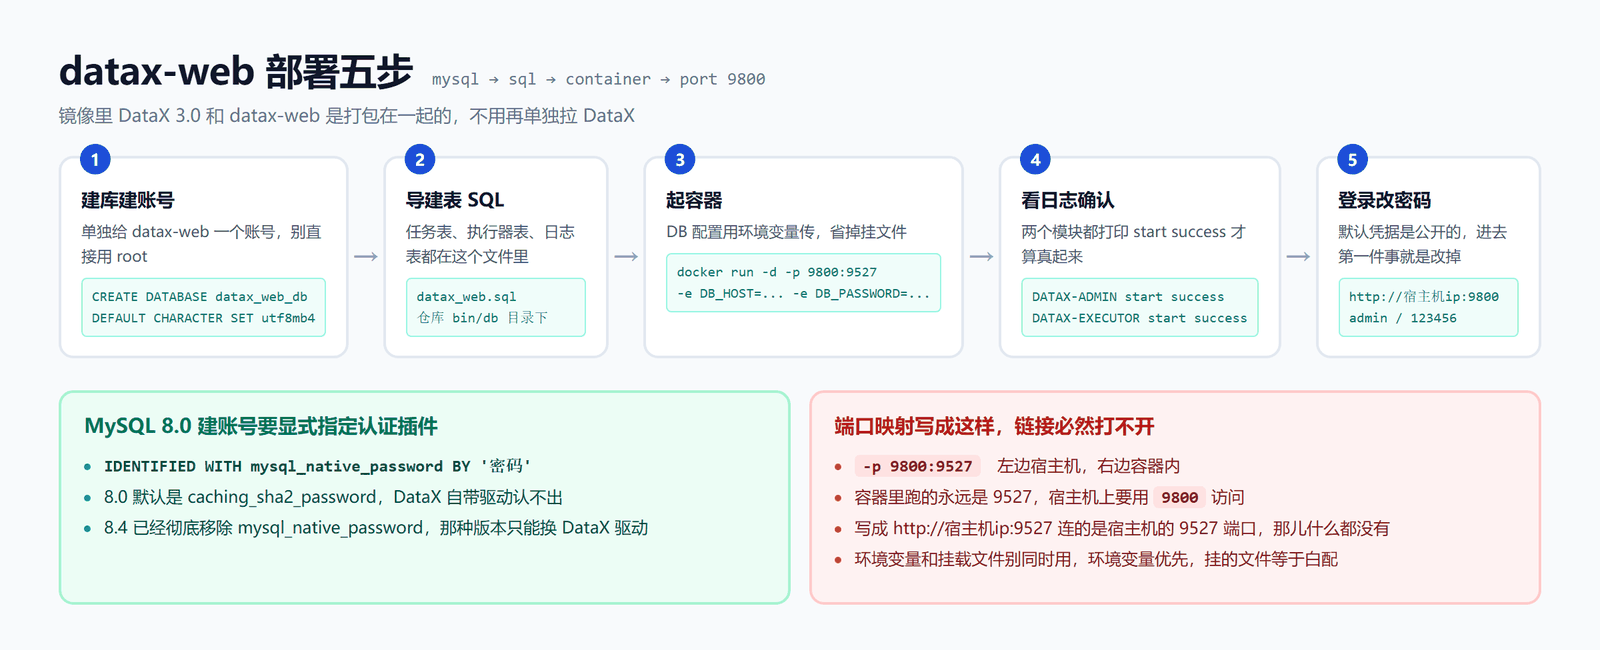
datax-web 是什么
开源的 DataX 图形化操作平台,不属于阿里官方项目
源码 github.com/WeiYe-Jing/datax-web
两个模块
datax-adminWeb 后台,监听 9527
datax-executor执行器,真正跑 DataX 任务的进程
常用镜像
linshellfeng/datax_web:3.0.1把 DataX 3.0 和 datax-web 打包在一起了
不用单独再拉 DataX 的镜像
4.1 准备数据库
先确认服务器上有 MySQL 在跑,datax-web 要把任务定义、执行器、日志都存进去。
建库建账号:
CREATE DATABASE datax_web_db DEFAULT CHARACTER SET utf8mb4 COLLATE utf8mb4_general_ci;

CREATE USER 'datax_web'@'%' IDENTIFIED WITH mysql_native_password BY '你的密码';

GRANT ALL PRIVILEGES ON datax_web_db.* TO 'datax_web'@'%';

FLUSH PRIVILEGES;
为什么用 mysql_native_password
MySQL 8.0 默认的认证插件是 caching_sha2_password,DataX 自带的 MySQL 驱动认不出
8.0 建账号时要显式写IDENTIFIED WITH mysql_native_password BY,和 5.7 的写法不一样
8.4 已经彻底移除这个插件,那种版本只能改 DataX 的驱动版本
不要给 root,datax-web 只需要自己那个库的权限
4.2 导建表 SQL
建完空库只是第一步,datax-web 的任务表、执行器表、日志表都得导进去。SQL 在项目仓库里:
https://github.com/WeiYe-Jing/datax-web/blob/master/bin/db/datax_web.sql拿到文件后导进去:
mysql -h 127.0.0.1 -u datax_web -p datax_web_db < datax_web.sql导完检查表在不在:
mysql -h 127.0.0.1 -u datax_web -p -e "use datax_web_db; show tables;"提示:
datax_web.sql是社区版 datax-web 的表结构,跟着项目版本走。拉的是 main 分支就配最新镜像,镜像版本对不上会报字段不存在。
4.3 启动容器
有两种配法,任选一种。
方案一:环境变量,Spring Boot 原生支持,不用挂文件,容器重建也不丢配置:
docker run -d \
    --name datax_web \
    -p 9800:9527 \
    -e DB_HOST=192.168.1.10 \
    -e DB_PORT=3306 \
    -e DB_DATABASE=datax_web_db \
    -e DB_USERNAME=datax_web \
    -e DB_PASSWORD='你的密码' \
    --restart always \
linshellfeng/datax_web:3.0.1方案二:挂载配置文件,先建好 bootstrap.properties 再挂进容器:
#Database
DB_HOST=192.168.1.10
DB_PORT=3306
DB_USERNAME=datax_web
DB_PASSWORD=你的密码
DB_DATABASE=datax_web_db
mkdir -p /data/datax/datax-admin/conf
vim /data/datax/datax-admin/conf/bootstrap.propertiesdocker run -d \
--name datax_web \
-p 9800:9527 \
-v /data/datax/datax-admin/conf/bootstrap.properties:/home/datax/datax-web-2.1.2/modules/datax-admin/conf/bootstrap.properties \
--restart always \
linshellfeng/datax_web:3.0.1注意:
-p 9800:9527左边是宿主机端口,右边是容器内端口。容器里跑的永远是 9527,宿主机上访问要用9800,写成 9527 打不开。
挂载路径 必须一字不差,路径错了容器会用自己的默认配置
然后连的是容器内置的库,登录时报数据库连不上
两种配别混用
用环境变量就别再挂bootstrap.properties,两个都配时环境变量优先,挂的文件等于白配
确认容器起来了:
docker ps | grep datax
docker logs -f datax_web
日志里看到这两个模块启动成功就算成了:
####### Begin To Start Module: [datax-admin] ######
DATAX-ADMIN start success
####### Begin To Start Module: [datax-executor] ######
DATAX-EXECUTOR start success
浏览器打开:
http://宿主机ip:9800/index.html默认账号 admin,默认密码 123456。
提示:
admin/123456是社区版写死的默认凭据,谁都能登进去。部署完第一件事就是进去改密码,改完顺手把这个端口从公网撤掉,只走内网或者加反向代理鉴权。
4.4 docker-compose 写法
services:
  datax-web:
    image: docker.io/linshellfeng/datax_web:3.0.1
    container_name: datax_web
    restart: always
    ports:
      - "9800:9527"
    environment:
      DB_HOST: 192.168.1.10
      DB_PORT: 3306
      DB_DATABASE: datax_web_db
      DB_USERNAME: datax_web
      DB_PASSWORD: "你的密码"
    volumes:
      - /data/datax:/datax
把 DataX 的 job 目录也挂出来,在宿主机上直接编辑任务 JSON,比进 Web 界面改方便:
/data/datax对应容器里的 DataX 工作目录
宿主机上改完这个文件,容器里立刻能读到
调试阶段用这条,任务多了就不如走 Web 的任务管理
5. datax-web 怎么用
接入执行器
第一次进来先到「执行器管理」,把 datax-executor 的地址填进去
镜像自带的话执行器会自动注册,地址一般填容器 IP 加 9527
配置数据源
「数据源管理」里把源库和目标库都建上,填 JDBC 地址、账号、密码
创建任务
选 reader 插件、选 writer 插件,表单填参数
界面会直接生成 job.json,可以复制出来改成手工版再上传
跑任务
「任务管理」手动执行一次,或配调度周期自动跑
看日志
每次执行都有日志,能看到 DataX 的完整输出
失败时这里就是排查的第一现场
「表单生成 job.json」这个功能对新手很友好,对熟手却是负担——参数多起来以后,表单里的下拉框表达不了 where 里复杂的条件。实际做法是:表单生成一版打底,下载下来手工改完再上传回去。
6. 常见问题
数据写进去是乱的
两端连接的字符集不一致,reader 端的 jdbcUrl 加上useUnicode=true&characterEncoding=utf8
报脏数据,但看不出哪条
errorLimit保持全 0,DataX 会把出错的那行原文打出来
字段值莫名错位
reader 和 writer 的 column 顺序不一致,这是最常见的一种
任务跑着跑着 OOM
byte设太小,或者batchSize太大
速度上不去,一直单线程
splitPk没配,或者配了一个基数低的字段
update 模式跑完行数是 0
目标表没建主键或唯一索引,on duplicate key update匹配不到任何行
大表清空特别慢
preSql里把delete from换成truncate
💡 补充几个原文没写的:
增量同步怎么做
没有内建的增量机制,靠where自己划时间窗口
where里的时间戳要用上次跑批的结束时间,不要用now(),边界数据会重复或漏掉
多文件源用 txtfile
磁盘上几十个 csv 要入库,txtfileReader比数据库导出再导回来快
生产上定时跑用系统 crontab
命令退出一行就返回成功,可以直接用返回码判断
用crontab调datax.py加日志重定向,比再引一层调度平台轻
JSON 里别写连接密码
job.json 会连同任务一起传到 datax-web 的数据库里,等于密码明文落库
数据库访问账号建议只给读权限,同步到别的库时另配一个写账号
先小后大
调参数时where加上id < 100,几十行数据几秒钟跑完,改配置不用干等
DataX 插件版本要对上引擎
自己编译插件放到plugin/里报版本不匹配,是core.txt对不上,换成同版本编译的
🔥 一句话总结:DataX 的全部配置就是一个 job.json,reader 和 writer 成对出现、column 顺序必须对齐、
splitPk决定并发能不能跑满;要图形界面就用 datax-web,Docker 起一个镜像、导一次建表 SQL、登进去先改掉默认的admin/123456。