
YOLO 从环境到训练:目标检测的安装、标注与评估
📝 笔记摘要:YOLO 从环境到训练
YOLO 是实时目标检测的事实标准,一个包覆盖检测、分割、分类、姿态、旋转框五种任务。本文把三件事串成一条完整链路:按自己的显卡把环境装对、不依赖任何数据集先跑通一次预测、把自己的数据训成可用模型。
顺序不能乱。环境没验就急着标数据,是这个项目里最容易亏本的开始——等几百张图标完才发现 PyTorch 装的是 CPU 版,之前所有时间都白花。环境隔离那部分的前置在 conda 与 screen 运维速查,Windows 上的 Python 与 IDE 准备在 Windows 本地开发环境搭建。
1. YOLO 解决的是哪一段问题
传统做法是「先检测、再分类」两步走,两套模型串起来,慢。YOLO 的思路是把定位和分类压进一个网络,一次前向直接吐出所有目标的位置和类别,所以叫 You Only Look Once。网络骨架属于 CNN 系,卷积、池化、全连接这些零件在 深度学习概论里有讲过。
检测和分割是两回事
detect 输出矩形框,适合「有哪些、在哪」
segment 输出逐像素掩膜,适合轮廓不规则的物体
拿 detect 的权重去做分割不会给出想要的轮廓,这是最常见的任务混用
为什么现在还有人用老版本
YOLOv8 的生态沉淀最多,教程和现成权重最全
YOLO11 换掉了骨干和检测头,参数效率更高
YOLO26 去掉了 NMS 后处理,部署链路更短
三者 API 完全一致,换版本只是换权重文件名
预训练权重是免费的起点
拿 COCO 上训练好的权重直接用,能识别 80 类常见物体
自己的类别不在里面时才需要训练,从这个权重接着练比从零练快得多
2. 五个任务,一套 API
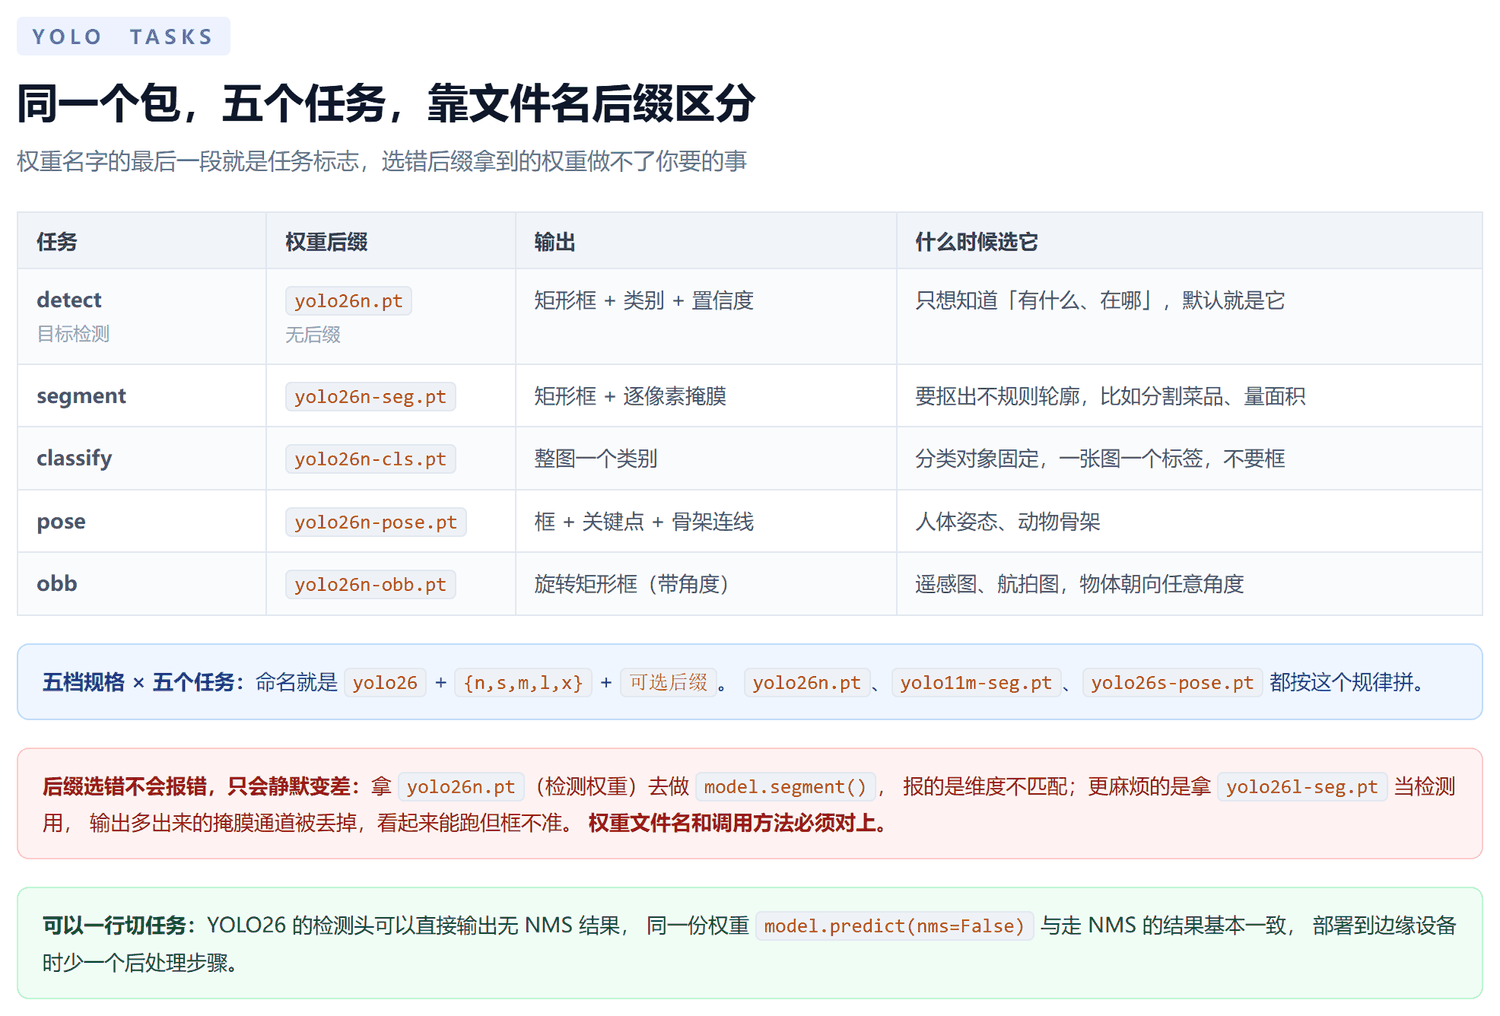
任务靠权重文件名最后的后缀区分,调用时方法名也要对上:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
results = model.predict("test.jpg", conf=0.25)

# results[0].boxes 里有 xyxy 坐标、conf 置信度、cls 类别编号
for box in results[0].boxes:
    print(box.xyxy.tolist(), box.conf.item(), int(box.cls.item()))
2.1 五档规格怎么挑
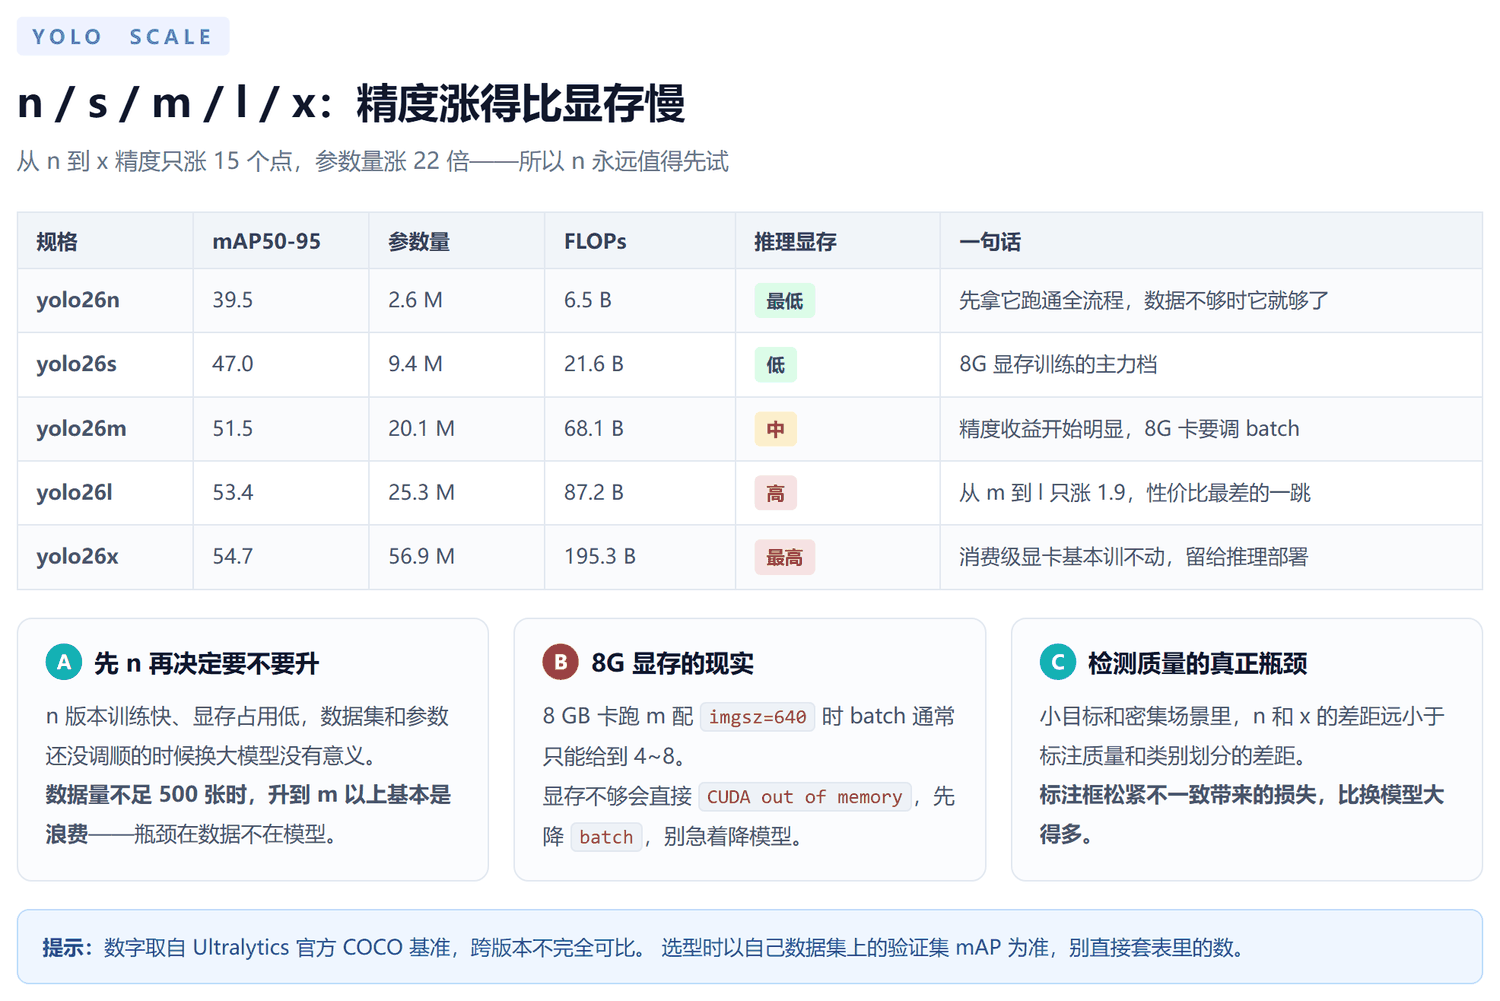
n 起步,能不升就不升
从 n 到 x 精度只涨 15 个点,参数量涨了 22 倍
数据量不足 500 张时升大模型基本是浪费,瓶颈在数据不在模型
8G 显存的现实
n 和 s 在 8G 卡上 batch 能给到 16 以上
m 通常要降到 4~8,再往上升就得换卡
显存不够直接CUDA out of memory,先降 batch 而不是先降模型
训练和推理可以不同档
训练用 m 拿精度,导出后部署换 n 换速度,这是常规做法
两档之间差一个数量级的耗时,精度差几个点往往能接受
3. 环境:三层,顺序不能反
conda 环境 → PyTorch + CUDA → ultralytics。第三层依赖前两层,装反了不会有任何报错。
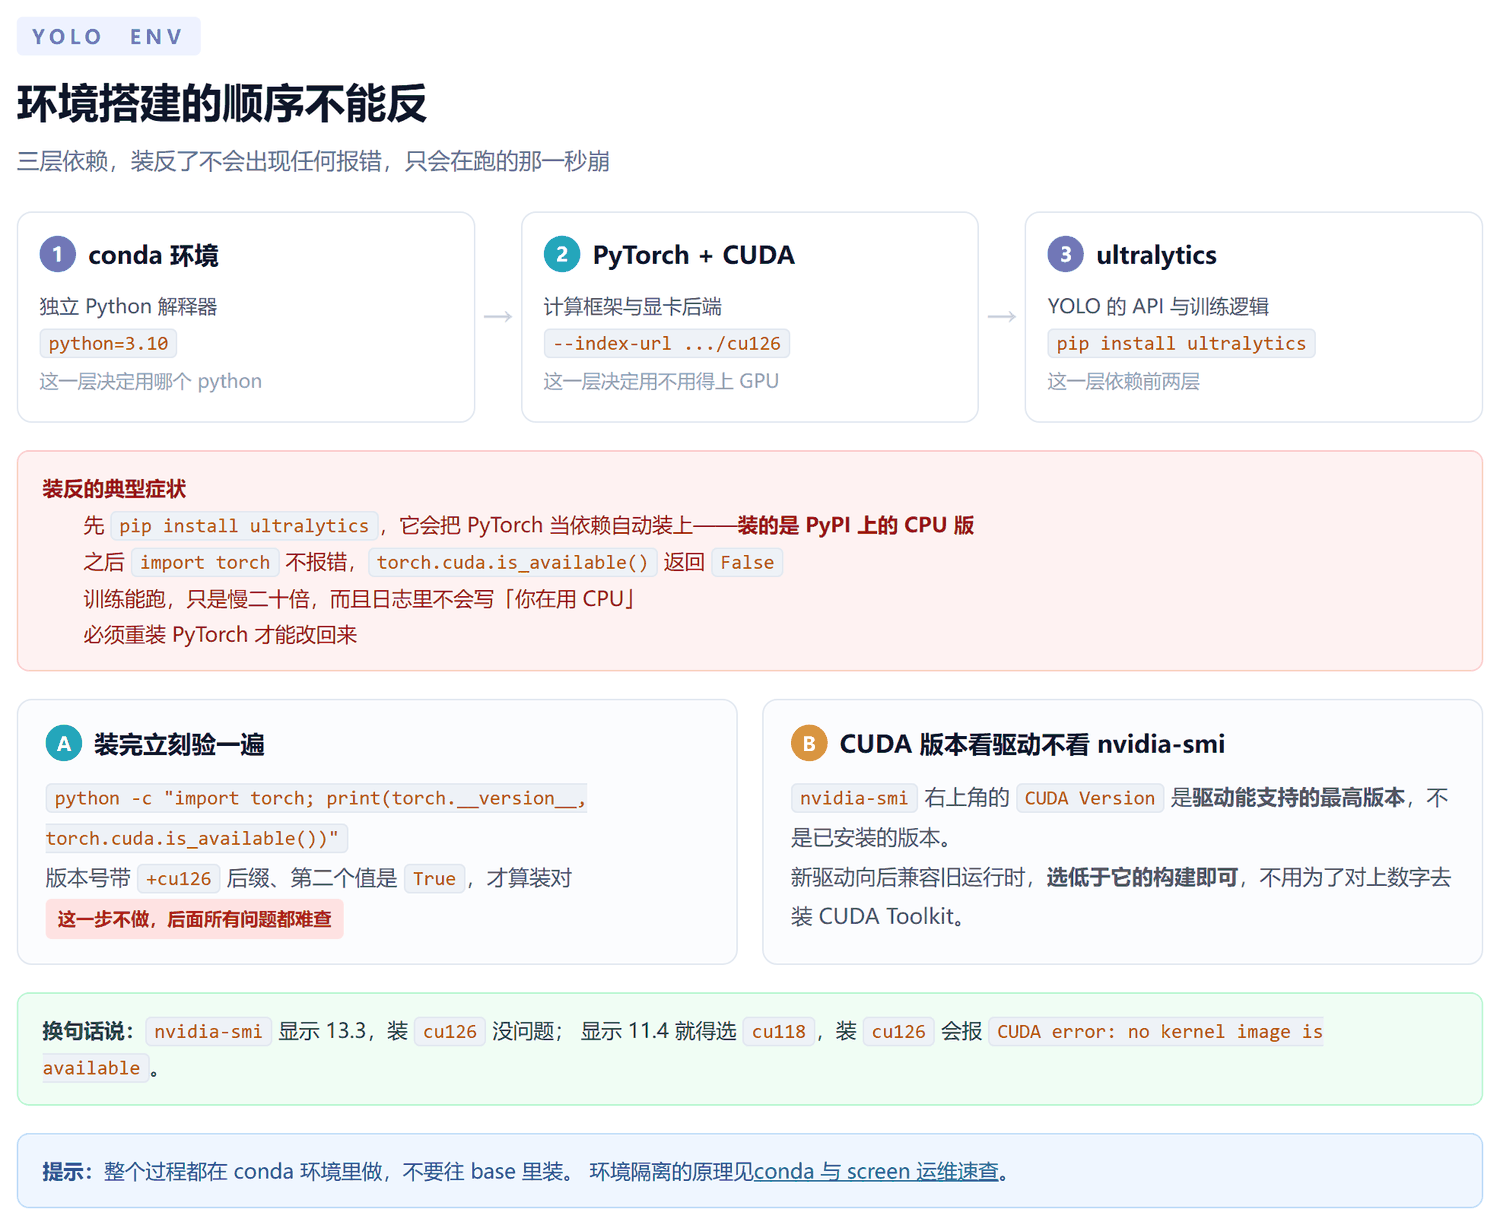
# 1. 建环境,PyTorch 2.12 要求 Python 3.10 或更高
conda create -n yoloV8 python=3.10 -y
conda activate yoloV8

# 2. 装 PyTorch,cu126 按你自己的显卡选,见下一节
pip install torch torchvision --index-url https://download.pytorch.org/whl/cu126

# 3. 装完立刻验,这一步不能省
python -c "import torch; print(torch.__version__, torch.cuda.is_available())"

# 4. 装 ultralytics
pip install ultralytics
先装 ultralytics 会静默装成 CPU 版
它把 PyTorch 当依赖拉下来,拉到的是 PyPI 上的 CPU 构建
import torch不报错,torch.cuda.is_available()返回False
训练照样能跑,就是慢二十倍,日志里不会提醒你在用 CPU
验对的标准
版本号带+cu126这类后缀,且第二个值是True
只打印False就重装 PyTorch,别急着往下走
pip 换源
默认走 PyPI,国内下载很慢
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple
全局生效一次就够,比每次敲-i省事
别往 base 里装
PyTorch 加依赖有好几个 G,装进 base 会拖累所有环境
要做的事只有一件:确认conda activate yoloV8在当前 shell 生效了,提示符前面有(yoloV8)
3.1 ultralytics 的许可要留意
仓库是 AGPL-3.0
学习和研究、个人项目、开源项目都能随便用
AGPL 的约束比想象中宽
只要你的服务通过网络提供给用户,就触发了源码开放义务
公司内部拿来训练模型但不对外提供服务,不触发
把模型权重嵌进闭源商业产品对外提供,要单独评估
商用有另一条路
Ultralytics Enterprise License 明确允许在闭源商用产品里部署 YOLO 模型
不需要开源义务,代价是要单独购买
官网定价页能查到当前条款
平台套餐和软件许可是两回事
Ultralytics Platform 的云端训练套餐不包含软件许可
买云服务不等于买了商用许可,这两条经常被搞混
4. 按显卡选 CUDA 构建
先看驱动支持到什么版本:
nvidia-smi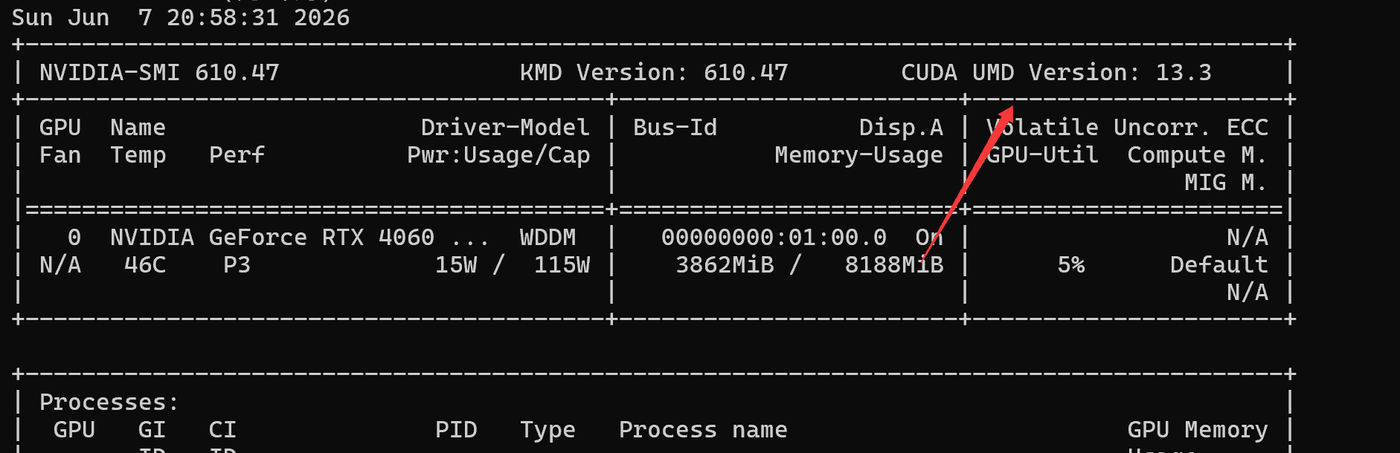
看的是驱动能力,不是已装版本
右上角CUDA Version表示这块驱动最高能跑哪个 CUDA 运行时
没装过 CUDA Toolkit,这里照样会显示一个数字
新驱动向后兼容
显示 13.3,装cu126构建完全没问题,不需要为了对上数字去装 Toolkit
反过来,显示 11.4 却装cu126,会报CUDA error: no kernel image is available for execution on the device
选版规则
驱动版本 ≥ 12.1 装 cu126 或更高的构建
驱动版本 < 12.1 装 cu118,这是保底选择
拿不准就 cu118,几乎所有卡都支持
显存是另一回事
上面这张 8 GB 卡,训练 m 版本时 batch 要降到 4~8
Memory-Usage那一列显示的 3862MiB 是别的进程占的,不是给你留的余量
PyTorch 官网的选择器就是按这几个维度拼安装命令的:
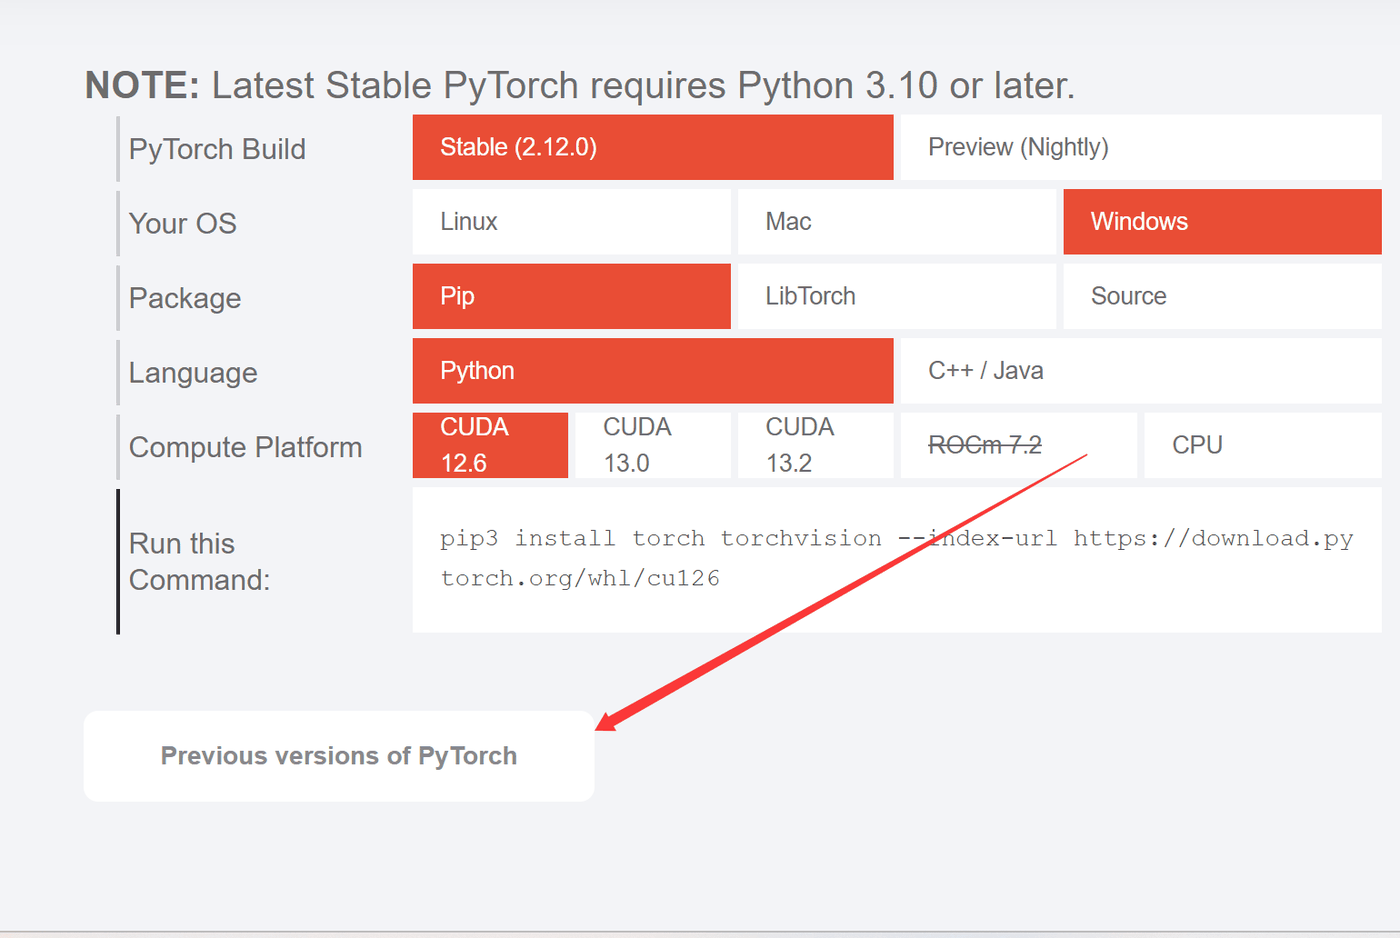
Stable 不是 Nightly
2.12.0 是当前稳定版,Nightly 是每晚构建,接口随时会变
Stable 要求的 Python 版本要满足:2.12 起要求 3.10 或更高
Previous versions 值得点开看
某个版本跑不起来,换上一版 Stable 常常就解决了
旧版 wheel 链接是永久的,不用担心过期下架
不要装 CPU 版
选择器里 Compute Platform 选 CPU 会生成不带--index-url的命令
装完torch.cuda.is_available()永远是False,而且没有任何提示
5. 零数据先跑一次
环境装完先别急着标数据。拿官方权重框一张图,验证的是环境本身。
# 命令行一行版
yolo detect predict model=yolo26n.pt source="test.jpg"

# 或者 Python
python -c "from ultralytics import YOLO; YOLO('yolo26n.pt')('test.jpg')"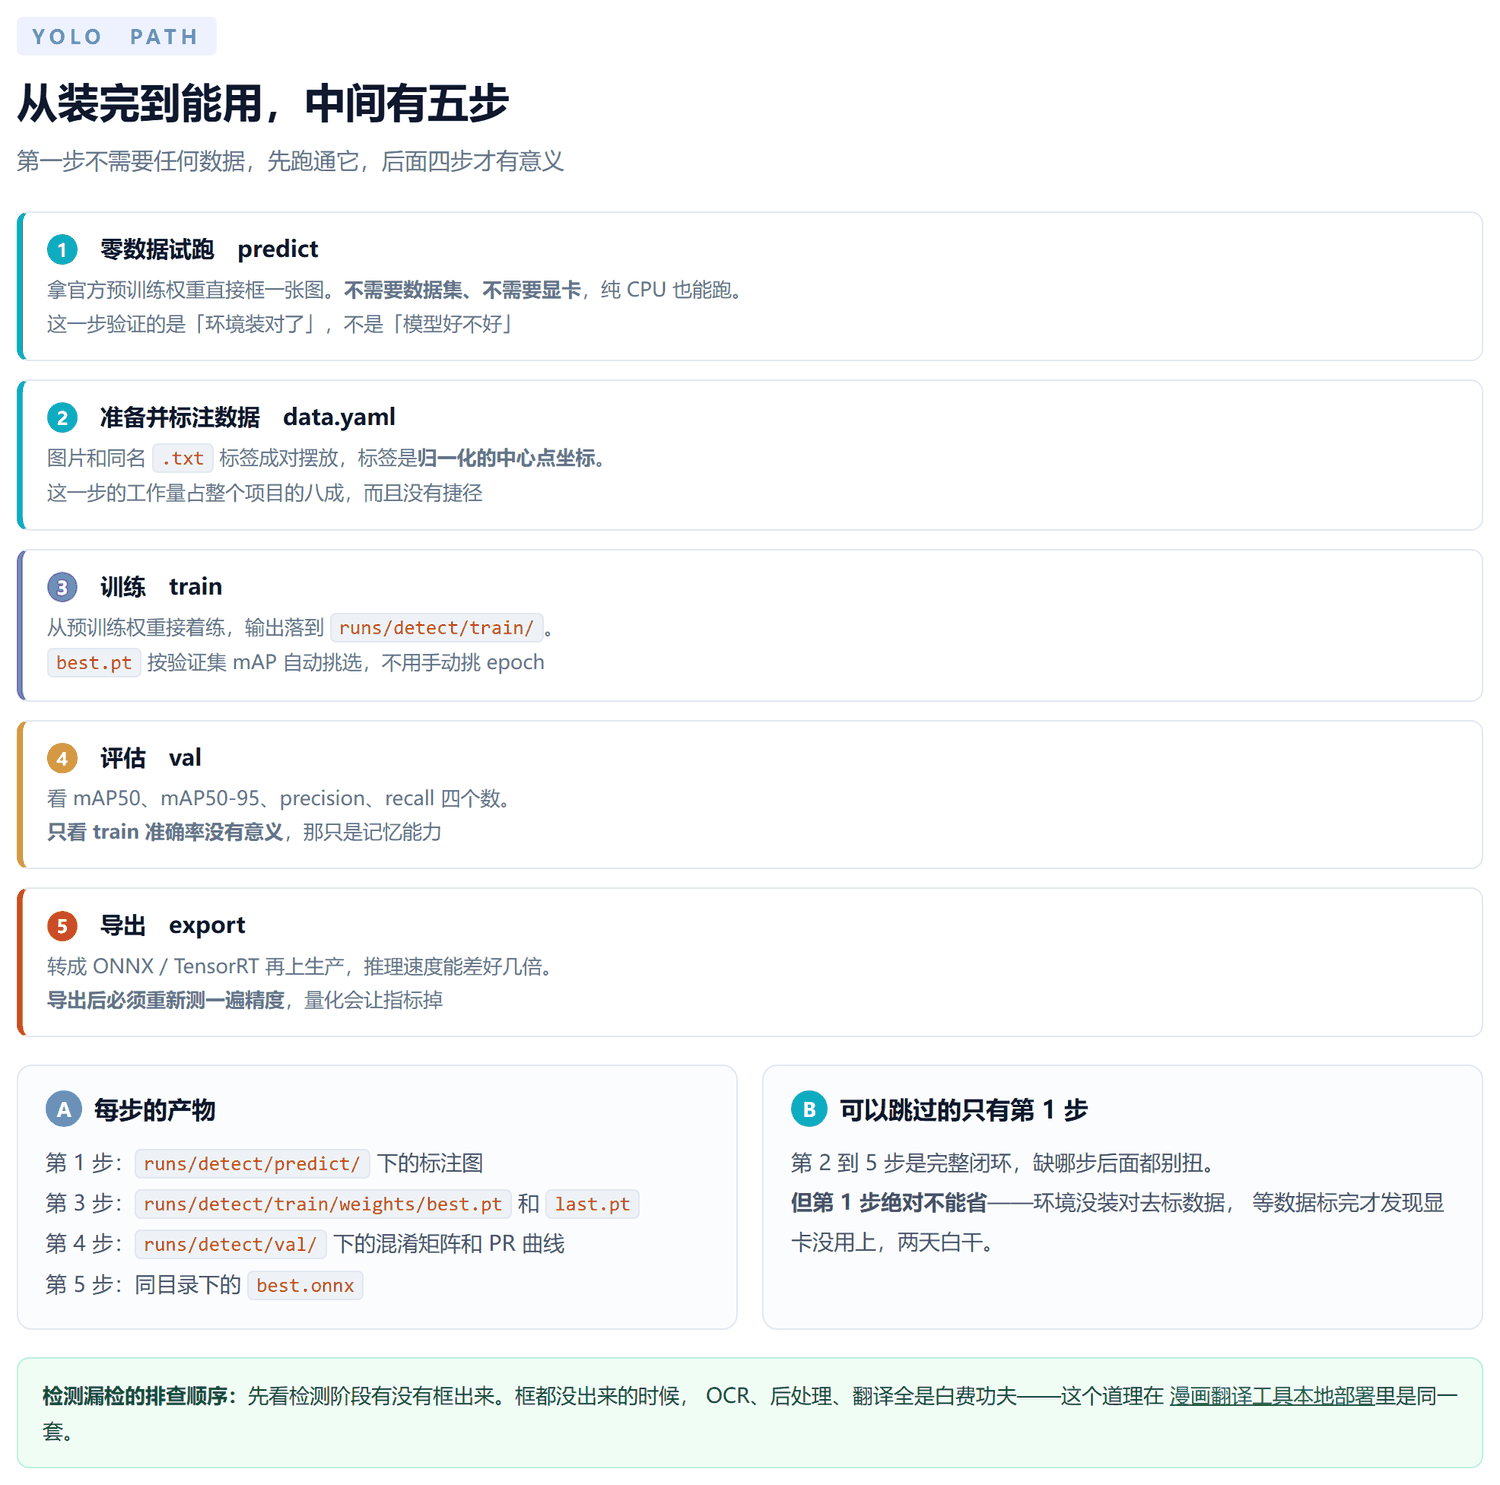
第一步不需要显卡也能过
纯 CPU 跑一张图几秒钟,够验证包装对了
图会自动下载到项目目录,第一次跑要等
要在这里把 PyCharm 也确认掉
Settings → Project → Python Interpreter 选yoloV8这个解释器
命令行认得环境不代表 IDE 认得,两边是各自的配置
跑通之后再往下走
没验过环境就开始标数据是最亏的做法
标完几百张才发现显卡没用上,这个坑的修复成本远高于花十分钟验一次
6. 训练自己的数据
6.1 目录结构
dataset/
├── data.yaml
├── images/
│   ├── train/     a.jpg  b.jpg  ...
│   └── val/       c.jpg  d.jpg  ...
└── labels/
    ├── train/     a.txt  b.txt  ...
    └── val/       c.txt  d.txt  ...
# data.yaml
path: D:/datasets/mydata
train: images/train
val: images/val
names:
0: helmet
1: vest图片和标签必须同名
a.jpg对a.txt,扩展名不同也一样,基名要一致
对不上的时候程序不会报错,这个图直接被当成没有目标的负样本
类别编号从 0 开始
对应关系写在names里,编号和顺序都是死的
写成 1 开头会静默错位,全类别的判定结果整体偏移
val 集别从 train 里随手拿
同一段视频抽的相邻帧分到 train 和 val,验证集等于偷看过
mAP 会虚高十几个点,上线立刻打回原形
6.2 标注格式
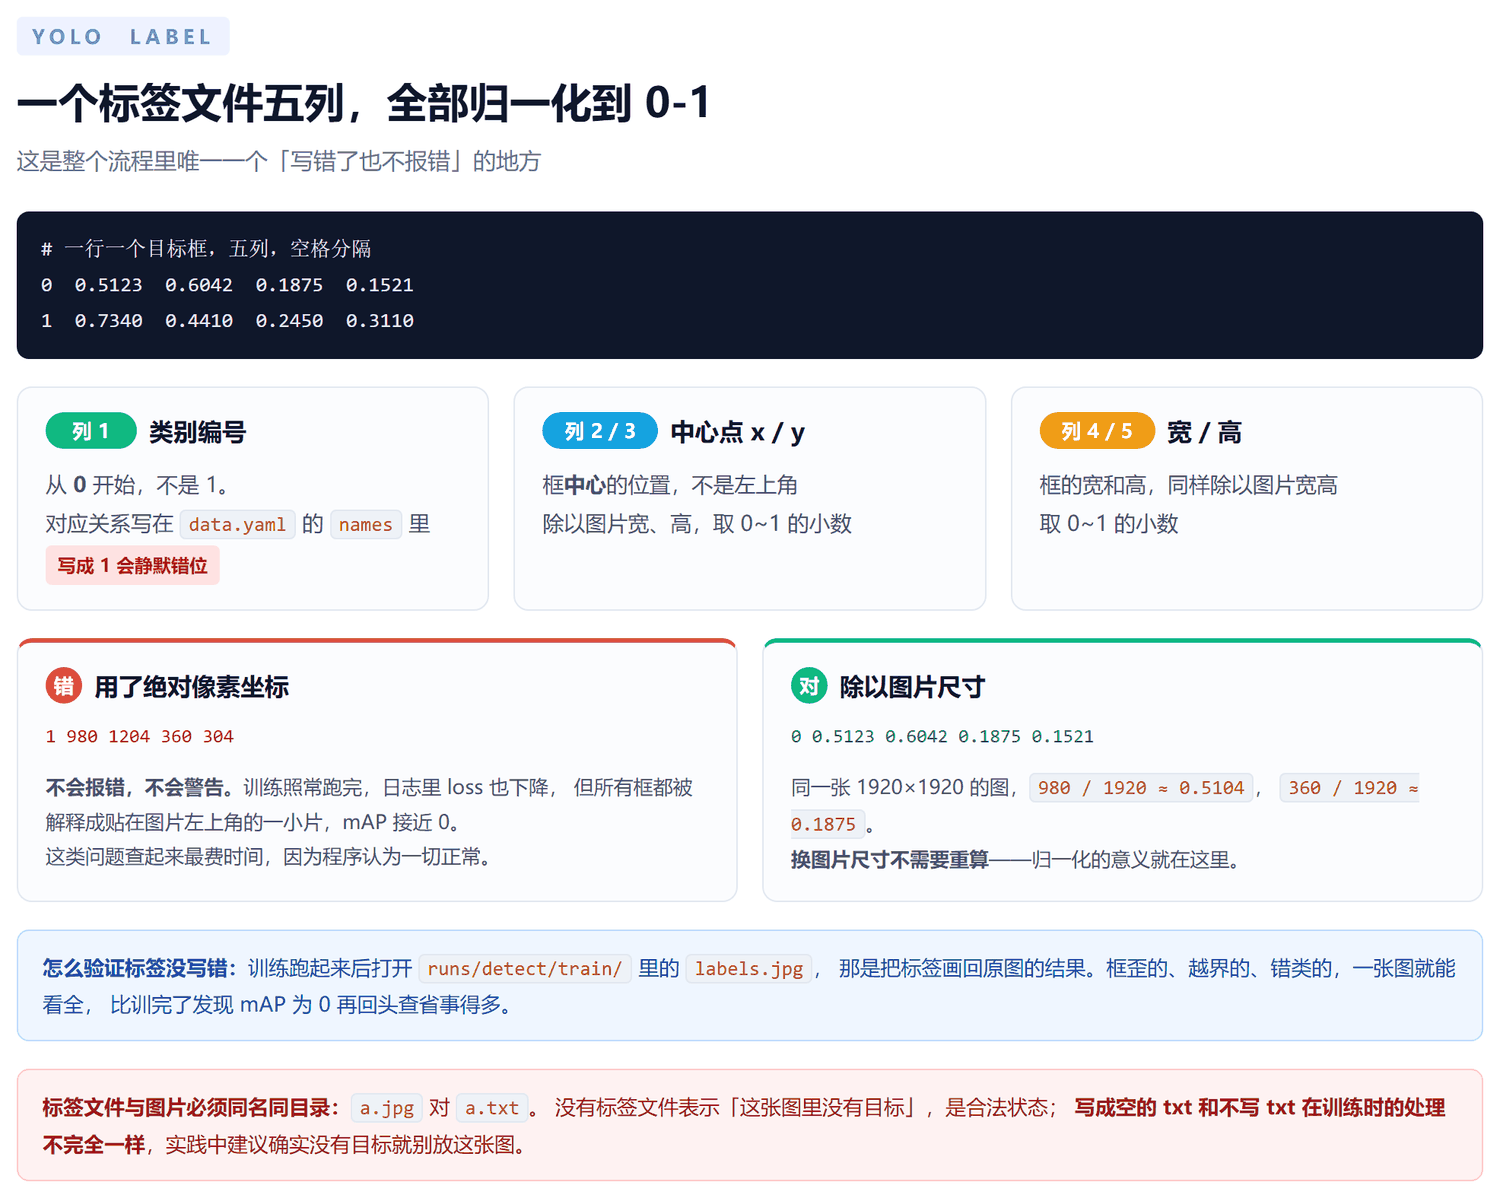
# 一个 .txt 里一行一个目标框,五列空格分隔
0  0.5123  0.6042  0.1875  0.1521
1  0.7340  0.4410  0.2450  0.3110
五列的顺序不能记错
类别 中心点x 中心点y 宽 高,先 y 后 x
第二三列是框的中心,不是左上角坐标
全部归一化到 0-1
不除以图片宽高的话,训练不会报错也不会警告,loss 照常下降
但所有框都被解释成贴在左上角的一小片,mAP 接近 0
这类问题只能靠看runs/detect/train/labels.jpg发现
怎么验证标签没写错
训练跑起来后打开labels.jpg,那是把标签画回原图的结果
框歪的、越界的、错类的,一张图就看全了
比训完了发现 mAP 为 0 再回头查省事得多
没有目标的图别放进来
不放标签文件是合法状态,表示这张图里没有目标
放一个空的.txt会被当成有效样本,行为不一致
6.3 训练命令
# 命令行
yolo detect train data=D:/datasets/mydata/data.yaml model=yolo26n.pt epochs=100 imgsz=640 batch=8 device=0

# Python
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.train(data="D:/datasets/mydata/data.yaml",
            epochs=100, imgsz=640, batch=8, device=0, workers=4)
device 怎么填
device=0第一块显卡
device=0,1两张卡
device=cpu强制用 CPU,调试用
device=mps苹果芯片
不填会自动选,但自动选不到就静默退化成 CPU,日志同样不提醒
workers 在 Windows 上别设太大
多进程读盘在 Windows 上容易撞上文件锁
4 是比较稳的默认值,报错就往下调
epochs 不够和 epochs 太多都会坏
数据集小的时候 50 轮就收敛,100 轮开始过拟合
验证集指标连续多轮不再涨就该停了,训太多纯粹浪费电
断点续训
model.train(resume=True)从last.pt接着跑
长任务跑挂了不用从头来
7. 看结果和导出
# 评估
yolo detect val model=runs/detect/train/weights/best.pt data=D:/datasets/mydata/data.yaml

# 导出
yolo export model=runs/detect/train/weights/best.pt format=onnx
yolo export model=runs/detect/train/weights/best.pt format=engine half=True
best.pt 是自动挑的
按验证集 mAP 挑最好的那一轮,不用手动挑 epoch
last.pt是最后一轮,续训用这个
四个指标各管一件事
mAP50IoU 放宽到 0.5 的综合指标,日常看这个
mAP50-95更严格,能反映框贴得准不准
precision框出来的东西有多少是对的,误检多就调高它
recall该找的有多少找到了,漏检多就调高它
训练准确率没有参考价值
train loss 一直降说明模型在记住训练集,跟泛化能力是两回事
判断过拟合看的是 train 和 val 两条曲线的差,差得越开越危险
导出后必须重新测
转 ONNX 或 TensorRT 会做量化,指标可能掉
拿导出模型和 PyTorch 原模型在同一批图上跑一遍对比再上线
导出格式怎么选
onnx通用性最好,跨语言都能读
engineTensorRT,只能 Nvidia 卡用,速度最快
half=True半精度,显存和带宽减半,精度损失通常可接受
8. 排查顺序
python -c "import torch; print(torch.__version__, torch.cuda.is_available(), torch.cuda.get_device_name(0) if torch.cuda.is_available() else 'no gpu')"mAP 接近 0
九成是标签坐标没归一化,用绝对像素写进去了
打开labels.jpg一眼能看出来
mAP 正常但类别整体错位
names里的顺序和标注时用的编号对不上
CUDA out of memory
先降batch,再降imgsz,降 batch 优先
降 batch 会影响收敛速度,降 imgsz 会影响小目标检测能力
no kernel image is available
装的 CUDA 构建比驱动新,换 cu118
验证集指标远高于训练时看到的
train 和 val 的图来自同一段视频,相邻帧高度相似
重新划分数据,按场景或视频源切,不要随机按帧切
Windows 上 DataLoader 报错
把workers降到 2 或 0,多进程读盘的文件锁问题
💡 补充几个容易忽略的:
检测质量的天花板在标注
框画得松紧不一、类别定义模糊、边界样本拿不准,
这些问题带来的损失远大于换模型带来的收益
小数据集的实用做法
先跑yolo26n.pt看官方权重的效果,
能直接满足需求就不训了,这是最省时间的一步
数据量粗略参考
每个类别 100 张能出可用效果,300 张以上明显更稳
少于 50 张基本训不出可用模型,先补数据
类别数量控制在几十个以内
类别越多,每个类分到的样本越少,mAP 掉得越快
细粒度区分靠数据不靠类别划分
检测漏了就是漏了
检测框没出来的场景,后面 OCR、后处理、翻译全是白费功夫,
这个判断顺序在 漫画翻译工具本地部署里是同一套逻辑
磁盘和显存一起规划
runs/目录每训一轮存一次权重和中间图,100 轮能吃掉几个 G
不重要的旧实验目录定期清
模型和环境要一起备份
只存best.pt不存环境,换台机器版本对不上结果就不一样
环境落成environment.yml,conda env export一条命令导出
🔥 一句话总结:YOLO 上手就三条线——
conda create -n yoloV8 python=3.10建环境、按nvidia-smi的驱动版本挑 PyTorch 构建(≥12.1 用 cu126,否则 cu118)、装完立刻用torch.cuda.is_available()验;然后拿yolo26n.pt零数据跑一次 predict 确认环境,标注时牢记标签是 归一化的中心点坐标,类别编号从 0 开始,坐标写错不会报错只有 mAP 归零;训练完用 val 的mAP50和mAP50-95判断泛化而不是看训练准确率,上生产前导出 ONNX 并重新测一遍精度。