
video-subtitle-remover 字幕抹除部署:预构建包、CUDA 库冲突与算法取舍
📝 笔记摘要:video-subtitle-remover 字幕抹除部署
VSR 是去除视频硬字幕的开源工具,Apache 2.0 协议,特点是只在字幕那一小块矩形里做修复,其余像素原样拷贝,所以叫「无损分辨率」。原笔记记的是一次实际的源码安装过程,卡在 CUDA 库加载上,留下了 unset LD_LIBRARY_PATH 这个动作。
动作本身能用,但原笔记漏了三件更要紧的事:发布包是 .7z 不是 zip、Paddle 版本 pin 的是 2.6.2 而当前是 3.0.0、README 明确说优先用预构建包,源码安装只是兜底。另外记进笔记的 conda install cudatoolkit 这条命令,conda-forge 已经在 CUDA 12 迁移时把 cudatoolkit 这个包整个移除了,新版上跑会直接 PackagesNotFound。
环境隔离和 screen 会话的部分在 conda 与 screen 运维速查。
1. 流水线:六段
核心思路决定了它的能力边界:不碰字幕区之外的任何像素。所以画面越干净、字幕越小,修复效果越好;反过来,字幕压在复杂纹理上时,任何算法都会露出痕迹。
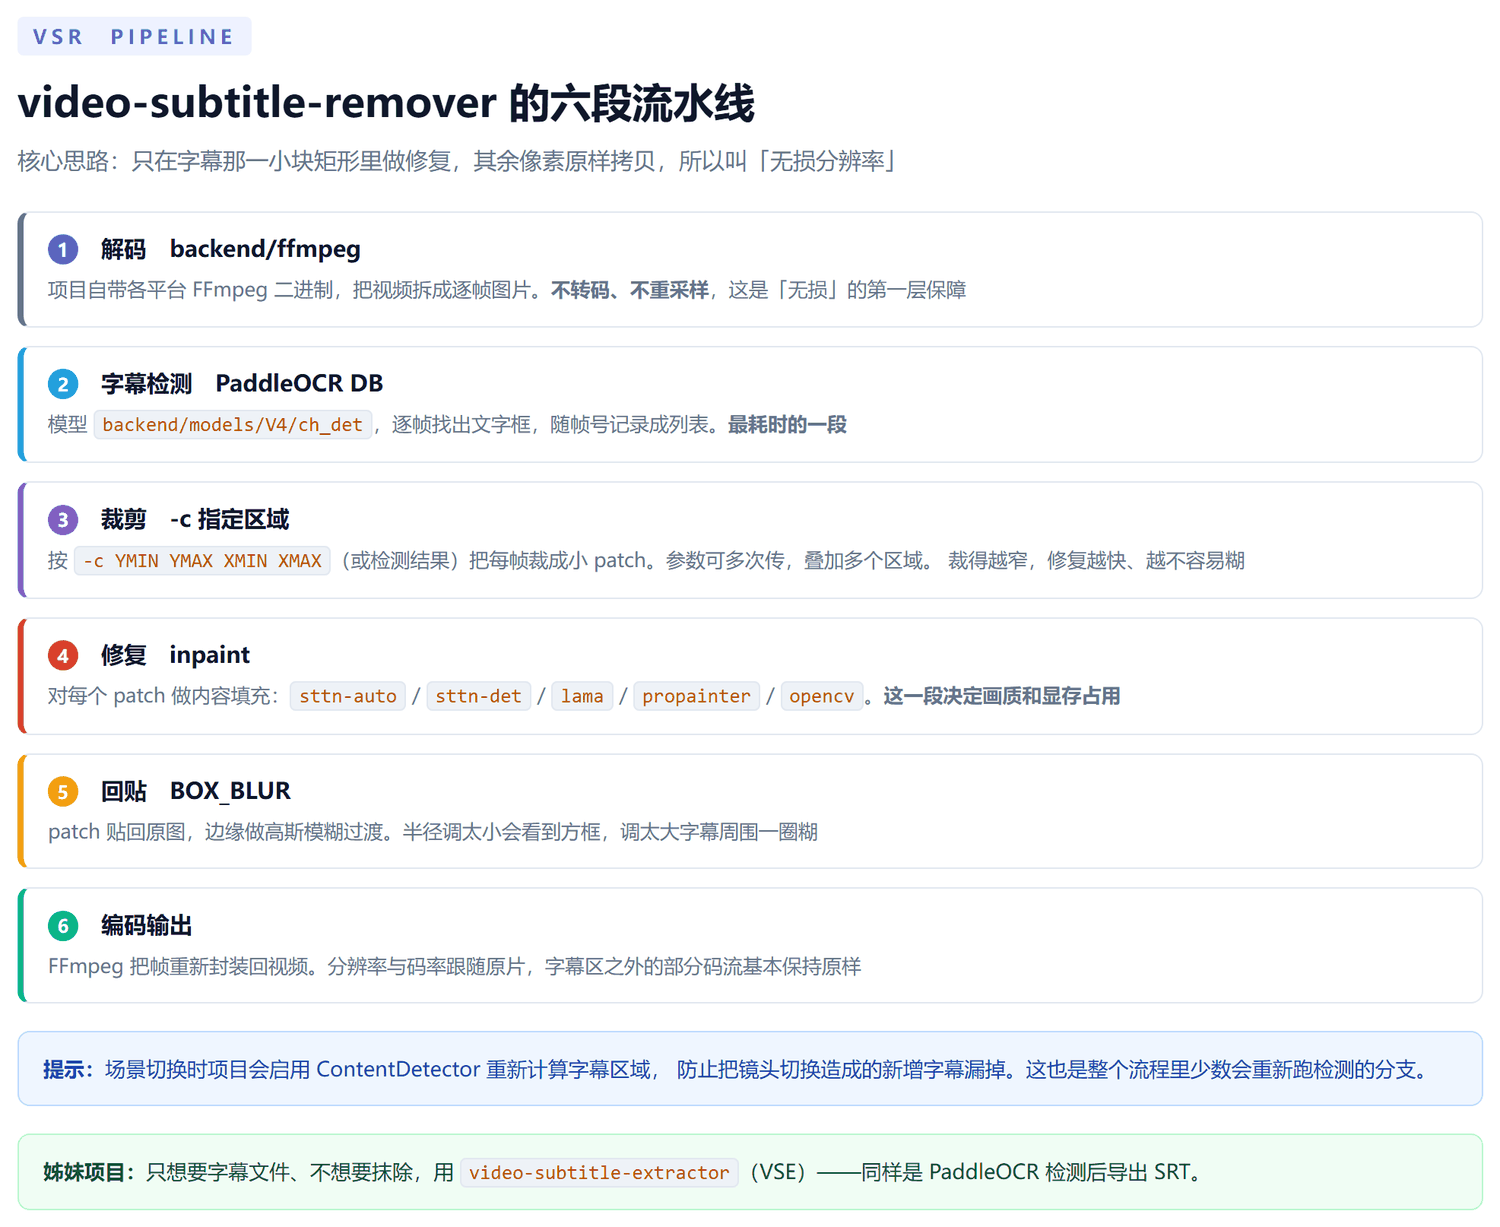
解码不转码,这是「无损」的第一层
backend/ffmpeg/里预置了各平台的 FFmpeg 二进制,不依赖系统装的版本
拆帧直接出图片,跳过重采样,中间没有一次画质损失
字幕检测是最耗时的一段
模型在backend/models/V4/ch_det,逐帧找文字框
整个流程的进度感基本等于检测的进度
场景切换会重算区域
用 ContentDetector 判断镜头切换,切一次字幕区就重算一次
这是防止镜头切换后新增字幕被漏掉的兜底
只想拿字幕文件就别用 VSR
姊妹项目video-subtitle-extractor(VSE)做同样的检测,导出 SRT 而不做修复
自带 FFmpeg 报错时
预构建包解压失败或者backend/ffmpeg/下的二进制在当前系统跑不起来,
系统里得有一个能用的 FFmpeg,装法见 Linux 上装 ffmpeg
2. 先选路线
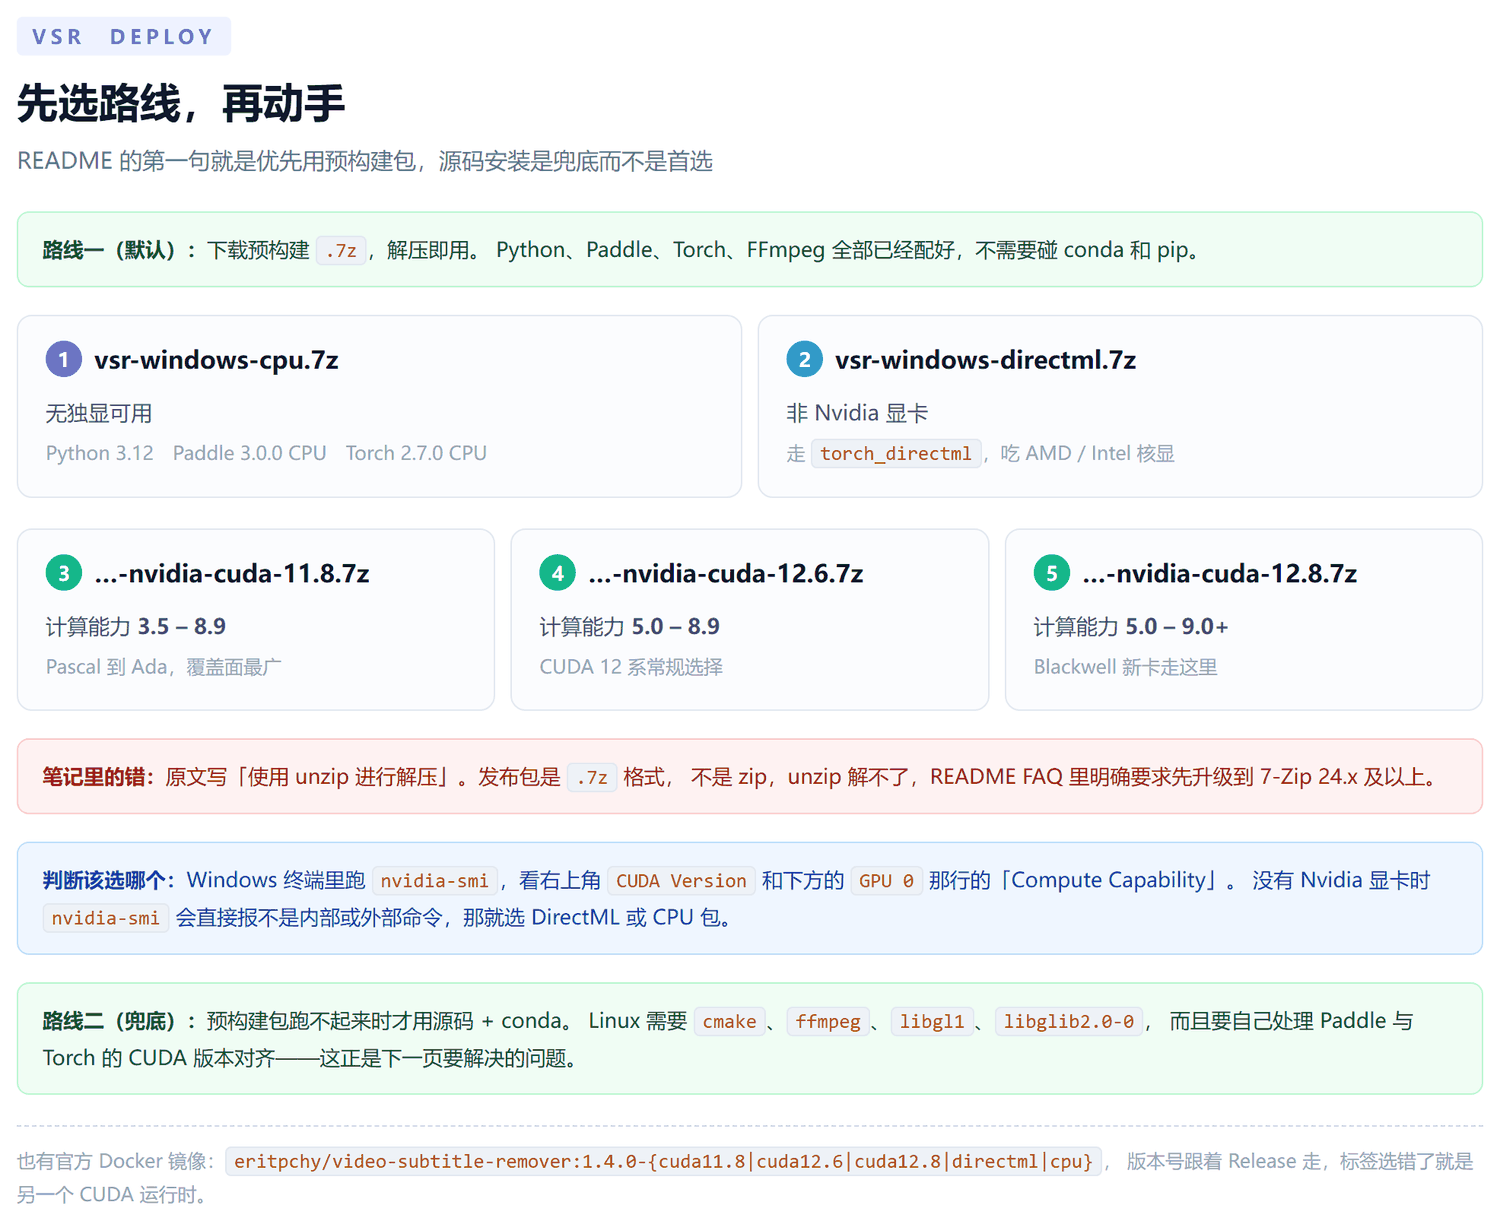
README 第一句就是优先用预构建包。源码安装要自己处理 Paddle 与 Torch 的 CUDA 版本对齐,是预构建包跑不起来时的兜底,不是首选。
# 判断自己的卡属于哪一档
nvidia-smi
看 nvidia-smi 的两个位置
右上角CUDA Version是驱动支持的最高 CUDA 版本
下面GPU 0那行里的Compute Capability决定选哪个包
比如8.6是 RTX 30 系,三个 CUDA 包的区间都覆盖
没有 Nvidia 显卡会直接报错
nvidia-smi: command not found就是没装驱动或者压根不是 N 卡
这时候选directml包(AMD / Intel 核显)或cpu包
Docker 镜像的标签别选错
eritpchy/video-subtitle-remover:1.4.0-cuda11.8这种形式
标签就是 CUDA 运行时版本,选错等于换了一套 CUDA
可用标签:cuda11.8、cuda12.6、cuda12.8、directml、cpu
3. 路线一:预构建包
原笔记这一步是错的
写的「使用 unzip 进行解压」——发布包是.7z,unzip 解不了
README FAQ 里明确要求先升级到 7-Zip 24.x 及以上,老版本解压大文件会报数据错误
Windows 资源管理器右键直接选 7-Zip → 解压到 xxx 目录就行,不用命令行
五个包的依赖版本
vsr-windows-cpu.7zPython 3.12 / Paddle 3.0.0 / Torch 2.7.0
vsr-windows-directml.7zPython 3.12 / Paddle 3.0.0 CPU / torch_directml
…-nvidia-cuda-11.8.7z计算能力 3.5 – 8.9
…-nvidia-cuda-12.6.7z计算能力 5.0 – 8.9
…-nvidia-cuda-12.8.7z计算能力 5.0 – 9.0+
解压后不用碰 pip 和 conda
包里的 Python 解释器和依赖都是现成的,FFmpeg 也在backend/ffmpeg/
这一步之所以值得优先,就是因为它把下面第 4 到 6 节的所有麻烦全跳过了
4. 路线二:源码 + conda
预构建包解决不了的场景才走这条:需要改代码、Linux 上部署、或者要在指定 CUDA 版本上复现。
# 系统依赖,Linux
apt install cmake ffmpeg libgl1 libglib2.0-0

# 建环境,Python 3.12 是硬要求
conda create -n VSR python=3.12 -y
conda activate VSR

# 按显卡选一组,下面四组选一组

# A. Nvidia + CUDA 11.8
pip install paddlepaddle-gpu==3.0.0 -i https://www.paddlepaddle.org.cn/packages/stable/cu118/
pip install torch==2.7.0 torchvision==0.22.0 --index-url https://download.pytorch.org/whl/cu118
# Linux 上还需要这一条
pip install onnxruntime-gpu==1.20.1 --index-url https://aiinfra.pkgs.visualstudio.com/PublicPackages/_packaging/onnxruntime-cuda-11/pypi/simple/

# B. AMD / Intel 核显,走 DirectML
pip install paddlepaddle==3.0.0 -i https://www.paddlepaddle.org.cn/packages/stable/cpu/
pip install torch_directml==0.2.5.dev240914

# C. 纯 CPU
pip install paddlepaddle==3.0.0 -i https://www.paddlepaddle.org.cn/packages/stable/cpu/
pip install torch==2.7.0 torchvision==0.22.0

# 依赖装齐
pip install -r requirements.txt
原笔记 pin 的版本过时了
原文写paddlepaddle-gpu==2.6.2.post118,那是上一代
当前官方要求3.0.0,预构建包里带的也是这个版本
两代 wheel 的 API 有变化,按老版本写的启动脚本在新版上会报错
PyPI 上没有 GPU 版
pip install paddlepaddle-gpu不带-i会装成 CPU 版或者直接找不到包
GPU 版的索引地址在 Paddle 官方站,不是 PyPI,必须显式带-i
Linux 少一条会怎样
不装onnxruntime-gpu那条,程序能启动,但在某些分支上回落到 CPU 推理
表现是能跑、就是慢好几倍,不报错,很难定位
Python 3.12 是下限不是上限
官方要求 3.12 或更高,但更高版本未必兼容,3.12 是最稳的
建环境时就锁死python=3.12,别用python=3.13这种模糊写法
5. 两份 cuDNN 打起来
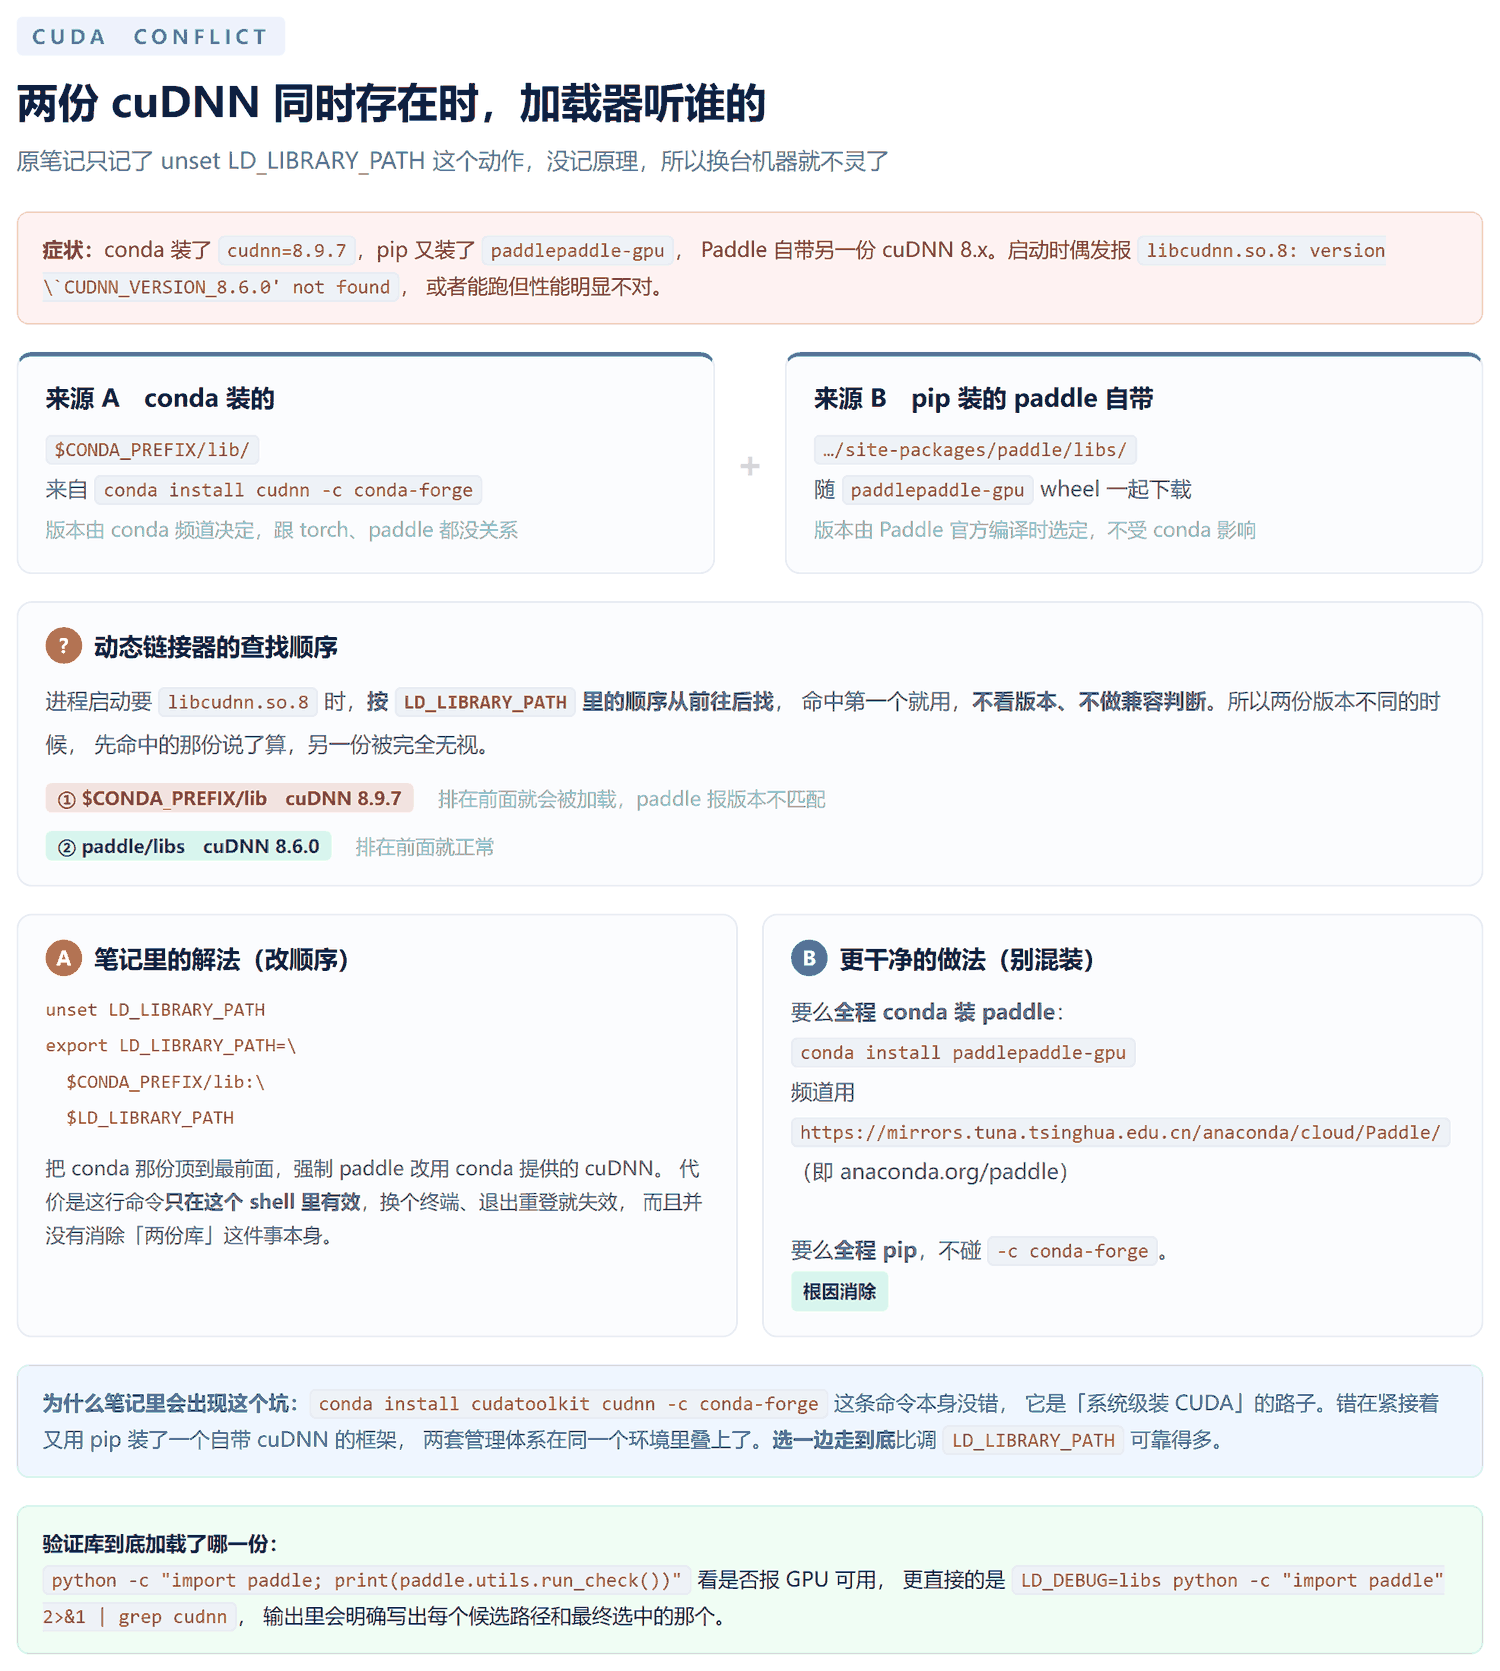
原笔记里 unset LD_LIBRARY_PATH 那两行,就是这一步的解药。但只记了动作没记原理,换台机器就不灵了。
# 笔记里的解法:把 conda 那份顶到最前
unset LD_LIBRARY_PATH
export LD_LIBRARY_PATH=$CONDA_PREFIX/lib:$LD_LIBRARY_PATH
为什么会撞
conda install cudnn -c conda-forge装一份进$CONDA_PREFIX/lib/
pip install paddlepaddle-gpu的 wheel 自带一份在site-packages/paddle/libs/
两套管理体系在同一个环境里叠上了,这是根因
动态链接器不看版本
进程要libcudnn.so.8时,按LD_LIBRARY_PATH顺序从前往后找
命中第一个就用,不做版本兼容判断,另一份被完全无视
所以报的是version \`CUDNN_VERSION_8.6.0' not found这种看着莫名其妙的错
原笔记的 cudnn 版本和 README 冲突
笔记装cudnn=8.9.7,VSR README 对 CUDA 11.8 推荐的是 8.6.0
8.6.0 正是 paddle wheel 自带的那份,两边对齐之后其实根本不需要改LD_LIBRARY_PATH
更干净的做法是别混装
全程 conda 装 paddle,频道用https://mirrors.tuna.tsinghua.edu.cn/anaconda/cloud/Paddle/(即 anaconda.org/paddle)
或者全程 pip,不碰-c conda-forge
conda-forge 的 cudatoolkit 已经被移除
CUDA 12 迁移时改成按组件拆分,conda install cudatoolkit=11.8 -c conda-forge在新版上直接 PackagesNotFound
这是原笔记里第三条命令现在跑不通的原因,跟LD_LIBRARY_PATH无关
怎么确认实际加载了哪一份
python -c "import paddle; print(paddle.utils.run_check())"看 GPU 是否可用
LD_DEBUG=libs python -c "import paddle" 2>&1 | grep cudnn能看到每个候选路径和最终选中的那个
6. 修复算法怎么选
算法配置在 backend/config.py 的 MODE 里,改完要重启进程。
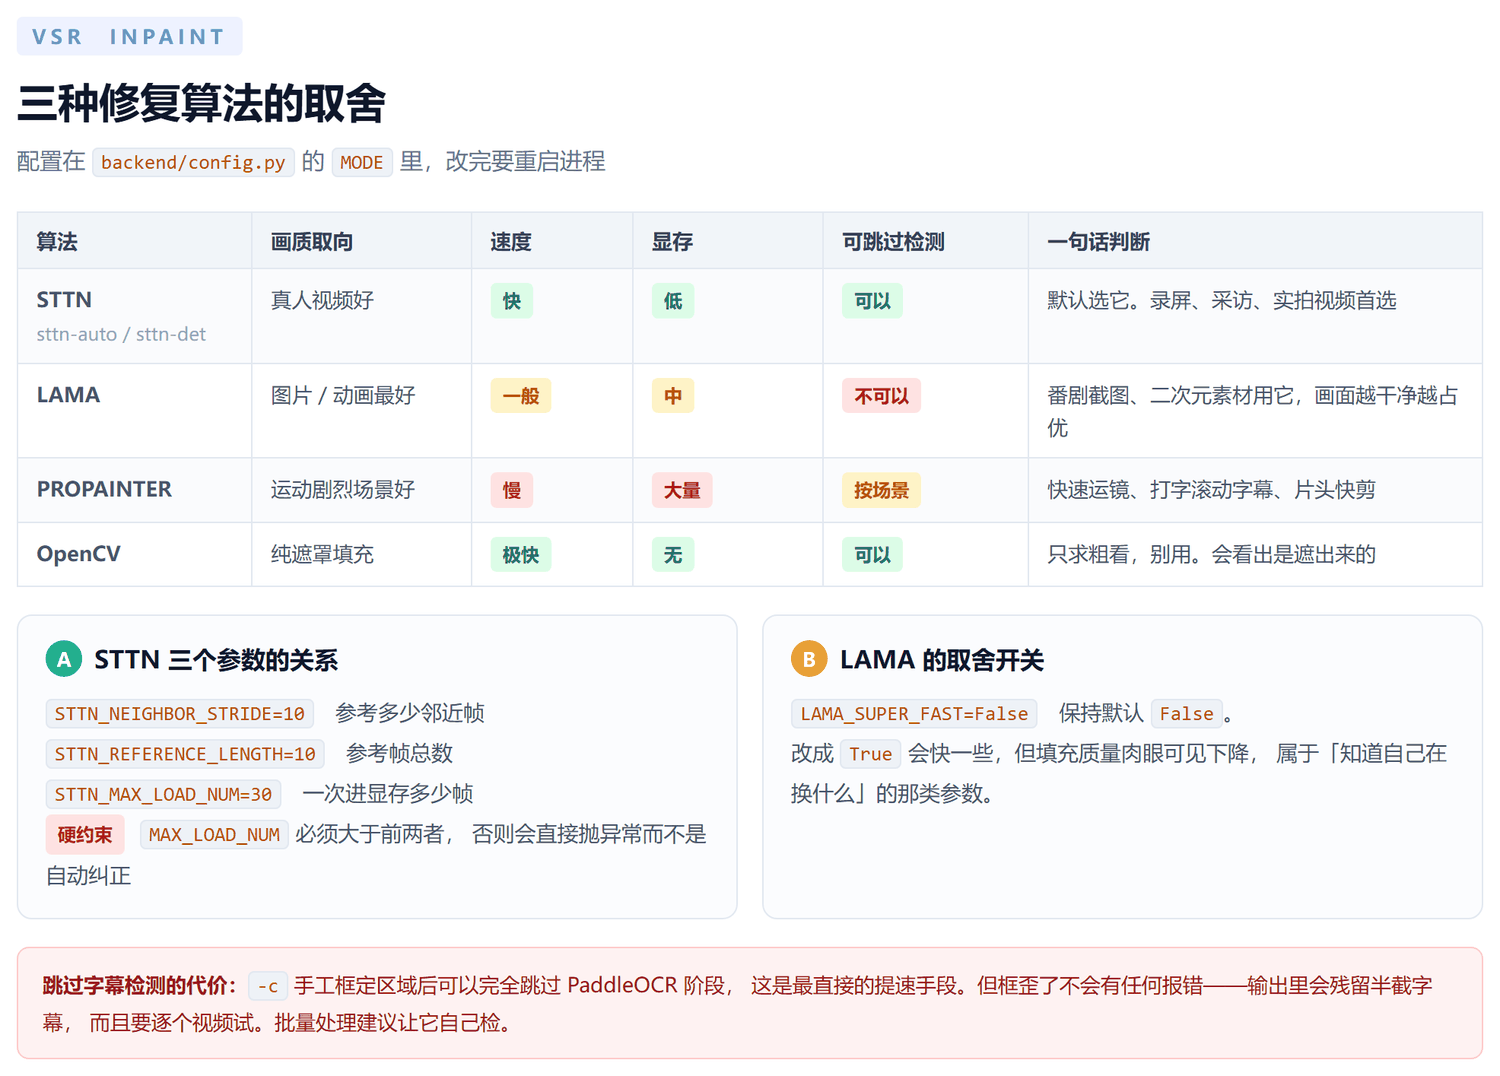
默认 sttn-auto,多数情况不用改
真人视频、录屏、采访类素材,STTN 又快又稳
LAMA 留给静态画面
番剧截图、二次元素材这类,LAMA 明显占优
代价是速度一般,而且不可跳过字幕检测
PROPAINTER 是显存杀手
运动剧烈的片段效果最好,但速度和显存都是最差的一档
STTN 三个参数有硬约束
STTN_NEIGHBOR_STRIDE参考多少邻近帧
STTN_REFERENCE_LENGTH参考帧总数
STTN_MAX_LOAD_NUM一次进显存多少帧
MAX_LOAD_NUM必须大于前两者,不满足会直接抛异常,不会自动纠正
LAMA_SUPER_FAST 别开
默认False,改成True快一些但填充质量肉眼可见下降
7. 跑起来
# 命令行
python ./backend/main.py -i input.mp4 -o output.mp4

# 手工指定字幕区域:-c 接四个数,上下左右,-c 可以多次
python ./backend/main.py -i input.mp4 -o output.mp4 -c 800 950 100 1200

# 指定算法
python ./backend/main.py -i input.mp4 -o output.mp4 --inpaint-mode lama

# 图形界面
python gui.py
-c 的四个数是像素坐标
顺序是YMIN YMAX XMIN XMAX,Y 在前不是 X 在前
给大了会拖慢速度并让周围变糊,给小了字幕去不干净
指定 -c 就等于放弃字幕检测
这是最直接的提速手段,PaddleOCR 那段整个跳过
但框歪了不会有任何报错,输出里残留半截字幕,而且要逐个视频试
批量处理建议让它自己检
先拿十秒样本试参数
拿完整片跑一遍再发现算法选错,机器得白忙几小时
截一小段出来先把-c和--inpaint-mode定下来
输出目录要存在
-o指到不存在的目录会直接失败,不会自动创建
💡 补充几个原文没写的:
抹除不等于提取
这两个方向是分开的项目,要 SRT 用 VSE,要无字幕视频用 VSR
无损的是分辨率,不是码率
原片重编码之后码流必然变,但分辨率和字幕区之外的像素保持不变
对画质敏感的场景,输出后再压制一遍比一次性上高码率更稳
硬字幕才能抹
烧录进画面的才行;外挂的软字幕(.ass、.srt)换个播放器关掉就有,不需要这个工具
models 目录别跟着仓库同步
backend/models/和backend/ffmpeg/都是二进制,体积大
备份代码时排除掉,同步到国内机器也会慢
显存不够先降 STTN_MAX_LOAD_NUM
从 30 往下调,但必须仍然大于NEIGHBOR_STRIDE和REFERENCE_LENGTH
降到 0 报 CUDA 内存不足,说明该换 PROPAINTER 关掉改用小 batch 了
多核机器设一下线程
CPU 模式下OMP_NUM_THREADS不设的话会占满全部核,SSH 会话容易变卡
版本号跟着 Release 走
预构建包、Docker 标签、requirements 三处的版本要对得上
跨版本混用时config.py的参数名可能已经改了
🔥 一句话总结:VSR 部署能走预构建包就别碰源码——
.7z解压、跑python gui.py,Python、Paddle 3.0.0、Torch 2.7.0、FFmpeg 全都配好了;非走源码不可时,Paddle 必须从官方站带-i装paddlepaddle-gpu==3.0.0,Torch 从 PyTorch 官方索引装同 CUDA 版本;conda 和 pip 不要混着装 CUDA 组件,两份 cuDNN 同时在盘上时动态链接器只认LD_LIBRARY_PATH里排在前面的那个;算法默认sttn-auto,静态画面换lama,运动剧烈换propainter,调 STTN 时MAX_LOAD_NUM必须大于另外两个参数。