
4
0
0
随机森林与聚类算法概论
泰坦尼克号生存预测-随机森林分类问题
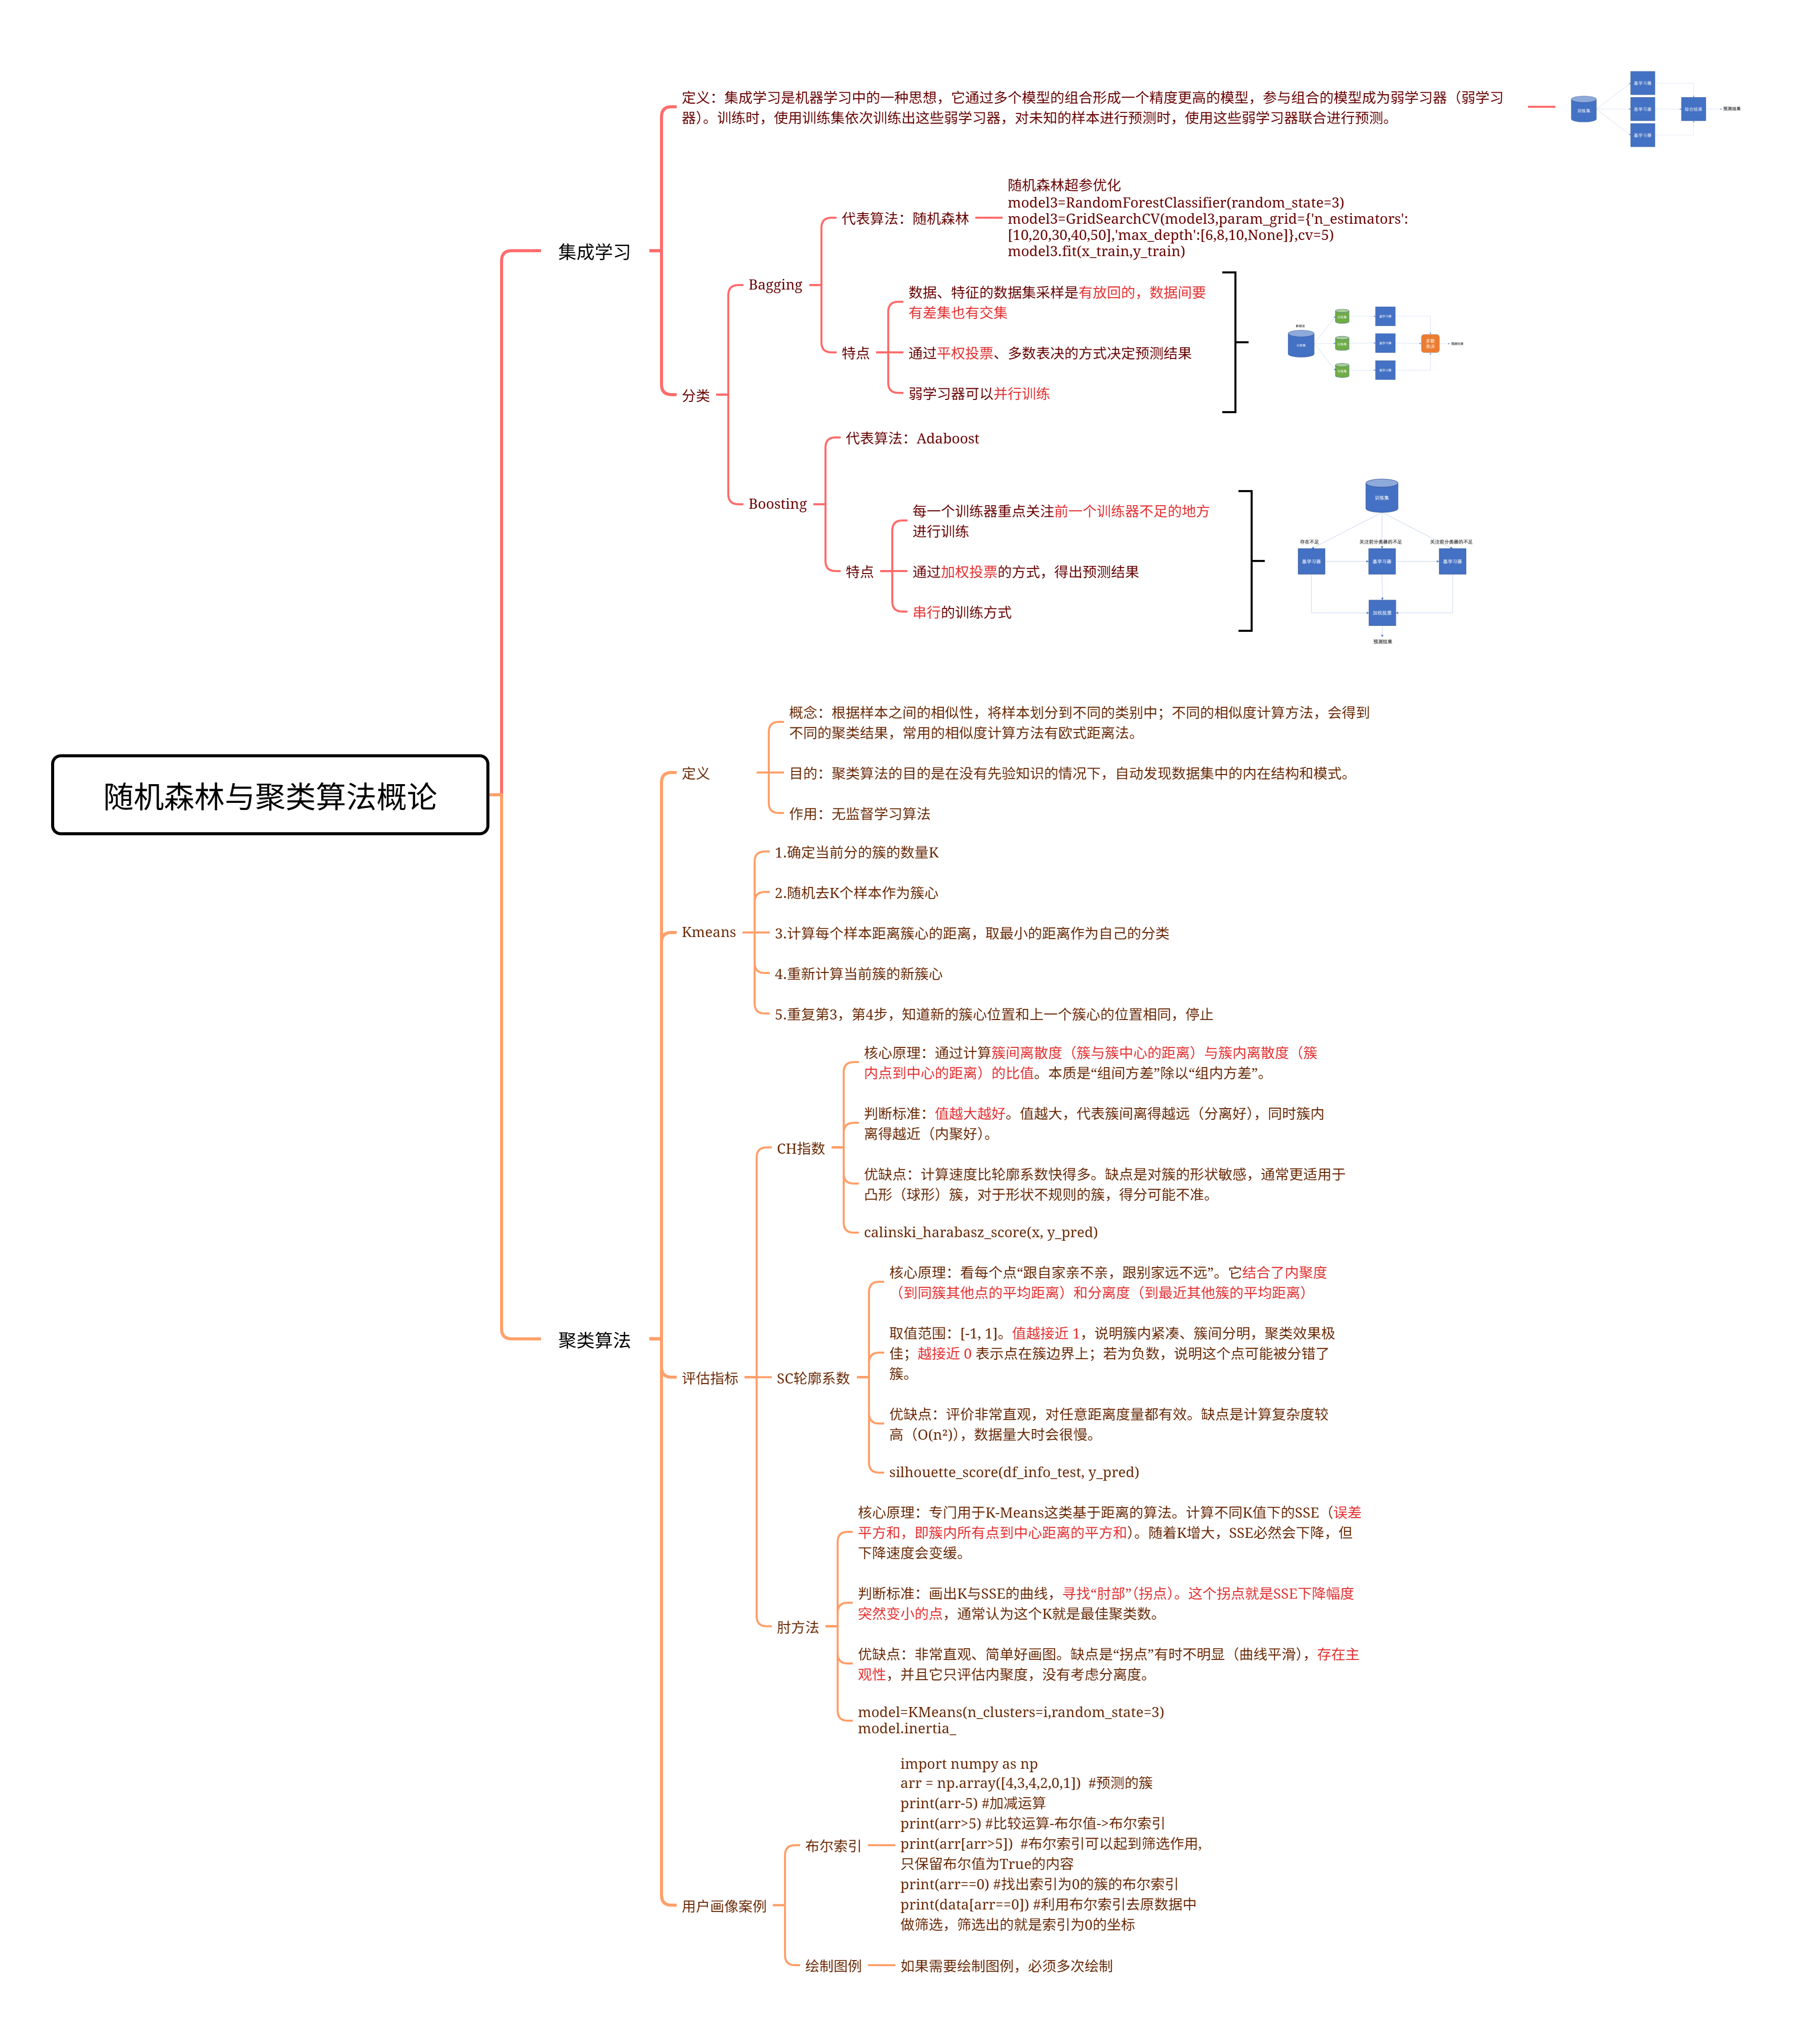
集成学习
bagging - 随机森林
1.有放回的抽样
2.并行执行
3.平权投票/平均值
boosting - Adaboost
1.每一个弱学习器都是基于上一个学习器的问题强化训练
2.串行执行
3.加权投票/加权平均
1.决策树

2.随机森林

3.随机森林(超参优化)
GridSearchCV()
聚类算法-KMeans
聚类算法->无监督学习->只有特征,没有标签->分类
KMeans的执行流程:
1.确定当前分的簇的数量K
2.随机去K个样本作为簇心
3.计算每个样本距离簇心的距离,取最小的距离作为自己的分类
4.重新计算当前簇的新簇心
5.重复第3,第4步,知道新的簇心位置和上一个簇心的位置相同,停止
评估指标:
CH轮廓系数
SSE肘部法
SC轮廓系数
做案例的时候,有一个流程:
1 - 先明确当前的数据需要分为几个簇(SSE,SC)
2 - 按照指定的簇的个数,将数据进行分类
案例 - 用户画像分类
难点:布尔索引
import numpy as np
arr = np.array([4,3,4,2,0,1])  #预测的簇
print(arr-5) #加减运算
print(arr>5) #比较运算-布尔值->布尔索引
print(arr[arr>5])  #布尔索引可以起到筛选作用,只保留布尔值为True的内容
print(arr==0) #找出索引为0的簇的布尔索引
print(data[arr==0]) #利用布尔索引去原数据中做筛选,筛选出的就是索引为0的坐标