
RabbitMQ 从入门到落地:原理、部署、Spring Boot 与最终一致性
📝 笔记摘要:从 MQ 基础到 RabbitMQ 落地
消息队列不是性能优化工具,它是一层故障隔离带。它干的事只有一件:把「必须同时成功」的一堆动作,拆成「先收下、慢慢做」。
拆开之后拿到的是三样东西——削峰、异步、解耦;还回去的是一样东西——数据不再是同一时刻强一致的了。很多系统上了 MQ 之后出问题,根子都在这后半句上。
这篇从头走一遍:先把 MQ 的作用讲透,再说清楚它底下为什么不用 HTTP 以及什么时候不该上它;然后把 RabbitMQ 装起来,版本、apt、Docker、权限、端口、水位、集群一件件过;接着拆开 AMQP 模型和五种交换机,用 Java 客户端和 Spring Boot 各写一遍收发;最后落到最容易被误解的地方——用消息队列做分布式事务。
这篇的结构
1. 消息队列基础:削峰、异步与解耦
2. 为什么 MQ 底下不跑 HTTP,以及什么时候不该上 MQ
3. RabbitMQ 的 AMQP 模型
4. 部署:版本、apt 与 Docker
5. 管理界面、用户标签与端口
6. 运维:内存水位、磁盘阈值与集群
7. 五种交换机模式与队列参数
8. Java 客户端:收发、work 队列与常见坑
9. Spring Boot 整合:声明、TTL 与死信队列
10. 消息队列与分布式事务
1. 消息队列基础:削峰、异步与解耦
1.1 消息队列是什么
MQ 是 Message Queue 的简称,分布式消息中间件。它的工作可以拆成两半:
存
消息先进来,服务端负责落盘,客户端断开、消费者宕机,消息还在
送
消息按规则送到该去的队列,谁订阅了、谁没订阅、谁收到了几条,服务端心里有数
这两半合起来才是可靠投递
只存不送,消息会一直堆着;只送不存,进程一挂全没
市面上的主流中间件定位差别很大,选错比不选更麻烦:
RabbitMQ
AMQP 协议的完整实现,路由规则最细(4 种交换机类型 + 队列参数 + policy)
延迟在微秒到毫秒级,适合业务消息、任务分发、订单解耦
吞吐是万级 TPS 量级,比不过 Kafka,但换来了灵活性
Kafka
本质是分布式日志,消息按分区顺序追加、消费靠 offset 推进
吞吐能到百万级 TPS,横向扩展容易
它不擅长复杂路由,保留期按时间或大小算,适合埋点、日志流、事件溯源
RocketMQ
阿里开源,自带存储引擎,电商场景里长出来的东西
事务消息、延迟消息、顺序消息是它的招牌
ActiveMQ
老牌 JMS 实现,功能齐全但维护活跃度和性能都不占优,新项目很少再选
RabbitMQ 的位置是业务消息队列:它不追求日志流的吞吐,换来的是「这条消息该给谁」这件事可以做得很细。
1.2 削峰:把瞬时洪峰摊到谷值
削峰解决的是一个很具体的场景:服务能扛住平均流量,扛不住瞬时流量。秒杀、促销、整点定时任务、突发热点,都会把请求量在几秒内拉高十倍。
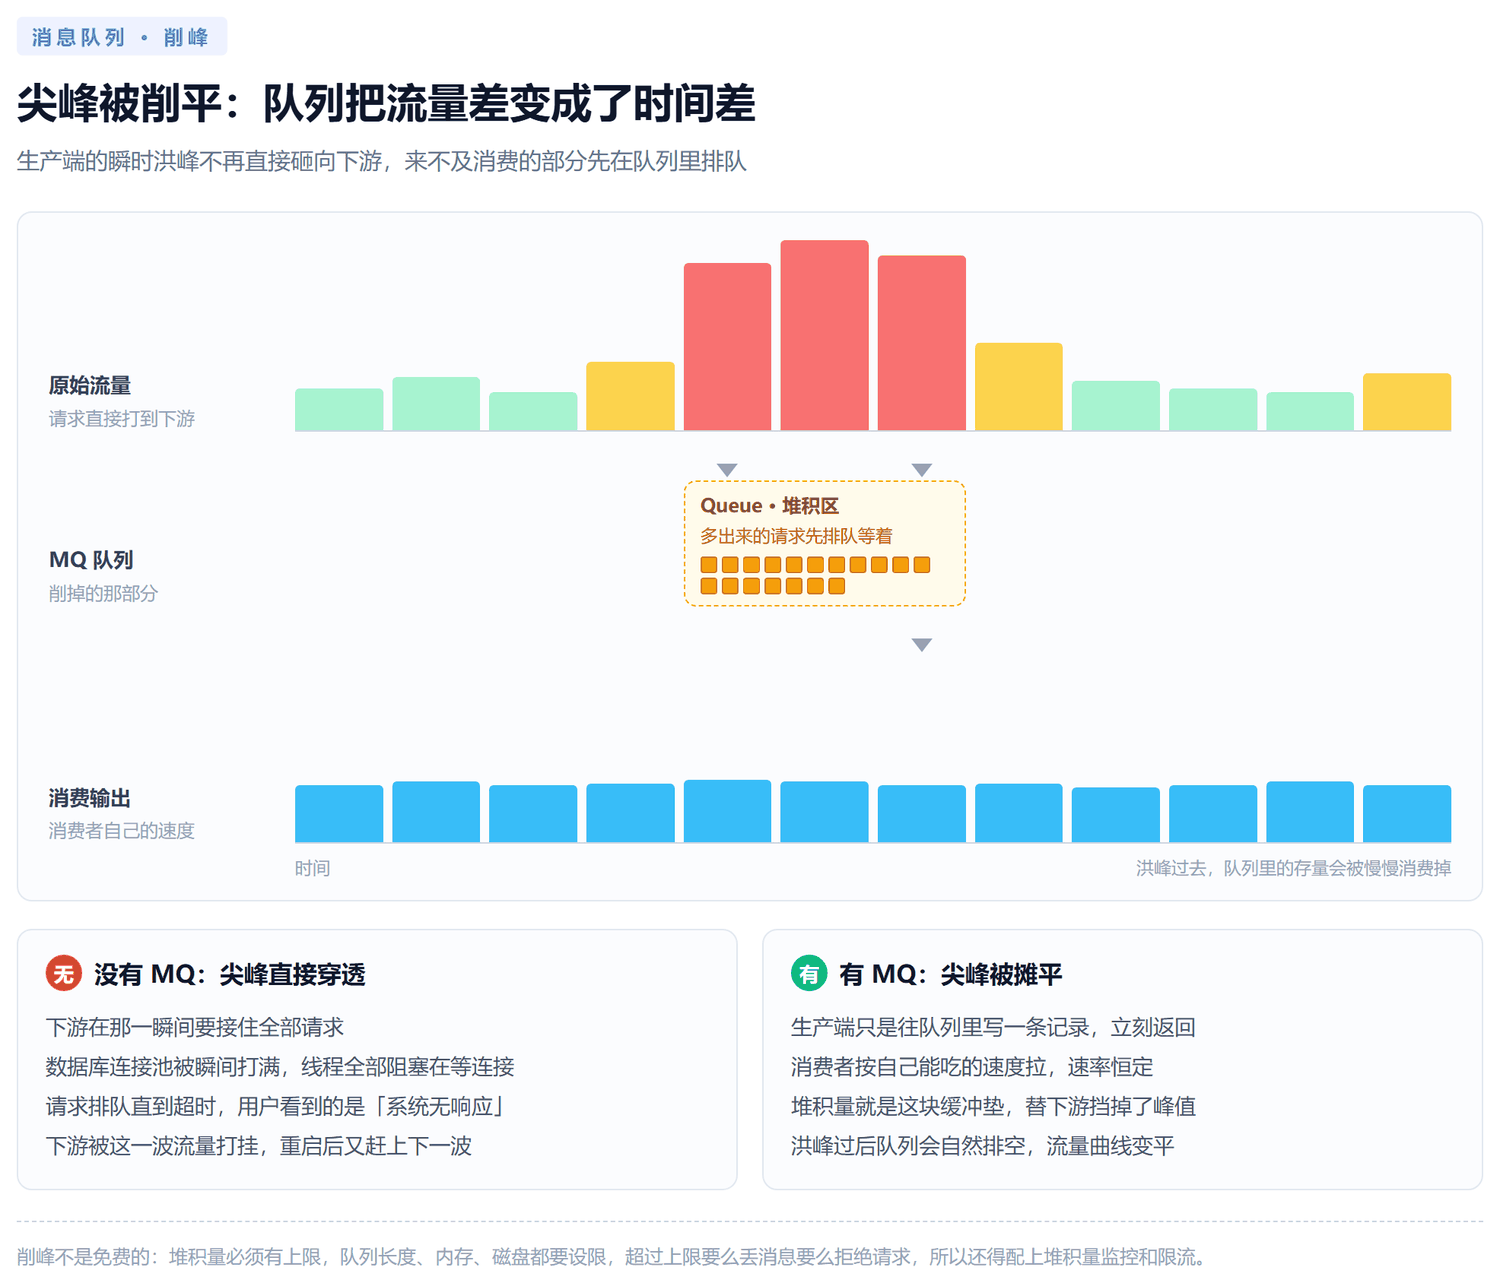
没有 MQ 的时候,尖峰会原封不动地砸到下游:
线程池打满
请求进来没有地方排队,线程全在干活,新请求只能干等
数据库连接池耗尽
所有在跑的请求都在抢连接,抢不到就一起超时
超时重试放大流量
上游等不到结果就重试,10 倍峰值变成 20 倍,这是雪崩的典型起手式
恢复期比峰值期更长
等流量过去、线程释放、连接归还,系统还要再缓一会儿才回到正常水位
有 MQ 之后,入口只做「收下」这一件事:校验参数、把消息丢进队列、立刻返回。队列变成了缓冲区,消费者按自己的处理能力慢慢往外拉。
入口 QPS 变平
不管来 1000 还是 10000 请求,入口的出队速度由它自己的处理能力决定
堆积量是缓冲垫
消费者慢一点没关系,消息在队列里排队等着,不会丢
消费者可以横向扩
发现拉不动就加消费者实例,队列里的存量会被分掉
削峰不是免费的,有三笔账要提前算清楚:
堆积有上限,超了要定规则
队列必须设长度或存活时间上限,超出是丢消息还是拒绝请求,得按业务定
RabbitMQ 里对应的是x-max-length、x-max-length-bytes、x-message-ttl这几个队列参数
削峰是延迟,不是消灭
峰值过去了,积压的几百万条还要花时间消化,这段时间里消息是迟到的
业务上能接受「订单通知晚十分钟到」,才能用削峰
持久化和消费者存活是前提
队列不落盘、消费者刚拿到消息就重启,削峰反而成了丢消息的放大器
这几个队列参数在第 7 章展开。
1.3 异步:把等待从主链路上摘下来
串行执行的意思是:前一个动作不做完,下一个不开始。用户点一次下单,接口里同步发短信、同步发邮件、同步加积分,接口要等这三件事全做完才返回。
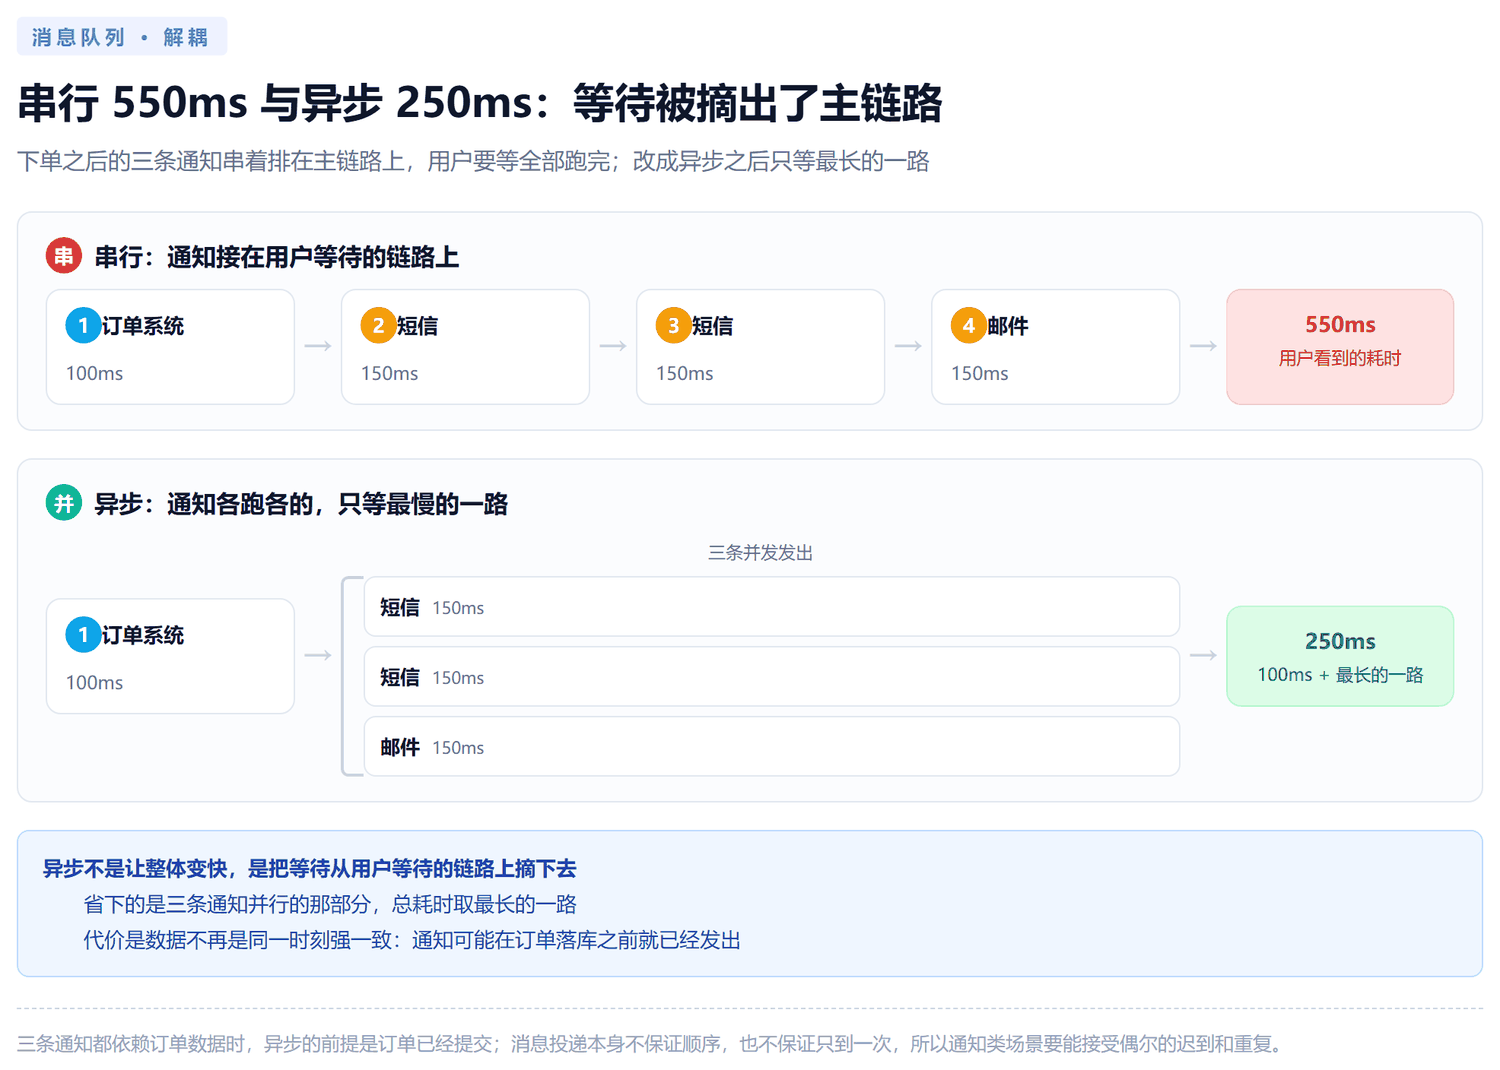
把通知改成异步之后,接口在 100 毫秒就返回了,三个通知在后台各跑各的。
要纠正一个常见说法
异步没有让系统整体变快,总工作量一分没少
它改变的是「谁在等」——等待从用户的操作路径上被摘下去了
用户拿到的是「已受理」而不是「已完成」
产品文案要跟着改,短信通知从「已发送」变成「稍后通知您」
数据不再是同一时刻强一致
订单表里有了记录,短信表里还没有,这就是最终一致
失败必须自己兜
同步调用失败会直接抛给调用方,异步失败没人接,要靠重试、死信队列、补偿任务
排查链路变长
一次请求横跨三个系统,出了问题得顺着消息链路一段段查
异步适合的判断标准很简单:用户不需要立刻知道结果,并且结果晚一点到没关系。发短信、发邮件、刷缓存、同步搜索索引、埋点上报,都在范围内;下单扣库存、支付回调,不在。
1.4 解耦:让上下游各自演进
订单创建之后要通知 5 个下游:短信、邮件、积分、推荐、履约。每加一个下游,就要改一次订单服务的代码,再发一次版。
换成消息队列之后,订单服务只发一条「订单已创建」,5 个下游各自订阅。谁新增、谁下线,订单服务不知道也不需要知道。
解耦真正解掉的是什么
不是「代码不用改了」——下游还是得写自己的消费逻辑
解掉的是上线顺序的依赖和故障范围的传导
短信服务挂了,订单照样下,消息在队列里等短信服务恢复
前提是下游能独立处理
每个下游都得能接受「这条消息我可能收不到、可能收两次」
做不到这一点,解耦就是甩锅
解耦的代价是排查变难
以前一眼能看到的调用关系,现在散落在各个订阅方
建议一开始就给消息定好命名规范和来源标记,别等到半年后查不动
失败要怎么兜,幂等和补偿在第 9 章和第 10 章展开。
2. 为什么 MQ 底下不跑 HTTP,以及什么时候不该上 MQ
2.1 为什么 MQ 底下不跑 HTTP
常见的说法是三条:HTTP 协议太复杂、数据太冗余;HTTP 是短连接,断了就丢数据。这两条其实都站不住。
「短连接会丢数据」不成立
HTTP 有 keep-alive 长连接;就算连接断了,丢的是连接不是消息
消息可不可靠,取决于服务端有没有先落盘,跟连接类型没关系
「HTTP 太复杂」不是主因
HTTP 报文确实比自定义二进制协议冗余,但内部系统用 HTTP 搭消息队列的例子多的是
把消息先写进数据库表、HTTP 轮询这张表,规模不大时完全能用
Kafka 和 RocketMQ 都不用 HTTP
两家都换成了自己的二进制协议,理由跟「HTTP 太复杂」无关
真正的原因是MQ 协议要提供 HTTP 不提供的那几件事:
持久化 + 投递确认
消息先落盘再回 ACK,连接断了消息还在队列里
投递语义
at-most-once、at-least-once、exactly-once 三档,要由协议和参数来兑现
路由规则
Exchange + Binding Key 的多路投递,一个 HTTP URL 表达不了「这条消息给这三个队列」
流控与背压
prefetch、QoS,客户端处理不过来时服务端要能感知并停下来
消费者状态管理
谁在消费、消费到哪一条、要不要重投、投递几次后放弃
AMQP 就是把这些能力标准化成一个跨语言协议,客户端写一次、Broker 实现一次
所以问题不是「HTTP 能不能做消息队列」,而是「你要不要自己把这套东西实现一遍」。
2.2 什么时候不该上 MQ
MQ 是有代价的,下面这些场景上它只会让事情变复杂:
调用链本来就低频、且必须同步拿结果
一天调两次,还要等返回,加 MQ 只是多一跳
数据量小、调用方就一两个
直接 HTTP 调用,出问题在调用链上一眼看得到
要求强一致且没法做补偿
扣款、入账这类动作上 MQ 之后,一致性问题从「事务解决」变成「补偿解决」,工作量大得多
团队没有运维能力
MQ 挂了得有人看、堆积得有人查、磁盘满了得有人扩容,没有这些能力就是给自己埋雷
架构图好看
这一条最常见,也最贵
2.3 选型:RabbitMQ、Kafka 还是 RocketMQ
按要解决的问题去选,不要按熟悉度去选:
业务消息、路由规则复杂、要求低延迟
选 RabbitMQ。延迟低,交换机类型和队列参数给得很细,排查工具有界面
日志流、埋点、事件溯源、吞吐是第一位
选 Kafka。它是日志不是队列,消费位点自己维护,保留期到了数据就没了
电商事务消息、延迟消息、顺序消息
选 RocketMQ,事务消息和延迟消息是它自带的
只是想异步一下,量不大
数据库表 + 定时任务 + 唯一索引去重,先扛住,别一上来就上中间件
💡 概念篇里几个容易想歪的地方
MQ 解的是时间和空间上的耦合
逻辑上的耦合一点没少,下游该校验的还是要校验
可靠性有两层,缺一不可
MQ 侧不丢(落盘 + 确认)和消费侧不丢(处理成功才 ACK)是两件事
消费侧丢消息最常见的原因就是用了自动 ACK,处理失败时消息早就被确认掉了
重复消费是常态,不是异常
at-least-once 是绝大多数场景的现实答案,消费者必须幂等
别指望 MQ 帮你做 exactly-once,跨系统的 exactly-once 是要靠幂等键和去重表做出来的
3. RabbitMQ 的 AMQP 模型
3.1 一次收发经过哪些部件
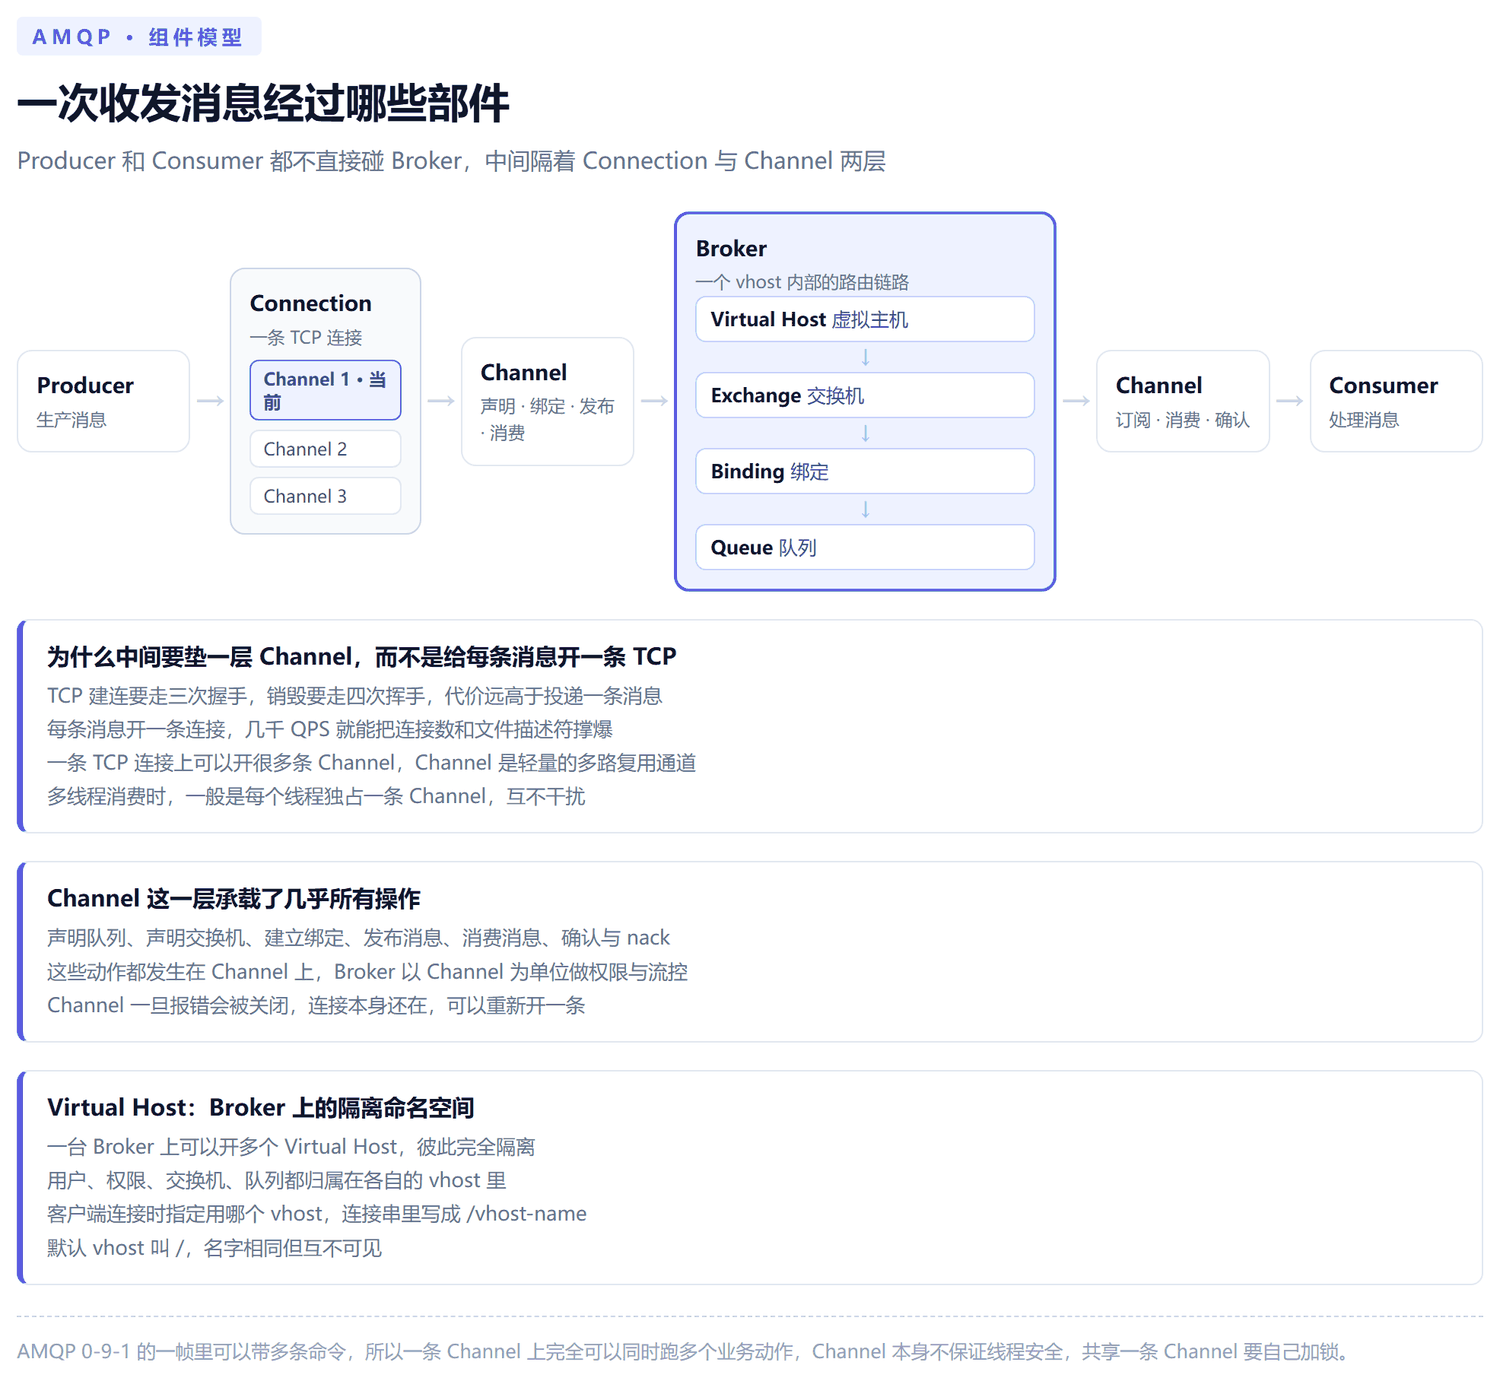
按消息实际走的顺序,一个字一个字过一遍:
Producer(生产者)
只负责「发消息」,不关心消息最后到哪个队列
ConnectionFactory(连接工厂)
配置的载体,地址、账号、vhost 都在这儿设
它是工厂不是连接,调用newConnection()才拿到连接
Connection(连接)
应用与 Broker 之间的一条 TCP 长连接
AMQP 跑在 TCP 之上,用认证和 TLS 保护
连接不用了就优雅关闭,别直接断 TCP
Channel(信道)
建在 Connection 之上的轻量级通道,绝大多数操作都在这一层
声明队列、声明交换机、绑定、发布、消费,全是 Channel 的方法
一个 Connection 上可以开任意多条 Channel
Broker(中间件)
RabbitMQ 服务端,接受连接,实现 AMQP 的实体
Virtual Host(虚拟主机)
Broker 上的逻辑隔离区,用户、交换机、队列、权限都隔离在各自的 vhost 里
Exchange(交换机)
只做路由,不存消息,拿到消息后投给零个、一个或多个队列
Binding(绑定)
Exchange 和 Queue 之间的规则,规则里带 Binding Key
Routing Key(路由键)
发布消息时带的路由标识,和 Binding Key 一起决定消息去哪
Queue(队列)
消息真正待着的地方,等着被消费掉
最容易搞混的是最后三个:
Exchange 不存消息
它是路由器不是仓库,消息到了交换机就当场决定往哪投,投不出去就没了
Routing Key 是消息带的,Binding Key 是绑定带的
两者相等(或按类型匹配)消息才被投过去
没绑定的队列会绑到默认交换机
默认交换机的 routing key 就是队列名,所以能精确投到那一个队列
要把这些部件跑起来,先看第 4 章的部署。
3.2 为什么用 Channel 不用直接开 TCP
这是 AMQP 设计里最实用的一处取舍。TCP 建连要三次握手,销毁要四次挥手,每条消息开一条连接,光握手开销就能把系统拖垮;操作系统对单机的 TCP 连接数也有上限,撑到上限之后新连接根本建不起来。
信道的模型
一条 TCP 连接上开很多条 Channel,一条线程用一条 Channel
多线程共用同一条 TCP 连接,连接数不变,吞吐照样能上去
为什么这样设计是划算的
Channel 是 Broker 内部的一个轻量会话对象,创建和销毁几乎不花钱
而 TCP 连接是操作系统对象,创建和销毁都要走内核协议栈
对应到实践
消费端用线程池,每个线程建一条 Channel,不要共用一条
用完记得关 Channel 和 Connection,连接池要设上限
3.3 Virtual Host:Broker 上的隔离区
一个 Broker 上通常要跑好几套业务,每套业务的用户、交换机、队列不能互相看见也不能互相覆盖。vhost 就是干这个的。
隔离的是一整套命名空间
用户、用户权限、Exchange、Queue、Policy 全部按 vhost 隔离
客户端连接时就要指定
AMQP 连接建立时必须带上 vhost,不指定默认是/
命名可以重复
第 4 章「部署」里说过,同一个 vhost 内不能有同名的 Exchange,跨 vhost 同名互不冲突
不是安全边界,是隔离手段
真要防不同团队互相使坏,还得靠用户权限和 TLS,vhost 主要用来做逻辑划分
4. 部署:版本、apt 与 Docker
4.1 先看版本,这条最要紧
截至 2026 年 10 月,RabbitMQ 的版本状况是这样:
4.3 是唯一还有社区支持的线
最新补丁 4.3.6,2026 年 9 月发布,社区支持到 2027 年 1 月 31 日
4.2 及以下全部结束社区支持
4.2 于 2026 年 7 月 31 日结束,4.1 在 2026 年 1 月,4.0 在 2025 年 4 月,3.13 在 2024 年 9 月
再往前 3.12、3.11、3.10 全都 EOL
只剩商业支持还挂着
EOL 意味着不再有免费的安全补丁,CVE 出了也不会给你修
Erlang 26 也已经 EOL
4.x 需要 Erlang 27 起,官方文档里明写「Erlang 26 has reached end of life and is no longer supported」
3.13 及更早的版本锁死在 Erlang 26 上,等于运行时也没有安全补丁了
所以判断标准很简单:要装 4.3.x,Erlang 要 27 以上。还在跑 3.10、3.12 的实例,该升了。
4.3.0 起还有两个变化要知道
classic 队列 v1 被彻底移除,声明时带x-queue-mode或x-queue-version=1会直接失败
元数据存储只剩 Khepri,Mnesia 在 4.3 里被移除,4.2 起它就是默认了
非持久化、非排他的 transient 队列默认禁止,需要时得显式打开deprecated_features.permit.transient_nonexcl_queues
4.2 用 apt 装:发行版自带的源装不到 4.x
这是最常见的坑。直接装:
sudo apt-get install rabbitmq-server装出来的东西是这样的:
Ubuntu 24.04(noble)
3.12.1 —— 还在 3.x 线,社区支持 2024 年就结束了
Debian 12(bookworm)
3.10.8 —— 更老
Debian 13(trixie)
4.0.5 —— 版本号看着新,但 4.0 的社区支持 2025 年 4 月就结束了
官方文档在这个位置挂的是红色警告:发行版自带的 rabbitmq-server 包版本落后很多,通常已经超出社区支持,甚至已经 EOL。原因是 Debian/Ubuntu 的发布节奏是按年走的,包不可能跟上 RabbitMQ 的补丁节奏。
要装 4.x,得自己加 Team RabbitMQ 自己的 apt 源,Erlang 也从这个源里装。以下是官方文档里针对 Ubuntu 24.04 的 quick start:
# 1. 装依赖
sudo apt-get install curl gnupg apt-transport-https -y

# 2. 导入 Team RabbitMQ 的签名密钥
curl -1sLf "https://keys.openpgp.org/vks/v1/by-fingerprint/0A9AF2115F4687BD29803A206B73A36E6026DFCA" \
  | sudo gpg --dearmor \
  | sudo tee /usr/share/keyrings/com.rabbitmq.team.gpg > /dev/null

# 3. 加源(Erlang 和 RabbitMQ 各两条,deb1 挂了还有 deb2)
echo "deb [arch=amd64 signed-by=/usr/share/keyrings/com.rabbitmq.team.gpg] https://deb1.rabbitmq.com/rabbitmq-erlang/ubuntu/noble noble main" | sudo tee /etc/apt/sources.list.d/rabbitmq.list
echo "deb [arch=amd64 signed-by=/usr/share/keyrings/com.rabbitmq.team.gpg] https://deb2.rabbitmq.com/rabbitmq-erlang/ubuntu/noble noble main" | sudo tee -a /etc/apt/sources.list.d/rabbitmq.list
echo "deb [arch=amd64 signed-by=/usr/share/keyrings/com.rabbitmq.team.gpg] https://deb1.rabbitmq.com/rabbitmq-server/ubuntu/noble noble main" | sudo tee -a /etc/apt/sources.list.d/rabbitmq.list
echo "deb [arch=amd64 signed-by=/usr/share/keyrings/com.rabbitmq.team.gpg] https://deb2.rabbitmq.com/rabbitmq-server/ubuntu/noble noble main" | sudo tee -a /etc/apt/sources.list.d/rabbitmq.list

# 4. 更新索引
sudo apt-get update -y

# 5. 装 Erlang 组件
sudo apt-get install -y erlang-base \
  erlang-asn1 erlang-crypto erlang-eldap erlang-ftp erlang-inets \
  erlang-mnesia erlang-os-mon erlang-parsetools erlang-public-key \
  erlang-runtime-tools erlang-snmp erlang-ssl \
  erlang-syntax-tools erlang-tftp erlang-tools erlang-xmerl

# 6. 装 RabbitMQ
sudo apt-get install rabbitmq-server -y --fix-missing
为什么 Erlang 要一个一个组件装
官方明确说:erlang、erlang-nox这类元包只有在配合 apt 版本锁定时才能用,因为它们不锁定依赖版本
直接apt-get install erlang-nox很可能拉进来一堆旧版本组件,和 4.x 要求的 Erlang 27 冲突
密钥不要用 apt-key 装
apt-key已经被 Debian 废弃,正确姿势是gpg --dearmor写到/usr/share/keyrings/,然后在 sources 里用signed-by=指过去
源地址里的发行版代号要跟着系统改
Ubuntu 24.04 是noble,22.04 是jammy,Debian 12 是bookworm,路径前缀也不一样(Ubuntu 是ubuntu/,Debian 是debian/)
换源别忘了改 Erlang 的源
只加 RabbitMQ 源不换 Erlang 源,系统自带的 Erlang 版本大概率不满足 4.x 的要求
装完之后:
# 看版本,确认是 4.3.x
rabbitmqctl version
sudo rabbitmqctl status

# 开机自启 + 启停
sudo systemctl enable --now rabbitmq-server
sudo systemctl stop rabbitmq-server
sudo systemctl start rabbitmq-server

# 看日志
sudo journalctl --system | grep rabbitmq
# 或直接看日志文件
sudo tail -f /var/log/rabbitmq/rabbit@$(hostname).log
日志轮转已经配好了
包会自带/etc/logrotate.d/rabbitmq-server,默认按周轮转和压缩,不用自己写
配置文件在哪
/etc/rabbitmq/rabbitmq.conf,改完要重启服务生效
/etc/rabbitmq/conf.d/下的分文件也会被加载,适合放不同用途的配置
4.3 用 Docker 装
官方文档给的最简命令:
docker run -it --rm --name rabbitmq -p 5672:5672 -p 15672:15672 rabbitmq:4-management镜像 tag 的规则是 <版本>[-management]:rabbitmq:4-management 是滚动到 4.x 最新补丁,rabbitmq:4.3-management 钉在 4.3 线,rabbitmq:4.3.6-management 钉到具体补丁。带 -management 的变体已经把管理插件打包进去了,不用再进去 rabbitmq-plugins enable。
生产环境建议这样起:
docker run -d \
  --name rabbitmq \
  --hostname rabbitmq \
  --restart unless-stopped \
  -p 5672:5672 \
  -p 15672:15672 \
  -p 25672:25672 \
  -v rabbitmq_data:/var/lib/rabbitmq \
  -v rabbitmq_conf:/etc/rabbitmq/conf.d \
  -e RABBITMQ_DEFAULT_USER=appuser \
  -e RABBITMQ_DEFAULT_PASS='<强密码>' \
  -e RABBITMQ_ERLANG_COOKIE='<随机串>' \
  rabbitmq:4.3-management
数据必须挂出来
不挂/var/lib/rabbitmq卷,容器一删队列和元数据全没
配置也要挂出来
进容器改rabbitmq.conf改完就随容器一起没了,必须挂/etc/rabbitmq/conf.d
环境变量只对首次初始化生效
RABBITMQ_DEFAULT_USER这些只在数据目录为空时写进配置,容器重建后改了也不会变
要改账号用rabbitmqctl
25672 端口只有集群才需要
单节点不用映射,但集群时必须保证节点之间能通
官方镜像默认用rabbitmq:4-management就够
生产环境钉具体补丁号,升级走「改 tag → 重建容器 → 数据卷复用」,出问题能回退
5. 管理界面、用户标签与端口
5.1 管理界面和账号权限
管理界面在 15672 端口,打开是 RabbitMQ 的 Web UI:
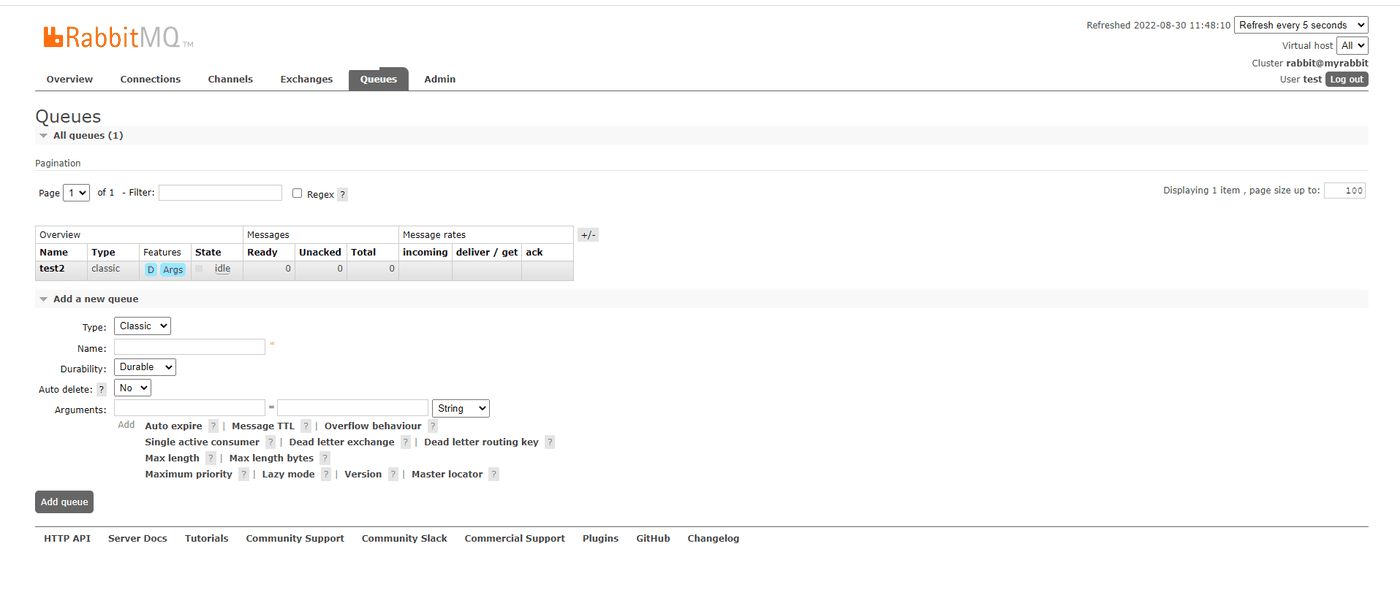
队列名旁边的 D 徽标是持久化标记
没有 D 的队列,Broker 一重启就没
Queues 页面能干什么
Overview 看队列基本状态,Consumers 看谁在消费,Bindings 看绑在哪些交换机上
Publish message 往队列里发消息,Get message 取一条出来看
别用 Get message 测消费
它会把消息真的取走,队列里就没了
要测消费效果用 Publish message
默认账号 guest 只能从本机登录。远程连会报这么一行:
PLAIN login refused: user 'guest' can only connect via localhost官方不建议用 loopback_users = none 把 guest 放开,正确做法是建独立账号:
# 建用户
rabbitmqctl add_user appuser '<强密码>'

# 给权限:configure / write / read
rabbitmqctl set_permissions -p "/" appuser ".*" ".*" ".*"

# 给管理员标签
rabbitmqctl set_user_tags appuser administrator用户标签一共七档,权限是层层叠加的:
none
什么都做不了,访问管理界面都进不去
impersonator
可以冒充其他用户
management
能通过 AMQP 做任何事;列出自己的 vhost;看自己的队列、交换机、绑定;查看和关闭自己的连接
policymaker
management 的全部,再加能创建和删除自己 vhost 里的 policy 和 parameter
monitoring
management 的全部,再加能列出所有 vhost、看别人的连接和连接数、看节点级别的集群和内存数据
administrator
前面所有权限,再加创建和删除 vhost、管理用户、管理权限、关掉别人的连接
管生产环境只给 management 通常够了
administrator 能删用户能改权限,给出去等于把整个 Broker 的控制权交出去
队列的 durable 参数在第 7 章讲。
5.2 放行端口
端口要按需开,不要图省事全开:
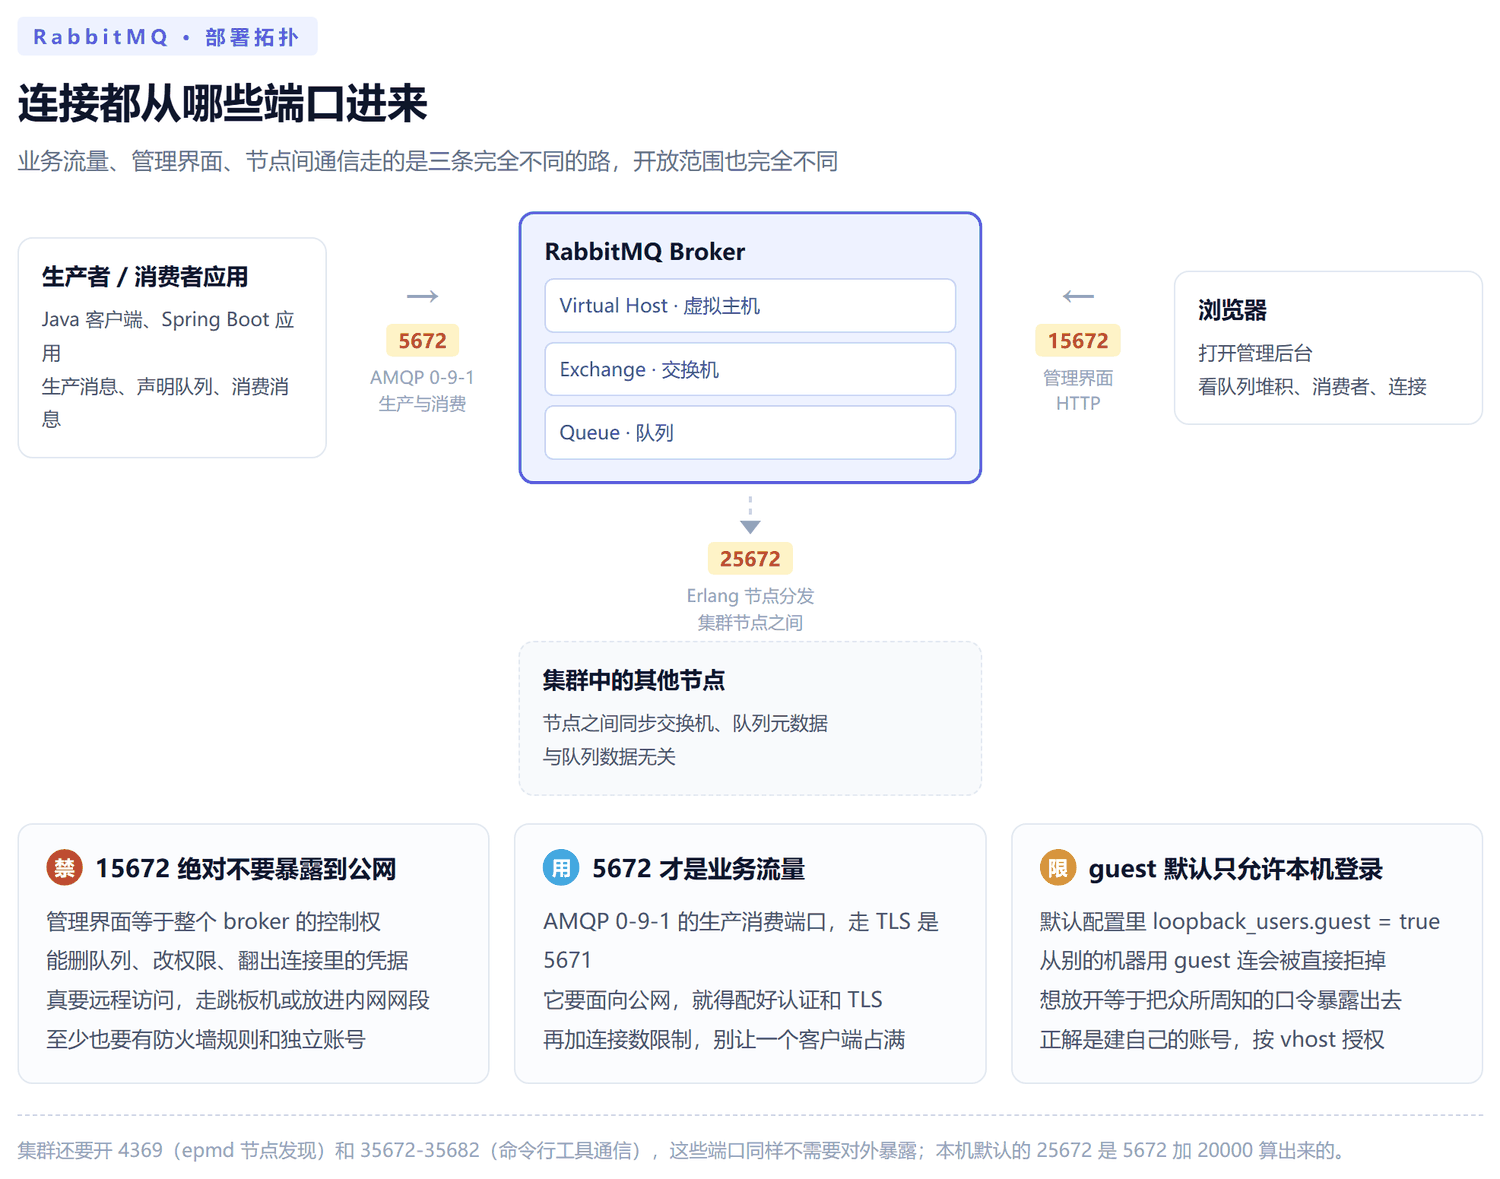
5672 AMQP,业务流量,需要对应用开放
15672 管理界面,只对管理网段或者 VPN 开放
25672 Erlang 节点分发,集群节点之间必须互通,单节点不用开
5671 / 15671 是这两个端口的 TLS 版本,启用 TLS 之后用它们
CentOS 上放行端口的写法,CentOS 7 防火墙常用操作那篇有完整的 firewalld 用法:
# 运行时立刻生效
firewall-cmd --add-port=5672/tcp
# 写进永久配置,重启也在
firewall-cmd --permanent --add-port=5672/tcp
firewall-cmd --permanent --add-port=15672/tcp
# 把永久配置刷进运行时
firewall-cmd --reload
6. 运维:内存水位、磁盘阈值与集群
6.1 内存与磁盘水位
这两条阈值决定 RabbitMQ 什么时候停止接受新消息,是线上最需要提前配好的参数。
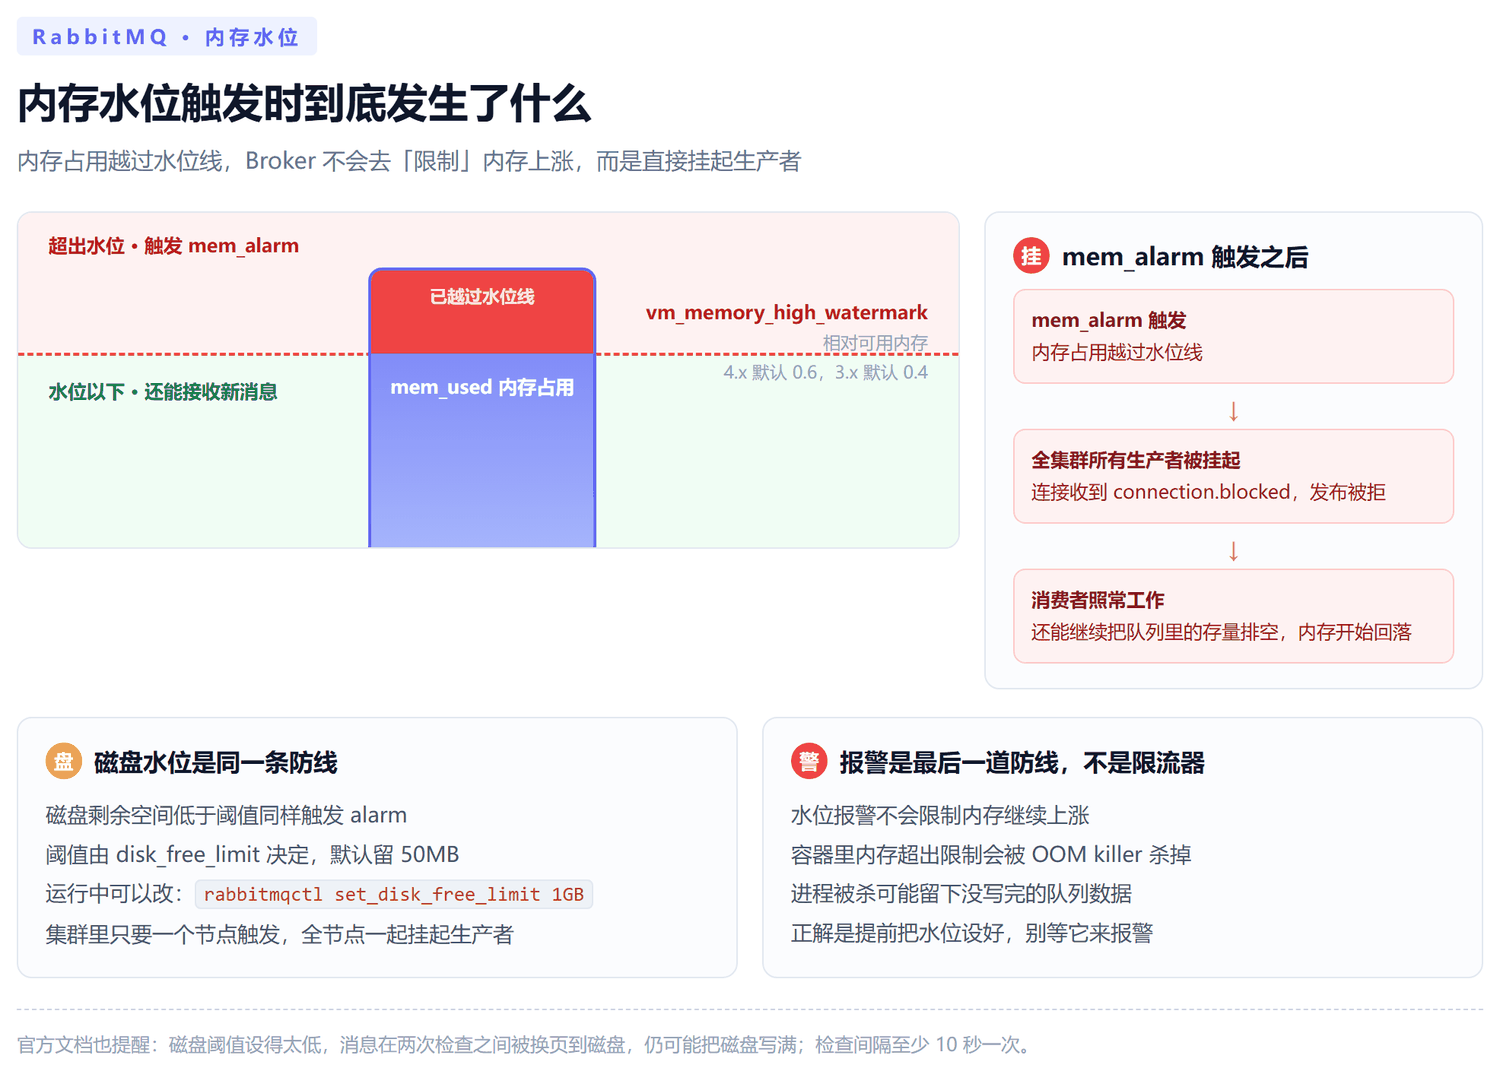
内存水位线的默认值变了
3.x 是 0.4,4.0 起改成 0.6,3.x 的配置文件直接拿过来用,行为会变
两种写法
相对比例:rabbitmqctl set_vm_memory_high_watermark 0.6
绝对值:rabbitmqctl set_vm_memory_high_watermark absolute "4G"
配置文件里对应vm_memory_high_watermark.relative和vm_memory_high_watermark.absolute
容器里推荐用绝对值
相对比例是按宿主机识别到的内存算的,容器里这个数经常不对
绝对值按容器限额填,留出非 JVM 的开销空间
系统识别不出内存时
用total_memory_available_override_value指定一个总内存基数,让比例算法有个准数
磁盘这边:
磁盘剩余空间低于阈值就触发 alarm
运行期改:rabbitmqctl set_disk_free_limit 1GB
配置文件里:disk_free_limit.absolute = 1GB,也可以用disk_free_limit.relative按比例设,两个都设时绝对值优先
报警的动作是「挂起生产者」
不是丢消息,是让所有生产者连接收到connection.blocked,停止投递
消费者不受影响,还能继续把队列排空
alarm 是最后一道防线,不是限流器
它不限制内存继续上涨,超过容器限制会被 OOM killer 杀掉,进程被杀可能带着元数据一起损坏
正解是提前把水位设好,别等报警
6.2 多节点集群
集群的核心是三件事:节点名要能解析、Erlang cookie 必须一致、元数据在各节点同步。
用 Docker 起多节点,现代做法是这样:
# 建一个用户自定义网络,让容器之间按名字互通
docker network create rabbitmq-net

# 第一个节点
docker run -d \
  --name rabbit01 --hostname rabbit01 --network rabbitmq-net \
  -p 5671:5672 -p 15671:15672 \
  -e RABBITMQ_ERLANG_COOKIE='<所有节点必须一致>' \
  -e RABBITMQ_NODENAME=rabbit@rabbit01 \
  rabbitmq:4.3-management

# 第二个节点
docker run -d \
  --name rabbit02 --hostname rabbit02 --network rabbitmq-net \
  -p 5672:5672 -p 15672:15672 \
  -e RABBITMQ_ERLANG_COOKIE='<和第一个完全一样>' \
  -e RABBITMQ_NODENAME=rabbit@rabbit02 \
  rabbitmq:4.3-management
把第二个节点并进集群:
# 4.1.0 起一条命令就行,不需要先 stop_app / reset
docker exec rabbit02 rabbitmqctl join_cluster rabbit@rabbit01

# 看集群状态,两个节点都在就对了
docker exec rabbit01 rabbitmqctl cluster_status
cookie 不一致,节点互不认识
这是集群搭不起来最常见的原因,报错是could not contact a running RabbitMQ node或者认证相关的错
cookie 是 Erlang 分布式节点的信任凭据,每个节点必须完全一致
节点名要能被其他节点解析
用--hostname固定主机名,加进同一个网络,Docker 内置 DNS 会按名字解析
RABBITMQ_NODENAME要写成rabbit@<hostname>的形式,@ 后面就是主机名
不要用--link连容器
那是老式做法,参数在 Docker 里已经废弃,现代做法就是用户自定义网络
4.1.0 之前的老流程
stop_app→reset→join_cluster→start_app,现在仍然能用,但没必要绕这一圈
生产环境用自动 peer discovery
官方推荐生产用自动发现机制自动组网,手工join_cluster主要用于开发和测试
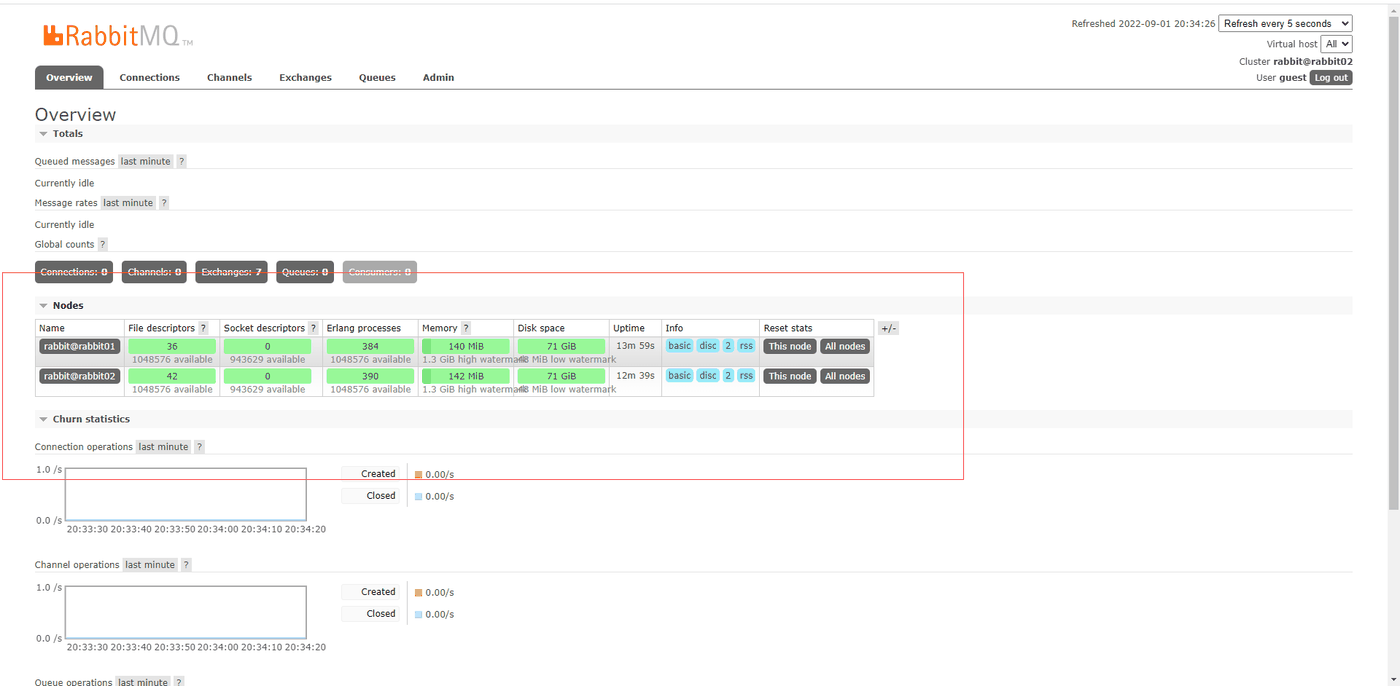
主从这个说法要改改了
4.x 的集群没有「主节点」和「从节点」的说法,队列数据在多个副本之间同步
但元数据是共享的,节点之间靠rabbitmqctl cluster_status看谁是集群元数据的持有者
4.2 起元数据存储换成 Khepri
4.3 里 Mnesia 已经被彻底移除,cluster_partition_handling这类老参数接受但不再起作用
6.3 安全:管理界面别暴露到公网
管理界面能干什么?建用户、删队列、看消息内容、导出队列。拿到这个界面等于拿到整个 Broker 的控制权。
只在内网或者 VPN 上开 15672
要远程访问,走跳板机或者 VPN,别直接暴露
一定要暴露的话,前面挂反向代理并且加认证
Nginx Proxy Manager 部署那篇讲了怎么用图形化界面挂反代和签证书
生产环境考虑关掉管理插件
真不需要图形界面就rabbitmq-plugins disable rabbitmq_management,需要时再开
业务端口也要考虑 TLS
AMQP over TLS 走 5671,客户端连的时候用amqps://
改掉默认口令
Docker 部署时RABBITMQ_DEFAULT_PASS一定要换成强口令
💡 部署和运维里几个容易想歪的地方
管理界面那个「channels 页面报错」的偏方已经过时
早期版本为了修管理界面空白,要设management_agent.disable_metrics_collector = false
现在这个配置的语义反过来了:默认就是 false,只有你主动关掉内置指标采集改用 Prometheus 时才设 true
照着老教程去改,等于白改一遍还可能开反了
端口不是越多越好
默认开的 5672、15672、25672 之外,MQTT、STOMP、Web STOMP 这些端口都要插件显式启用才会监听
4.x 起 quorum 队列才是首选
quorum 队列从 4.0 起默认x-delivery-limit=20,消息重投超过 20 次会被丢弃或进死信队列
用 classic 队列(4.3 起只有 v2)就享受不到这套复制和一致性保证
副本位置参数改名了
x-queue-master-locator在 4.x 换成了x-queue-leader-locator,policy 里的键叫queue_leader_locator
7. 五种交换机模式与队列参数
7.1 交换机:消息的路由器
交换机不存消息,只决定「这条消息投给谁」。类型决定了匹配规则,共有五种。
default(默认交换机)
每个 Broker 都有,名字就是空字符串
routing key 必须精确等于队列名,投不进任何队列的消息直接丢弃
direct(精确匹配)
routing key 与 binding key 完全相等才投递
例:绑了sms,那么 routing key 是sms的能收到,sms.send收不到
fanout(广播)
忽略 routing key,所有绑定的队列各收一份
用来做「一条消息触发多个下游」,比如订单创建后同时通知短信和积分
topic(通配匹配)
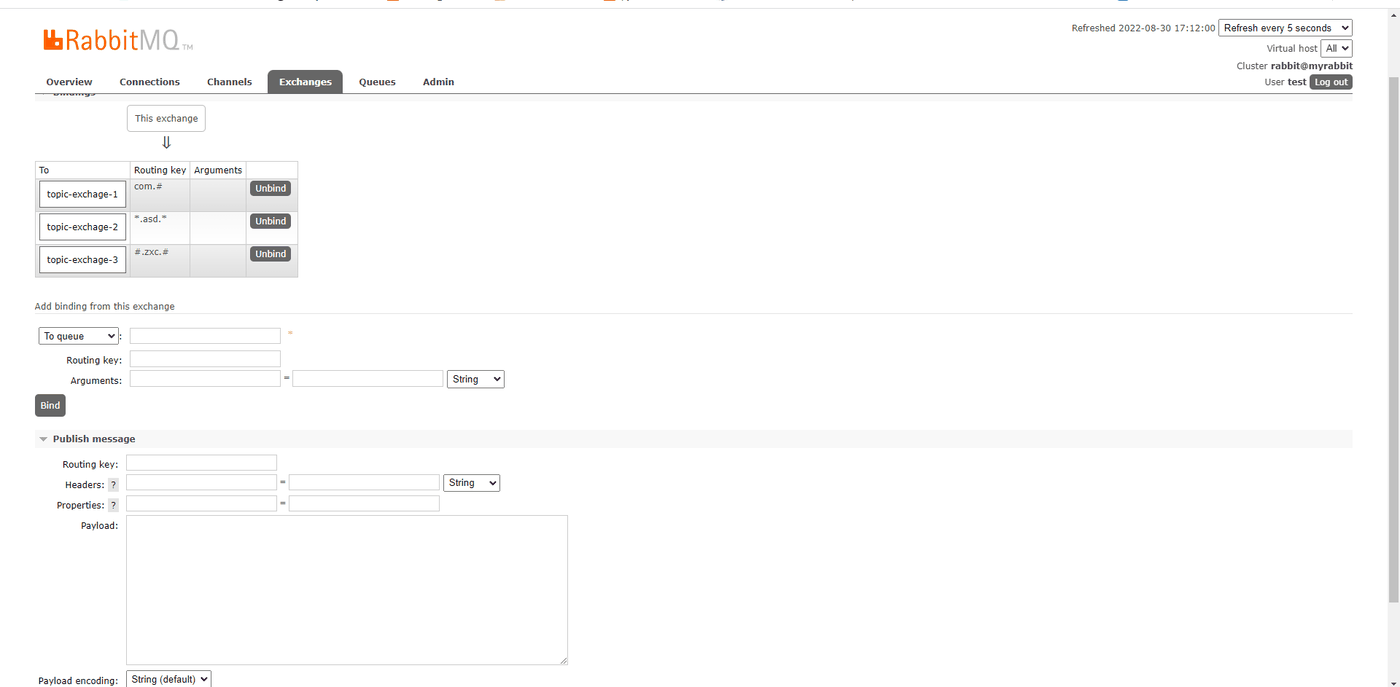
routing key 按词.词.词分段匹配,*匹配恰好一个词,#匹配零个或多个词
例:binding key 是*.asd.*,com.asd.zxc能收到,com.asd收不到
headers(头部匹配)
不看 routing key,看消息头里的键值对和绑定参数是否完全匹配
用得少,参数写起来啰嗦,一般用 topic 代替
五种类型在管理界面上配起来长得几乎一样,区别全在绑定时填的那一栏:
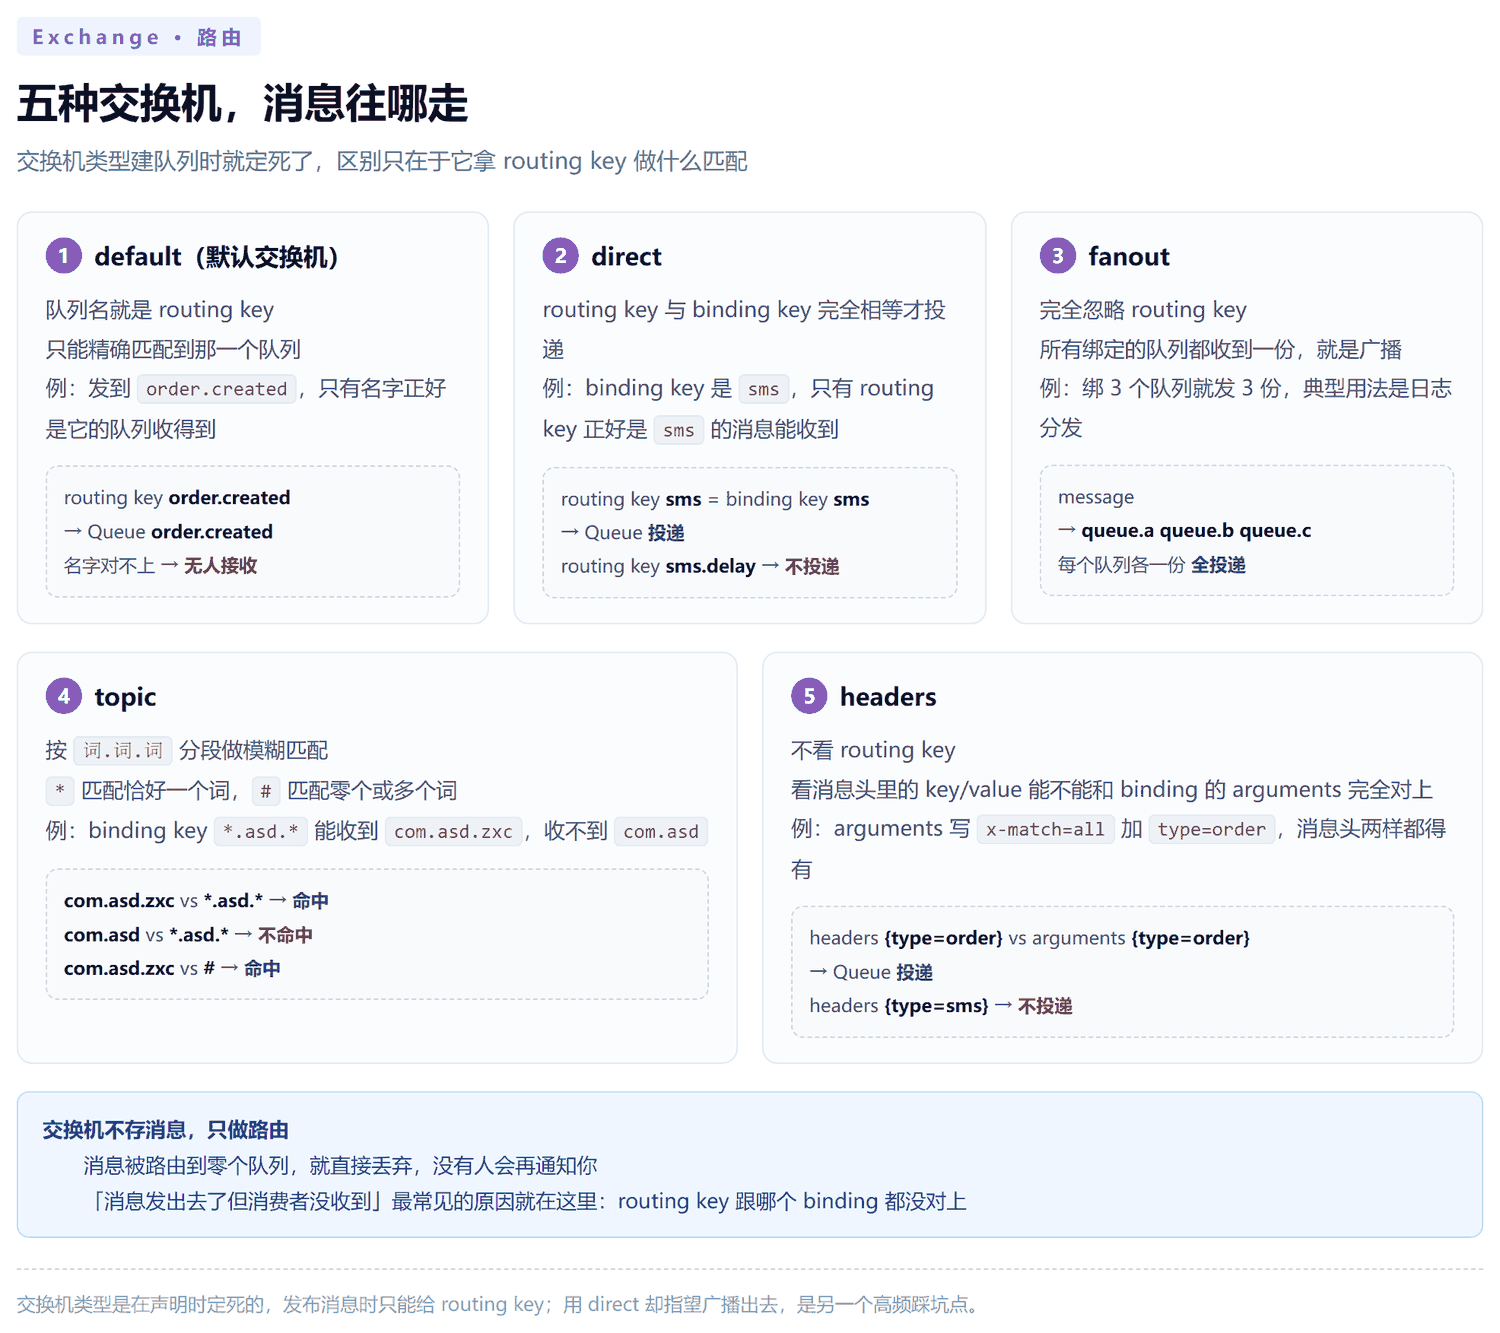
消息发出去了,消费者没收到,先查这两个地方
一是 routing key 和 binding key 写错了,direct 下差一个字符就投不出去
二是消息被路由到了零个队列,直接被丢弃,不会有任何报错
交换机不存消息这件事,是「消息莫名消失」最常见的根因
这五种类型在 Spring Boot 里怎么声明,见第 9 章。
7.2 队列:消息的落脚点
声明队列的四个参数,含义必须记准,写错一个就是线上事故:
durable(持久化)
true 表示队列本身在 Broker 重启后还在,消息也会跟着保留
注意这只管队列,消息要不要落盘还要看发布时有没有设 delivery mode
exclusive(排他)
true 表示这个队列只对声明它的这条连接可见,连接断掉队列自动删
同一连接的不同 Channel 能访问它,其他连接连名字都声明不出来
哪怕 durable 是 true,排他队列连接一断照样没
autoDelete(自动删除)
true 表示至少有一个消费者连着的情况下,等所有消费者都断开时才删
没有消费者时不会删,一直挂着
这个参数最容易被理解反:它不是「一断就删」,是「最后一个消费者走了才删」
arguments(附加参数)
常用的是x-message-ttl(消息存活时间)、x-max-length(队列长度上限)、x-dead-letter-exchange(死信交换机)这些
Java 客户端的声明签名是这四个布尔值加一个参数表:
channel.queueDeclare(
    "order.created",   // 队列名
    true,               // durable  持久化
    false,              // exclusive 排他
    false,              // autoDelete 自动删除
    null                // arguments 附加参数
);
声明参数必须前后一致
同一个队列名,两次声明的参数不一样,Broker 会直接关掉你的连接
报错是PRECONDITION_FAILED - inequivalent arg 'durable',406
典型场景:本地用durable=false测过了,上了生产改成 true,队列还在,于是直接起不来
解法
改 durable 这类参数不能靠重新声明,得先把旧队列删掉,或者换一个队列名
管理界面里那个 D 徽标就是 durable 的标记,没有 D 的队列,Broker 一重启就没
💡 模型里几个容易搞混的点
队列的 durable 和消息的持久化是两件事
队列 durable 只是说队列定义本身能活过重启,消息要不要落盘看发布时设没设 delivery mode
两个都配上才算「重启不丢」
Exchange 名字写错不会报错
往一个不存在的交换机发消息,消息直接消失,没有任何异常
所以交换机也要显式声明,别指望它自动存在
Routing Key 和 Binding Key 的关系是「匹配」不是「相等」
只有 direct 是完全相等,topic 是通配,fanout 根本不看
在代码里写死字符串很容易写错,拼成常量或者用枚举比硬编码靠谱
8. Java 客户端:收发、work 队列与常见坑
8.1 Java 客户端:两行代码收发
依赖坐标和版本:
<dependency>
    <groupId>com.rabbitmq</groupId>
    <artifactId>amqp-client</artifactId>
    <version>5.37.0</version>
</dependency>
拉不动依赖的时候改镜像的 conf/settings.xml,Maven 入门与私有仓库搭建那篇有现成配置。
连接配置建议单独封一个工具类,别在每个类里重复写:
public class MqUtil {

    public static ConnectionFactory factory() {
        ConnectionFactory f = new ConnectionFactory();
        f.setHost("mq.example.com");
        f.setPort(5672);
        f.setUsername("appuser");
        f.setPassword("your-password");
        f.setVirtualHost("/");
        // 心跳默认 60 秒,用来发现对端失联
        f.setRequestedHeartbeat(60);
        // 断线自动重连,并且把断线前声明过的队列/交换机恢复回来
        f.setAutomaticRecoveryEnabled(true);
        f.setTopologyRecoveryEnabled(true);
        return f;
    }
}
Uri 写法更省事
f.setUri("amqp://appuser:your-password@mq.example.com:5672/%2f")
注意 vhost 是/的时候在 URI 里要写成%2f,直接写/会被当成路径分隔符
自动重连不是免费的
连上之后调用newConnection()只会重连网络,不会重新声明队列和交换机
拓扑恢复开着才会重放声明动作,代价是 broker 侧多做一些事
用户名密码别硬编码
生产环境从配置中心或环境变量读,代码里出现明文口令是要出事的
生产者:
ConnectionFactory f = MqUtil.factory();
try (Connection conn = f.newConnection("producer");
     Channel ch = conn.createChannel()) {

    // 声明队列:名字、durable、exclusive、autoDelete、arguments
    ch.queueDeclare("order.created", true, false, false, null);

    // 发送到默认交换机,routing key 就是队列名
    ch.basicPublish("", "order.created", null, "order-1001".getBytes("UTF-8"));

    System.out.println("sent");
}
消费者:
try (Connection conn = f.newConnection("consumer");
     Channel ch = conn.createChannel()) {

    // 手动 ACK:处理成功才 basicAck
    ch.basicConsume("order.created", false, new DeliverCallback() {
        @Override
        public void handle(String consumerTag, Delivery delivery) throws IOException {
            try {
                String body = new String(delivery.getBody(), "UTF-8");
                handleOrder(body);
                ch.basicAck(delivery.getEnvelope().getDeliveryTag(), false);
            } catch (Exception e) {
                // 处理失败不 ACK,消息重回队列
                // 这里要加上重试次数控制,否则会无限重投
                log.error("consume failed: " + body, e);
            }
        }
    }, new CancelCallback() {
        @Override
        public void handle(String consumerTag) {
            log.warn("consumer cancelled: " + consumerTag);
        }
    });

    // 消费者线程要活着,否则主线程结束整个进程就退了
    System.in.read();
}
为什么用 try-with-resources
Connection 和 Channel 都是要显式关的,不关的话连接数会一直涨,直到撞上上限
消费者进程要「不退出」
System.in.read()或者挂个非守护线程都行,否则 main 一结束消费者就没了
自动 ACK 和手动 ACK 差着一层数据丢失
自动 ACK 是消息一推给客户端就算确认,客户端还没处理完就崩了,消息已经没了
手动 ACK 是处理完再确认,中间崩了消息重回队列,代价是可能重复处理
用 Spring Boot 的话连接配置和收发都能省掉手写代码,见第 9 章。
8.2 work 队列:轮询和公平分发
一个队列挂多个消费者,消息怎么分?两种模式,差别在 ACK 的用法。
轮询分发(自动 ACK)
basicConsume(queue, true, ...)
Broker 轮流往各个消费者推,数量上是公平的
但消费者快慢不影响分配,一个慢消费者会拖住后面的投递节奏
公平分发(手动 ACK + prefetch)
basicQos(1)加basicConsume(queue, false, ...),处理完basicAck
prefetch 是「未确认消息的上限」,设为 1 就是手里有活的时候不再给新的
快的消费者拿得多,慢的拿得少,负载自然往能扛的一边走
Channel finalCh = ch;
finalCh.basicQos(1);   // 每个消费者最多持有 1 条未确认消息
finalCh.basicConsume("work.queue", false, new DeliverCallback() {
    @Override
    public void handle(String tag, Delivery delivery) throws IOException {
        try {
            System.out.println(Thread.currentThread().getName()
                    + " 收到: " + new String(delivery.getBody(), "UTF-8"));
            Thread.sleep(2000);
            finalCh.basicAck(delivery.getEnvelope().getDeliveryTag(), false);
        } catch (Exception e) {
            e.printStackTrace();
        }
    }
}, new CancelCallback() {
    @Override
    public void handle(String tag) { }
});
prefetch 的默认值是 0,也就是不限制
不设basicQos的话,Broker 会把队列里的消息一次性全推给第一个连上来的消费者
想验证这一点很容易:起一个消费者盯着队列,消息瞬间就全没了,第二个消费者再连上什么都拿不到
prefetch 调大能提高吞吐
但会削弱公平性,也会让单条消息处理失败时积压更多未确认消息
消费者是 IO 密集型可以适当调大,CPU 密集型一般保持 1 或个位数
prefetch 是按消费者算的
官方定义是 per-consumer,0 表示不限制
同一条 Channel 上开多个消费者,每个消费者各自有独立的上限
所以「一个 Channel 里塞十个消费者各 prefetch 1」和「十个 Channel 各 prefetch 1」效果一样
8.3 几个绕不开的坑
用管理界面的 Get message 调试会把消息取走
那个按钮是「取出来看一眼」,取完消息就不在队列里了
要测试消费效果,用 Publish message 往队列里发,别用 Get message
消息发出去了但队列没变化
先看 routing key 和 binding key 对不对,再看消息是不是被路由到了零个队列
连接被莫名关掉
九成是声明参数不一致(406),剩下的是权限不足(403)
消费者不重连
newConnection()只在调用那一刻建立连接,之后 Broker 重启不会自动恢复
要自动恢复就开automaticRecoveryEnabled,并且把消费逻辑写成可重复执行的
消息重复
手动 ACK + 处理耗时,中途崩溃就会重投,这是 at-least-once 的正常现象
消费逻辑必须幂等,幂等怎么做见第 9 章
4.3 起 classic 队列 v1 没了
声明时带x-queue-mode或x-queue-version=1会直接失败
4.2 起默认就是 classic queue v2,4.3 干脆把 v1 删干净了
4.3 起 transient 队列默认禁止
既不 durable 又不 exclusive 的队列会被拒,需要时显式打开deprecated_features.permit.transient_nonexcl_queues
副本位置参数改名了
x-queue-master-locator在 4.x 换成了x-queue-leader-locator,policy 里的键叫queue_leader_locator,取值client-local(默认)或balanced
9. Spring Boot 整合:声明、TTL 与死信队列
9.1 依赖与配置
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-amqp</artifactId>
</dependency>
配置文件:
server.port=8080

spring.rabbitmq.host=mq.example.com
spring.rabbitmq.port=5672
spring.rabbitmq.username=appuser
spring.rabbitmq.password=${RABBITMQ_PASSWORD}
spring.rabbitmq.virtual-host=/

# 消费端
spring.rabbitmq.listener.simple.acknowledge-mode=manual
spring.rabbitmq.listener.simple.prefetch=1
spring.rabbitmq.listener.simple.concurrency=2
spring.rabbitmq.listener.simple.max-concurrency=8

# 发布端:开启发布确认,Broker 收到才算是发成功
spring.rabbitmq.publisher-confirm-type=correlated
host 后面不要带协议头
写成http://mq.example.com会直接连不上,Spring Boot 拼的是amqp://
这个字段只填主机名,端口单独用port指定
要连多台就换 addresses
spring.rabbitmq.addresses=amqp://admin:secret@mq1:5672,amqp://mq2:5672/%2f
设了addresses就会忽略host和port,协议头写amqps://会自动启用 SSL
密码别写死在配置文件里
用${环境变量}占位,开发和生产给不同的值
publisher-confirm-type 别忘了开
默认是none,也就是不确认,convertAndSend返回成功只代表消息进了本地缓冲区
设成correlated之后可以等 Broker 的确认,不然「发成功」这个判断是假的
acknowledge-mode 三档
auto(默认,容器自动 ACK)、manual(手动 ACK)、none(不 ACK)
要自己控制重试就必须用manual,自动 ACK 下处理失败消息已经没了
concurrency 和 max-concurrency
前者是启动时开几个消费者,后者是忙的时候最多扩到几个
队列空了会自动缩回concurrency
prefetch 是每个消费者持有多少条未确认消息
保持 1 是最稳的起点,吞吐不够再往上调
底层的 Java 客户端写法见第 8 章。
9.2 启动时声明了什么
Spring Boot 启动时会读配置类里的 Bean,把 Exchange、Queue、Binding 都声明到 Broker 上。这三样东西的生命周期是「应用启动时创建」,所以叫声明式——声明一次,跑着的所有实例都按这一份来。
@Configuration
public class RabbitMqConfig {

    @Bean
    public FanoutExchange orderEventExchange() {
        // 名字、是否持久化、是否自动删除
        return new FanoutExchange("order.event.exchange", true, false);
    }

    @Bean
    public Queue smsQueue() {
        return new Queue("order.sms.queue", true);
    }

    @Bean
    public Queue emailQueue() {
        return new Queue("order.email.queue", true);
    }

    @Bean
    public Binding smsBinding() {
        return BindingBuilder.bind(smsQueue()).to(orderEventExchange());
    }

    @Bean
    public Binding emailBinding() {
        return BindingBuilder.bind(emailQueue()).to(orderEventExchange());
    }
}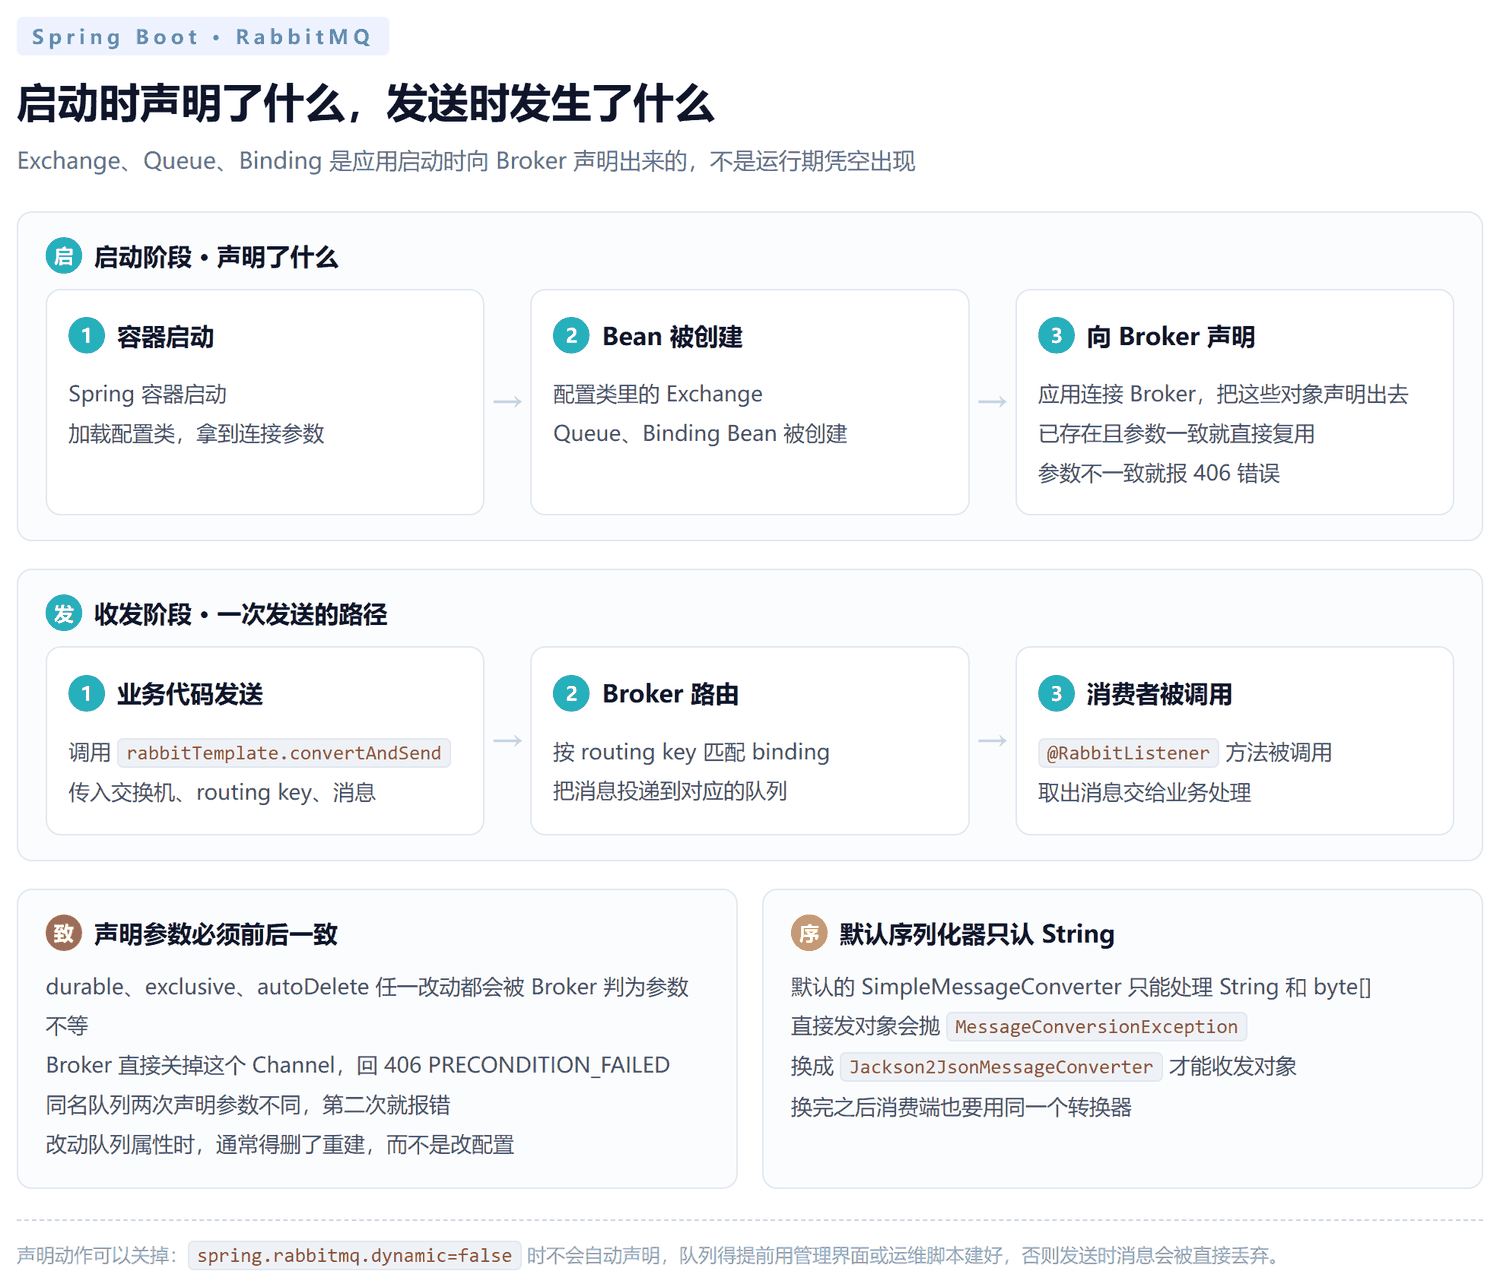
声明的参数必须和 Broker 上已有的一致
不一致会抛PRECONDITION_FAILED,连接被关闭,应用直接起不来
报错信息里会写明是哪个参数冲突,比如inequivalent arg 'durable'
改 durable 改不了,得先删队列
本地durable=false测完,线上改成true,老队列还在,于是起不来
用管理界面删掉旧队列,或者干脆换队列名
Bean 方法名只是 Bean 名
但代码里用@Qualifier引用时,名字要一致
一个项目里定义好几个 Exchange 时,名字写混了排查起来很痛苦
命名建议带上业务前缀
order.sms.queue比smsQueue好,Broker 上几十个队列时一眼能分清是谁的
9.3 发送消息
@Service
public class OrderService {

    @Autowired
    private RabbitTemplate rabbitTemplate;

    public void onOrderCreated(String orderNo) {
        // 交换机名、routing key、消息体
        rabbitTemplate.convertAndSend(
                "order.event.exchange",
                "",
                "订单已创建: " + orderNo);
    }
}
fanout 模式的 routing key 随便写
因为 fanout 根本不看 routing key,填空字符串就行
direct 模式 routing key 必须填对
填错了,消息被路由到零个队列,静默消失,不报错
这个静默失败是排查 MQ 问题最费时间的一类
发出去的字符串是纯文本
默认序列化器SimpleMessageConverter只认 String
传别的类型会直接抛MessageConversionException,消息根本发不出去
Spring AMQP 4.1 换了类名
官方文档现在主推AmqpTemplate和AmqpAdmin,包路径是org.springframework.boot.amqp.autoconfigure
RabbitTemplate还在,还能用,但新代码照官方文档写更稳妥
9.4 消费消息
两种写法,效果一样。
写法一,队列在配置类里声明,注解只写队列名:
@Component
public class SmsReceiver {

    @RabbitListener(queues = "order.sms.queue")
    public void handle(String message) {
        System.out.println("sms 消费者收到: " + message);
    }
}
写法二,队列、交换机、绑定全写在注解上,适合小项目:
@Component
public class TopicReceiver {

    @RabbitListener(bindings = @QueueBinding(
            value = @Queue(value = "order.topic.queue", durable = "false", autoDelete = "true"),
            exchange = @Exchange(value = "order.topic.exchange", type = ExchangeTypes.TOPIC),
            key = "order.#"))
    public void handle(String message) {
        System.out.println("topic 消费者收到: " + message);
    }
}
两种写法别混着来
一个队列如果在配置类里声明了,注解里就只写名字
两边都写、参数还不一样,启动就报 406
监听队列名写错不会启动失败
Spring Boot 不会去检查队列存不存在,注解上的名字写错了,消费者就是一直连着但收不到消息
控制台里能看到消费者在线,队列里也有消息,就是不动,这种现象最容易被误判成「Broker 有问题」
手动 ACK 要拿到 Channel
方法参数里加上Channel或Delivery,才能在处理成功后确认消息
@RabbitListener(queues = "order.sms.queue")
public void handle(String message, Channel channel, Delivery delivery) throws IOException {
    try {
        smsService.send(message);
        // 只确认这一条
        channel.basicAck(delivery.getEnvelope().getDeliveryTag(), false);
    } catch (Exception e) {
        log.error("短信发送失败: " + message, e);
        // 不确认,消息重回队列
        // 不带 requeue 参数会按容器配置决定是否重回队列
        channel.basicNack(delivery.getEnvelope().getDeliveryTag(), false, true);
    }
}
9.5 序列化:默认只认 String
这是接 RabbitMQ 最常撞的一个坑:
OrderDTO order = new OrderDTO("1001", "张三");
rabbitTemplate.convertAndSend("order.event.exchange", "", order);
// 抛 org.springframework.amqp.AmqpMessageConversionException
// Caused by: ClassCastException: ... cannot be cast to java.lang.String
原因是默认的 SimpleMessageConverter 只支持 String、byte[] 和序列化对象,POJO 直接塞进去会失败。换成 JSON 序列化器:
@Bean
public MessageConverter messageConverter() {
    return new Jackson2JsonMessageConverter();
}
消费端也要匹配
发送端用 JSON,消费端就得能反序列化成同一个类,否则报MessageConversionException
换序列化器是全局生效的
一旦改成 JSON,队列里存着的旧消息用新消费者就解析不了
生产环境切换序列化器前,先把队列清空,或者给新老格式用不同的队列
多态类型要加类型头
发送基类引用、实际是子类时,加上__TypeId__头,Jackson 才能还原成正确的类型
9.6 TTL:两种过期时间
RabbitMQ 有两个地方能设过期时间,行为不一样,这是最容易记混的地方。
队列 TTL——给整个队列设有效期:
@Bean
public Queue ttlSmsQueue() {
    Map<String, Object> args = new HashMap<>();
    args.put("x-message-ttl", 60000);   // 队列里每条消息最多活 60 秒
    return new Queue("order.sms.ttl.queue", true, false, false, args);
}
消息 TTL——给单条消息设有效期:
rabbitTemplate.convertAndSend("order.event.exchange", "", "消息体", msg -> {
    msg.getMessageProperties().setExpiration("5000");
    return msg;
});
两者的关键差别
队列 TTL 过期后,消息会进死信队列
消息自身 TTL 过期后,消息直接丢弃,不进死信队列
同样叫「过期」,两个出口不一样,排查时别搞混
队列 TTL 不是「队列在 60 秒后消失」
是「队列里的消息最多存活 60 秒」,队列本身一直都在
classic 队列的过期消息不一定马上死信
消息只有排到队首时才会被判定过期并处理
队头被一条长消息卡住,后面已经过期的消息会一直躺在队列里
quorum queue 没有这个问题,过期消息会尽快被清理
9.7 死信队列与延迟队列
死信队列是「接盘机制」:消息被拒绝、过期、超出队列长度上限时,会被转发到死信交换机,再由死信交换机投递到死信队列。
@Bean
public DirectExchange deadLetterExchange() {
    return new DirectExchange("order.dlx.exchange", true, false);
}

@Bean
public Queue deadLetterQueue() {
    return new Queue("order.dlx.queue", true);
}

@Bean
public Binding deadLetterBinding() {
    return BindingBuilder.bind(deadLetterQueue()).to(deadLetterExchange());
}

@Bean
public Queue orderQueue() {
    Map<String, Object> args = new HashMap<>();
    args.put("x-dead-letter-exchange", "order.dlx.exchange");
    args.put("x-dead-letter-routing-key", "order.dlx");
    return new Queue("order.queue", true, false, false, args);
}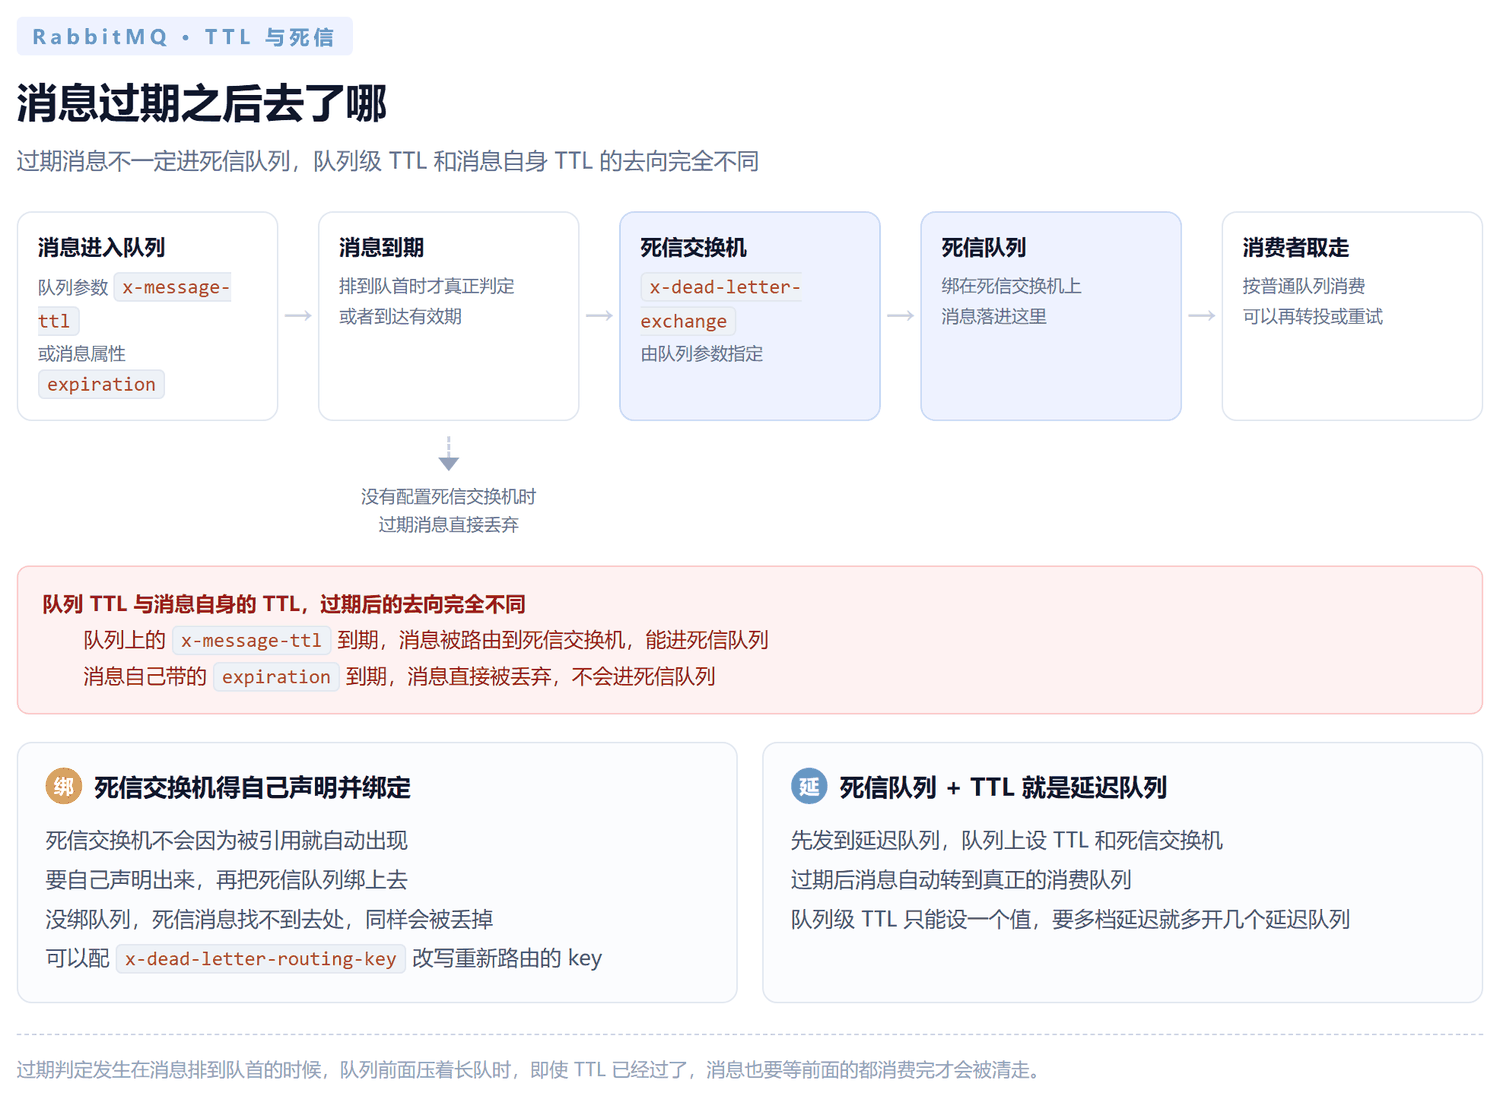
死信交换机必须自己声明并绑定
不声明的话死信消息无处可去,会被直接丢掉
这是「配了死信却什么都没发生」的唯一原因
死信交换机的类型决定了要不要 routing key
fanout 不看 routing key,direct 必须对上,填错一样丢
延迟队列的原理就是这个
消息先进延迟队列(设x-message-ttl和死信交换机)
过期后被转发到真正的消费队列,消费者从消费队列取
用「多级延迟队列」可以做出不同延迟档位
延迟队列的坑是顺序
同一个延迟队列里的消息过期时间一样就没问题
混着不同的过期时间,classic 队列要等队头那条先走,后面的会跟着晚走
9.8 幂等、重试和并发
手动 ACK 意味着「处理成功才确认」,处理到一半崩溃,消息会重回队列被重投。重复消费是必然结果,不是故障。
幂等怎么做
消费端用业务唯一键(订单号 + 消息 ID)做一张去重表,或者用 Redis 的 SETNX 配合过期时间
去重记录要在业务处理成功之后写,和业务更新放同一个事务里
别用 MQ 指望 exactly-once
跨系统的 exactly-once 是靠幂等键和去重表做出来的,不是靠协议保证的
重试次数要有上限
无脑 requeue 会让一条毒消息在队列里无限循环,把消费者 CPU 吃光
用basicNack加requeue=false丢进死信队列,或者用spring.rabbitmq.listener.simple.retry配重试次数
并发消费要能扛住重复
max-concurrency开大了,同一条消息被两个线程同时处理的概率就高了,去重表必须加唯一索引
最终一致性场景里的幂等,见第 10 章。
9.9 几个绕不开的坑
消息发出去没人收,先看 routing key
direct 模式下 routing key 和 binding key 不一致,消息被丢弃,不抛异常
往没声明的交换机发消息,消息直接消失
交换机不存在不会报错,消息路由不到任何队列就没了
所以每个用到的交换机都要显式声明
队列名和监听队列名不一致
消费者在线但收不到消息,八成是两边名字不一样
消费端不消费也不报错
消息 TTL 过期、队列满了、消息被路由到零个队列——这三种情况消费端都是安静的
Spring Boot 2.7 和 3.5 都已经停止社区维护
3.5.x 的开源支持在 2026 年 6 月 30 日结束,当前主版本是 4.1.x
照着 2.x、3.x 的教程写容易踩空,配置项名和依赖管理都有变化
💡 用起来之后几个容易想歪的地方
声明式配置不是「幂等声明」而是「要求一致」
同样的参数重复声明是安全的,参数变了就是冲突
所以改队列属性不是改配置就行的,得先处理掉旧队列
autoDelete 在配置类里容易被忽略
new Queue(name, durable)这个构造器只设了 durable,autoDelete 默认 false
要设更多参数就用全参构造器,别用简写
消息 TTL 是相对时间
消息在队列里待了 3 秒才被消费,而 TTL 是 5 秒,那这条消息是能正常消费的
TTL 算的是在队列里待了多久,不是从发布到消费的总时长
10. 消息队列与分布式事务
10.1 本地事务管不到的地方
一个服务一个库的时候,事务注解包住几个写操作,要么全成要么全败,代码里看不出来的不一致不会出现。
拆成两个服务两个库之后,这层保护就失效了:
服务 1 下单
写订单库、扣库存、发消息给服务 2,这几步在服务 1 的一个本地事务里
服务 2 履约
收到消息后写履约库,这是服务 2 自己的本地事务
出问题的地方在中间
服务 1 提交了本地事务,消息也发出去了,服务 2 也处理完了
但服务 1 之后因为别的原因回滚了,或者服务 2 处理到一半挂了
结果是:服务 1 没这笔单,服务 2 却已经履约了
本质上是:两个本地事务之间没有共同的提交点。数据库的 XA / 两阶段提交能造出一个共同提交点,但它要求所有参与方都支持,而且会把资源锁住到提交完成——性能代价和故障面都很大,互联网业务里很少用。
10.2 三种常见思路
TCC(Try-Confirm-Cancel)
每个服务都得提供三个接口:预留资源、确认提交、取消回滚
优点是性能好、隔离性可控
代价是每个参与方都要改造,而且要处理空回滚、幂等、悬挂三种异常
本地消息表
消息的发送和业务数据变更放在同一个本地事务里,靠定时任务把没发出去的消息补发
改造成本集中在一边,适合「交易链路」这种场景
2PC / XA
由事务协调者统一指挥各参与方提交或回滚
强一致,但参与方全部要支持、事务期间锁资源、Coordinator 挂了会卡住
选哪种,看的是业务能不能接受不一致,以及要改造几边。业务能接受「几秒内对齐」,本地消息表这种异步方案代价最小。
10.3 本地消息表:把发消息变成写表
核心思路只有一句:不要在事务提交之后才发消息,而是先把「要发的消息」写进本地数据库的一张表,和业务数据一起提交。
于是「发消息」这个不可控的外部动作,变成了「往表里写一行」这个可控的本地事务动作。消息真正的发送,交给另一个角色去做:
业务线程
只做本地事务:改余额 + 插一条待发消息记录,一起提交
不碰 MQ,事务提交完就结束,耗时可控
发送线程(定时任务)
扫消息表,把没发出去或者发出去了但没收到回执的记录,发到 MQ
发成功的标记状态
消费方
收到消息做业务处理,并且必须幂等
处理完回一条确认消息给业务方
这么设计的好处是:业务代码里再也没有「发消息」这个会失败的外部调用。发消息失败了不影响业务数据,消息表里那行还在,定时任务下次接着发。
10.4 走一遍转账
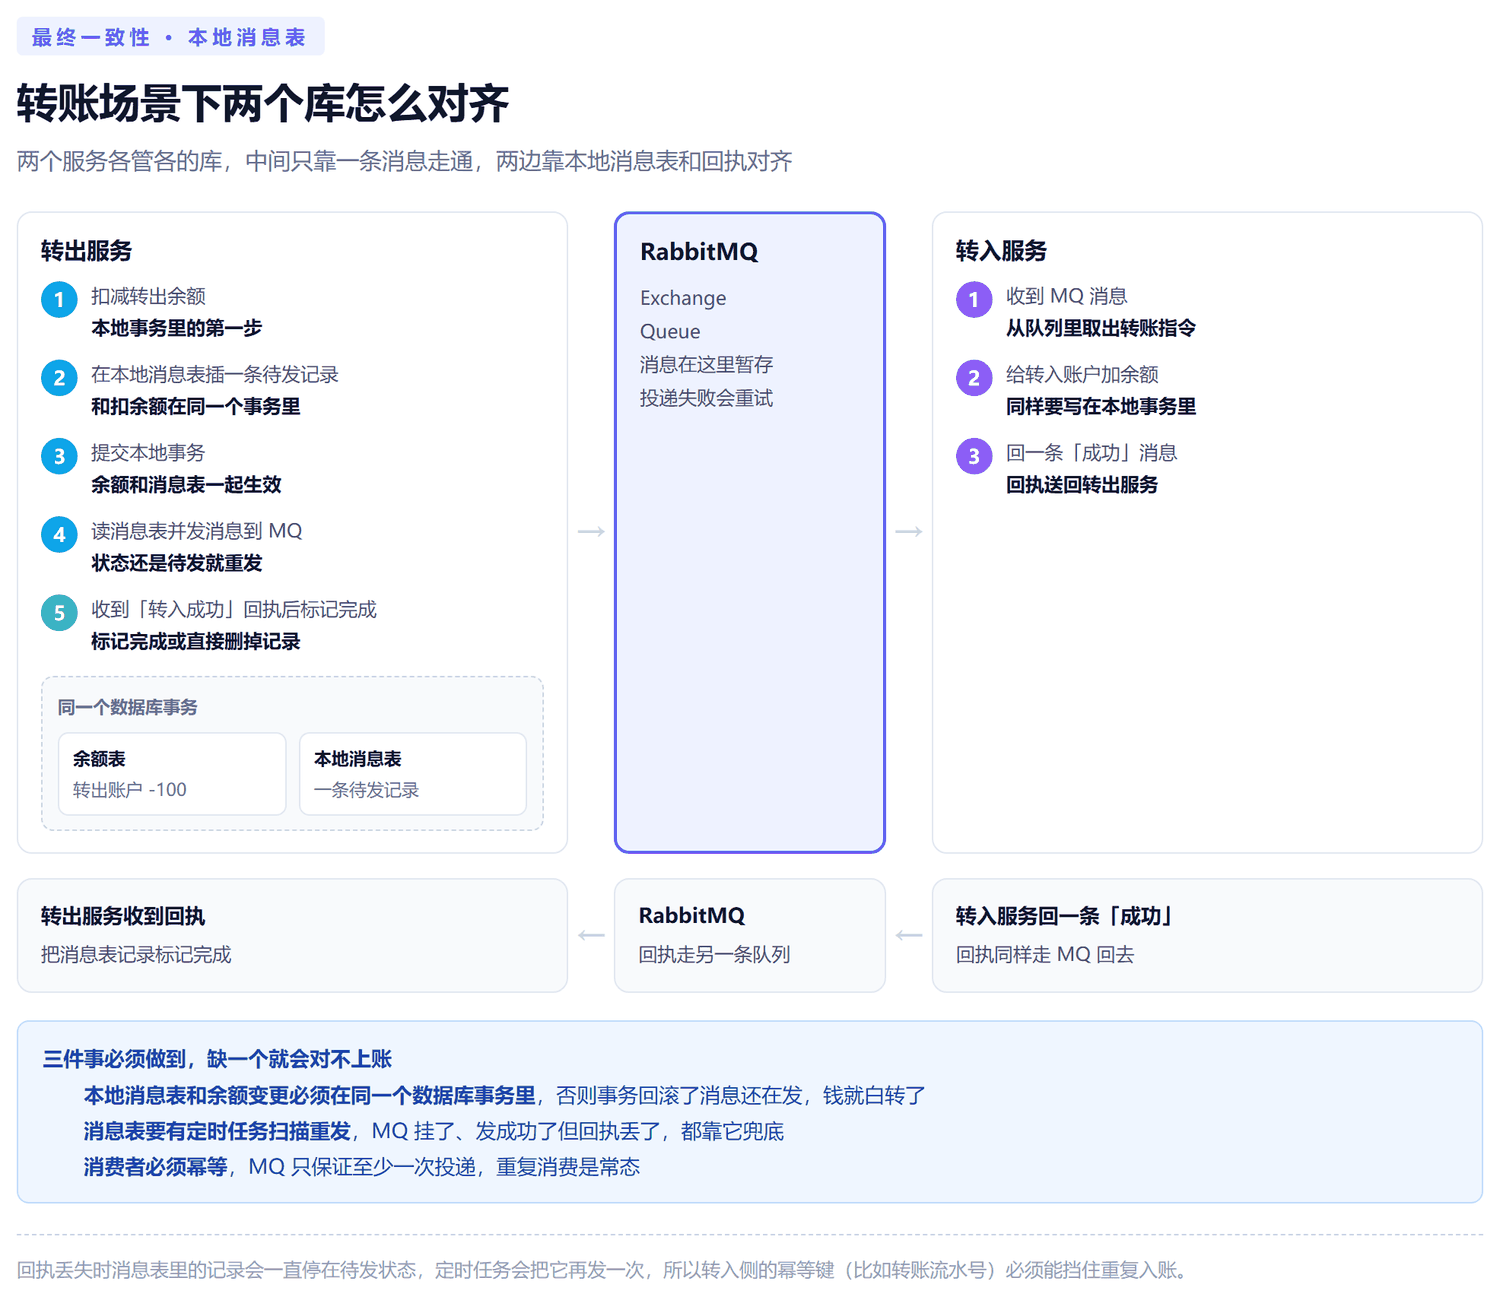
转出 A 给转入 B 转 100 元:
1. 转出服务开本地事务
扣 A 的余额 100
2. 同一个事务里插一条待发消息
消息表记下:给 B 加 100,状态「待发送」
3. 提交本地事务
余额变了,消息表也写了一行,这两件事要么都成要么都败
4. 发送线程扫消息表
把「待发送」的记录发到 MQ
5. 转入服务收到消息
给 B 加 100,成功后回一条「加余额成功」的消息
6. 转出服务收到回执
把消息表那行标记成已完成,或者删掉
第 2 步和第 1 步必须在同一个事务里
分开写就等于回到原点:余额扣了但消息没记下来,钱就凭空少了
这是整个方案成立的唯一前提
第 6 步不是必需的
没有回执,消息表里的记录会一直停在「已发送」,定时任务可以按超时重新发
但这依赖消费方幂等,否则会重复加钱
消息表要能查到
生产环境排障时,「这笔转账的消息到底发出去了没有」必须能查出来
表里至少要有业务唯一键、状态、创建时间、重试次数、最后错误信息
10.5 补偿任务怎么设计
定时任务是这个方案的可靠性所在,它的逻辑不复杂但边界很多:
扫什么
状态是「待发送」,或者「已发送但没收到回执」且超过一定时间的记录
发什么
消息体从消息表里读出来原样重发,不要重新拼
重新拼的话,补偿发出去的内容可能和第一次不一样
怎么标记
发出去了就把状态改成「已发送」,记下发送时间
收到回执改成「已完成」
重试几次
必须有上限,比如 5 次
超过上限不动,转人工:落一条告警,或者进一个待处理表让人看
无限重试会把一条坏数据变成永动机
并发问题
多个实例同时跑定时任务,会重复发同一条消息
解法是给这行记录加个状态流转条件,比如只有「待发送」才能改成「发送中」
用数据库的行锁或者乐观锁的版本号来做这个条件更新
消息体要够
重发时要用完整的信息重建业务动作,金额、账户、业务单号一个都不能少
只发一个账户 ID 是不够的,补偿的时候没有上下文可用
扫表要分片
消息表数据量会一直涨,按状态加索引,只扫待处理的那部分
历史记录定期归档或者清掉
10.6 消费端必须幂等
整个方案成立的前提,是消费方能安全地处理重复消息。消息表保证了「至少发一次」,重复是必然的。
为什么必然重复
发送线程发出消息、还没来得及更新状态就崩了,重启后这条记录还是「待发送」,会再发一次
回执消息丢了也一样,业务方不知道对方到底处理没处理,只能重发
怎么做到幂等
消费端用业务唯一键做去重:转账场景就用「转账单号」
去重记录和业务更新在同一个事务里落库
或者用数据库唯一索引兜底,重复插入直接报错
先判断再处理,还是先处理再判断
先在事务里插去重记录、插成功才处理业务,重复消息直接跳过
这个顺序反过来就会留下「业务做了但没记上」的漏洞
Spring Boot 侧的幂等实现见第 9 章。
10.7 什么时候用不上这一套
两个库在同一个数据库实例里
一个本地事务就解决了,别绕一圈
调用链就两步,频率很低
比如后台人工审批的转账,一天几十次,异步方案的复杂度完全不值当
必须强一致且没有补偿余地
资金准确性要求极高的场景,异步方案的风险要靠对账兜,兜不住就是资损
有成熟的分布式事务框架
Seata 之类的框架已经把 TCC、AT 模式做进去了,接入成本比自己搭一套低
但它们的代价是业务代码里要显式处理空回滚、悬挂、幂等,这个躲不掉
💡 最终一致性上几个容易想歪的地方
消息队列本身不提供分布式事务
MQ 保证的是消息不丢、不乱序(同一队列同一 channel),不是「两个库一起提交」
有人以为「用了 MQ 就是分布式事务了」,这是最常见的误解
Broker 的事务通道不等于分布式事务
AMQP 的事务通道能保证「这批消息被 Broker 原子地接收」,管不了你本地数据库的提交
本地库和 MQ 还是两个独立的提交点
而且官方不推荐用事务通道
RabbitMQ 官方推荐的是 publisher confirms + 消费者手动 ACK
txSelect/txCommit的吞吐比 confirm 模式低大约 250 倍,而且一条 Channel 不能同时是事务通道和 confirm 模式
要确认就用 confirm,别为了「看起来更原子」去开事务通道
本地消息表本质上是一个 transactional outbox
这个模式后来被提炼成了通用模式,名字就是 outbox,业界很多 CDC 工具和事件驱动框架都基于它
它保证的是「最终」一致
从转账到 B 账上钱,中间可能有几百毫秒到几秒的不一致窗口
对账、对不上的补账流程是必须配套的,不是可选项
🔥 一句话总结:消息队列用「先收下、慢慢做」换掉「必须同时成功」,削峰、异步、解耦三件事都建立在这个交换上,代价是数据变成最终一致、失败要自己兜、排查链路变长;它底下不用 HTTP 不是因为 HTTP 短连接会丢数据,而是 HTTP 不管投递确认、路由和背压。落到 RabbitMQ 上,当前唯一还有社区支持的是 4.3.x,发行版自带的 apt 源只给 3.x,Erlang 要 27 以上;模型的核心是「Connection 上开 Channel,消息先过 Exchange 再落 Queue」,五种交换机只有一条规则不同——匹配方式不同,direct 完全相等、fanout 全投、topic 用星号井号分段匹配;消费端记住两条,手动 ACK 和 prefetch 一起上,幂等处理必须有;最后那条最难:消息队列给的是最终一致而不是强一致,本地消息表能把「发消息」降级成「往本地表写一行」,但三个前提一个都不能少。