
2
0
0
KNN算法概括
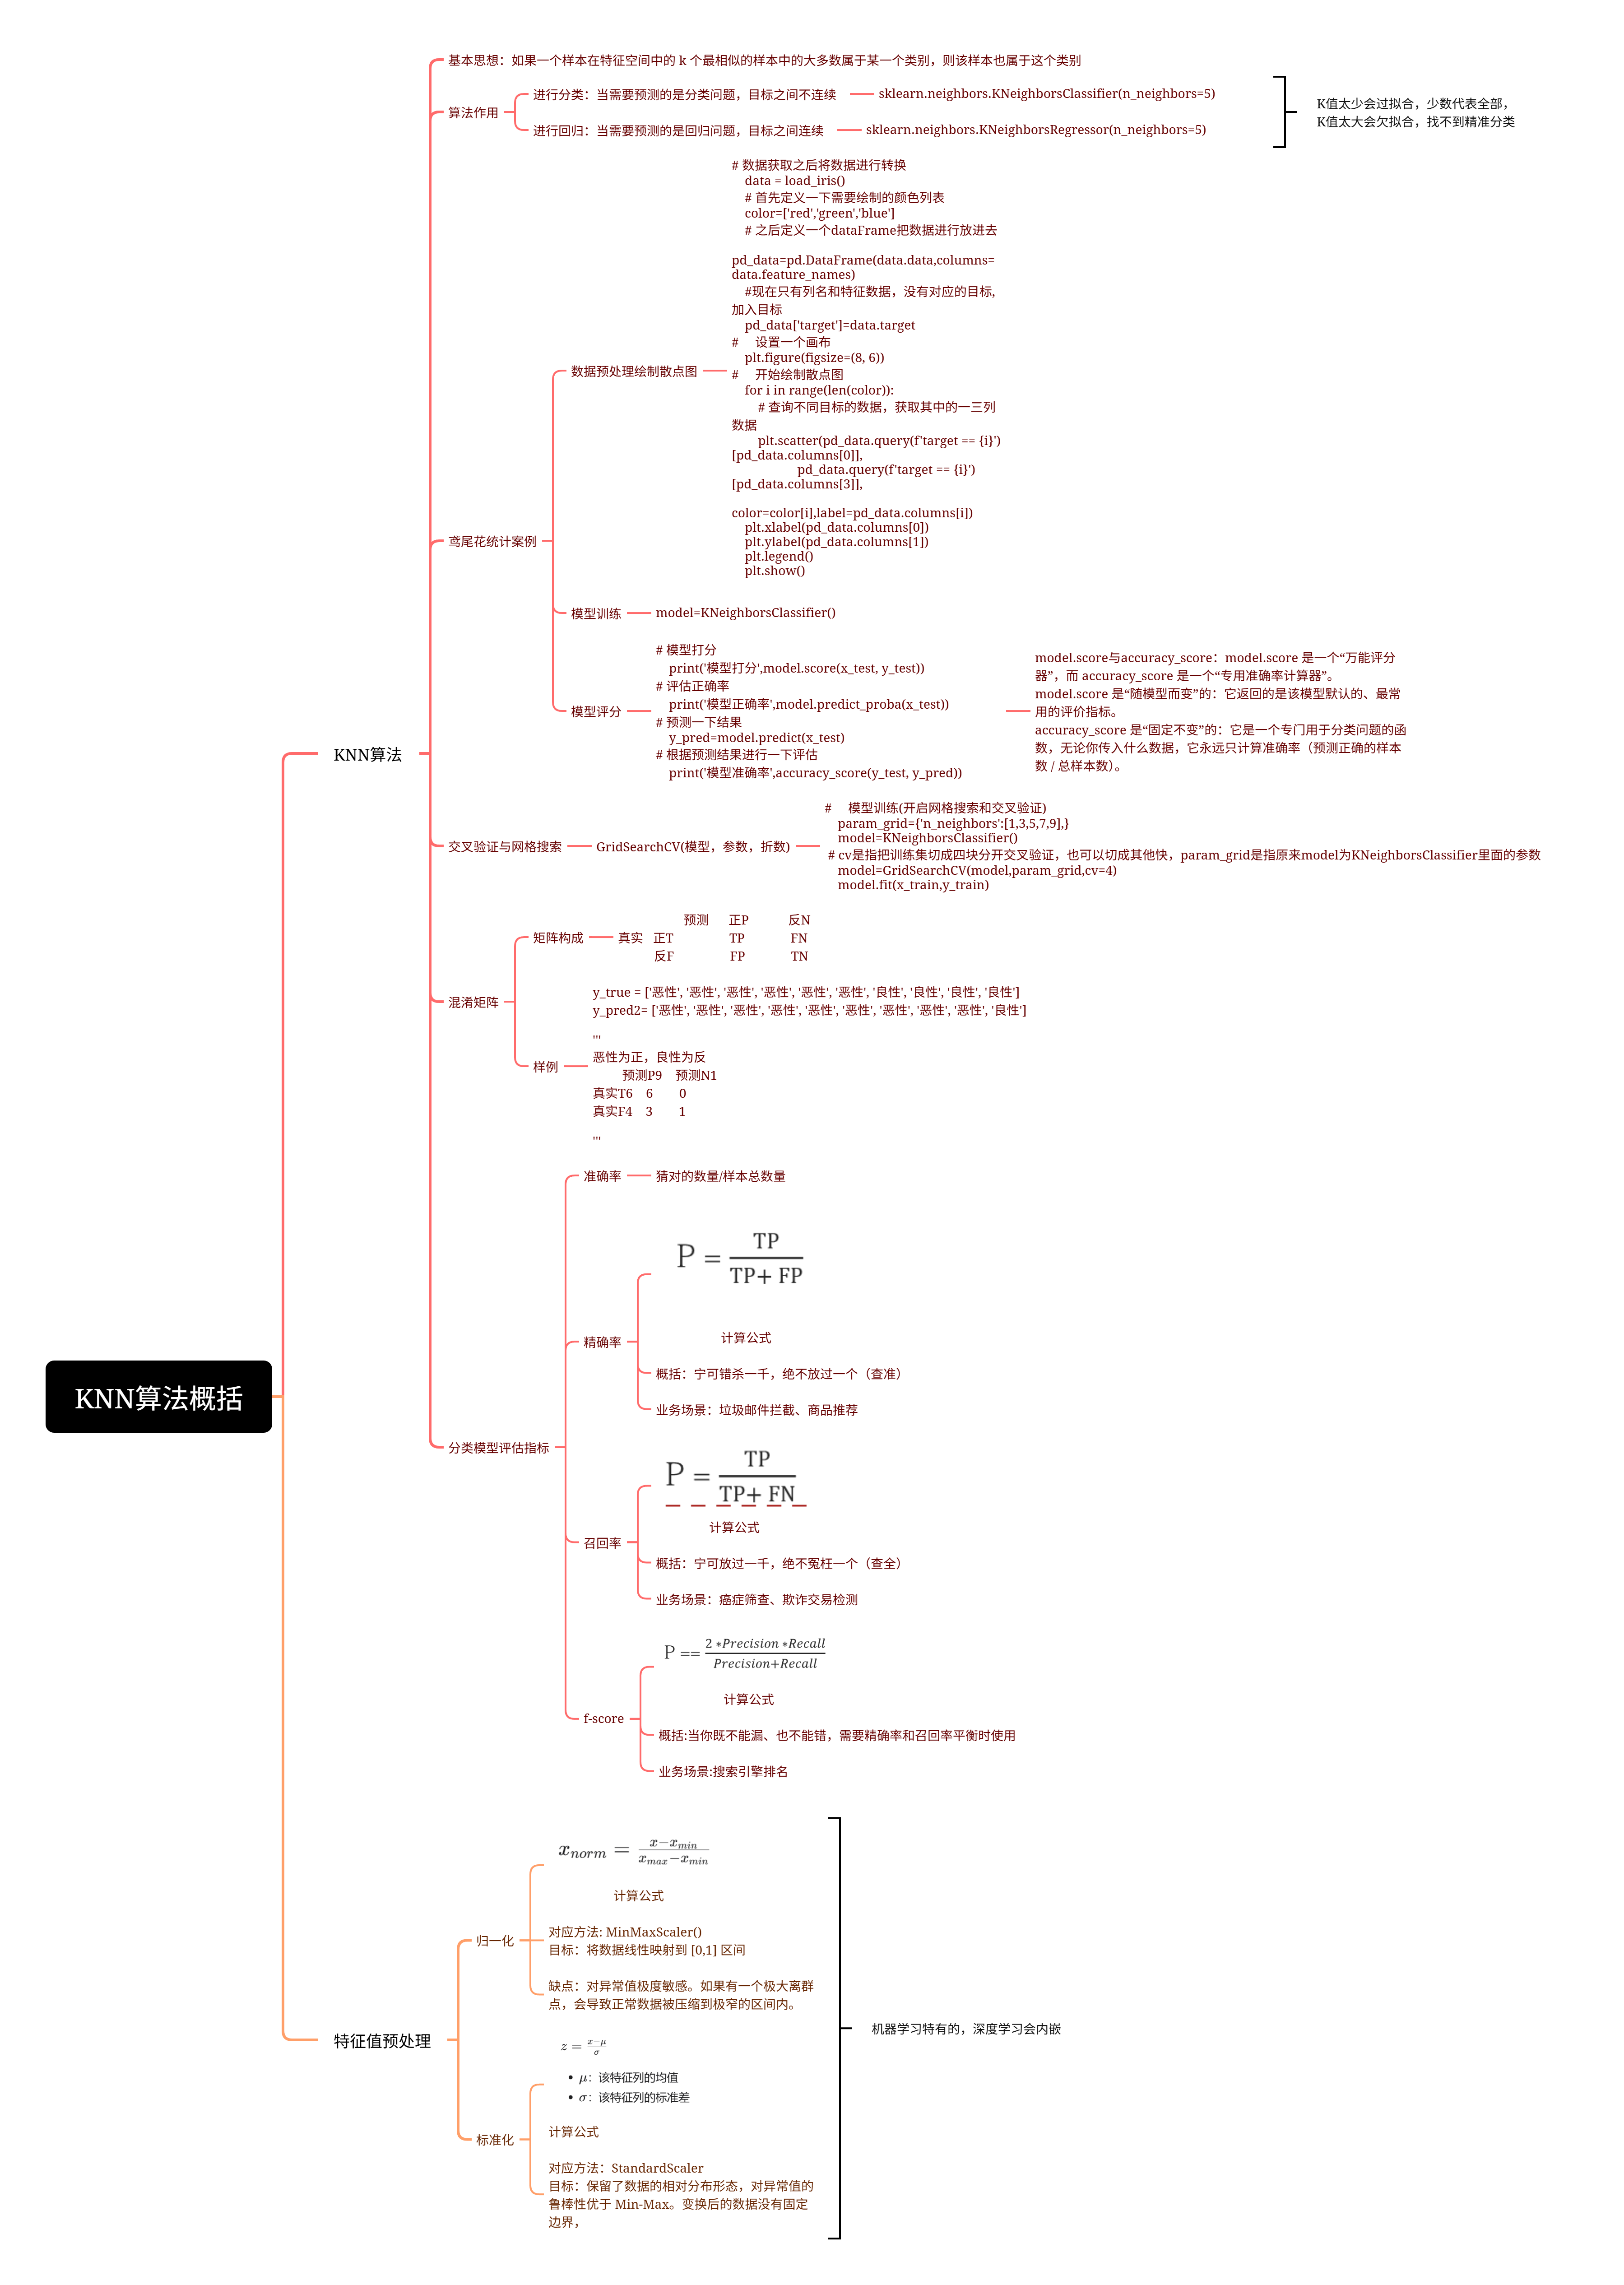
KNN
概念
选出距离当前数据最近的K的样本
分类
基于K个样本进行标签的投票,票数多的就代表我的特征
回归
基于K个样本进行标签的统计,求平均值代表我的标签
API的使用
分类
from sklearn.neighbors import KNeighborsClassifier
回归
from sklearn.neighbors import KNeighborsRegressor
K值的定义(默认是5)
KNeighborsRegressor(n_neighbors=3)
归一化和标准化
归一化
公式 = (特征 - 最小值)/(最大值 - 最小值)
缺点:最大值最小值的异常会影响当前特征
API:MinMaxScaler
scaler = MinMaxScaler()
scaler.fit_transform  #因为没标准需要先训练在使用
标准化
公式 = (特征 - 平均值)/标准差
标准差 = 方差**0.5
方差 = 1/n*∑(特征 - 平均值)²
API:StarndardScaler
scaler = StarndardScaler()
scaler.fit_transform  #因为没标准需要先训练在使用
鸢尾花案例
1.加载数据查看数据
from sklearn.datasets import load_iris
datasets = load_iris()
特征
datasets.data
标签
datasets.target
特征名称
datasets.feature_names
标签名称
datasets.target_names


2.数据的可视化
鸢尾花分为3类:0,1,2
colors = ['red','blue','green']
数据处理
df = pd.DataFrame(datasets.data,datasets.feature_names)
df['target'] = datasets.target
散点图绘制
for i in range(len(colors)):
    x = df.query(f'target = {i}')[datasets.feature_names[0]]
    y = df.query(f'target = {i}')[datasets.feature_names[3]]
    plt.scatter(x,y,color=color[i])
plt.show()


3.机器建模
标准化
训练模型
模型预测
模型评估
模型自己评估(准确率) -model.score(x_test,y_test)
评估模块(准确率) - accuracy_score(y_test,y_pre)
交叉验证
数据集的划分 -> 划分的折数 cv =4 -> 4折验证 -> 分了几折就会训练几次,最后取平均分数
网格搜索
网格搜索需要搭配交叉验证,寻找最优超参
new_model = GridSearchCV(esitmator =模型,param_grid={ 'n_neighbors':[1,3,5,7] },cv=4)
传递一个纯净的模型进去,会返回一个具有查找最优超参能力的模型
new_model.fit()
混淆矩阵
预测: 正Positive 反Negative
真实-正-True 猜对的正TP 真实正-猜对正FN
真实-反-False 真实反-猜对反FP 猜对的反TN
混淆矩阵:confusion_matrix(真实的数据,预测的数据,labels=[正,反])
准确率:TP+TN/(TP+TN+FN+FP)
精确率:TP/(TP+FP) - 查的准不准
召回率:TP/(TP+FN) - 查的全不全
F1-Score: 2精确率*召回率/(精确+召回) - 综合评估指标