Java 8 Stream 与 Lambda:函数式接口与集合流水线
📝 笔记摘要:Java 8 Stream 与 Lambda,把集合处理写成流水线
Java 8 真正改变写法的是两件事:Lambda 让「把行为当参数传」变得自然,Stream 让「一批数据先做什么再做什么」变成一条流水线。写惯之前觉得花哨,写惯之后回不去 for 循环套 for 循环。
这篇分七节:Lambda 表达式、函数式接口、Stream 的三段式结构、中间操作、终端操作、Collectors 归约、并行流。集合本身在 Java 集合笔记 里,Stream 的输入就是那些集合,List<E>、Map<K, V> 的泛型规则见 Java 泛型笔记。
上篇 函数式
1. Lambda 表达式 2. 函数式接口
3. Stream 的三段式结构
下篇 操作与并行
4. 中间操作 5. 终端操作
6. Collectors 归约 7. 并行流
1. Lambda 表达式
Lambda 是「一段没有名字、只有一个方法的代码」。它不是新语法糖之上的语法糖,是接口的一种实现形式——接口有且只有一个抽象方法时,这个接口叫函数式接口,Lambda 就是替它写实现。
没有 Lambda 之前,同一件事有四种写法,从啰嗦到简洁:
// 1. 实现类
public class Greeter implements GreeterService {
    @Override
    public String greet(String name) {
        return "hello " + name;
    }
}

// 2. 静态内部类
static class InnerGreeter implements GreeterService {
    @Override
    public String greet(String name) {
        return "hello " + name;
    }
}

// 3. 局部内部类
class LocalGreeter implements GreeterService {
    @Override
    public String greet(String name) {
        return "hello " + name;
    }
}

// 4. 匿名内部类
GreeterService anon = new GreeterService() {
    @Override
    public String greet(String name) {
        return "hello " + name;
    }
};

// 5. Lambda
GreeterService lambda = name -> "hello " + name;
Lambda 的语法有三个部分:参数列表(括号可省)、箭头 ->、表达式或代码块。只有一个参数且类型能推断时,括号和类型都能省。
Runnable r = () -> System.out.println("no param");

Comparator<String> c1 = (a, b) -> a.compareTo(b);
Comparator<String> c2 = (String a, String b) -> a.compareTo(b);   // 写了类型就不能省括号
Comparator<String> c3 = (a, b) -> {
    int r1 = a.length();
    int r2 = b.length();
    return r1 - r2;                      // 代码块必须用 return 返回
};

BiFunction<Integer, Integer, Integer> add = (a, b) -> a + b;
Lambda 还能直接写成方法引用,方法引用是 Lambda 的一种简写形式:
list.forEach(System.out::println);              // 静态方法引用
list.forEach(s -> System.out.println(s));       // 等价写法

list.stream().map(String::length);               // 实例方法引用
list.stream().map(s -> s.length());            // 等价写法

Supplier<ArrayList<String>> s = ArrayList::new;   // 构造器引用
Function<String, Integer> f = String::length;
BiFunction<String, String, Boolean> g = String::startsWith;
Lambda 只能用在函数式接口上
接口里有两个抽象方法就编译不过
只有一个抽象方法才叫函数式接口,default和static方法可以有多个
Lambda 里的this指向的是定义它的那个类
匿名内部类里的this指向匿名类自己,这是两者最容易混淆的地方
Lambda 捕获的变量必须是 effectively final
捕获后就不能再赋值,要改就把变量放到数组或对象里绕过去
方法引用不是万能的
参数或返回值对不上时老老实实写 Lambda,硬凑方法引用会看得更费劲
2. 函数式接口
JDK 8 在 java.util.function 下备好了常用的一批函数式接口。记住四个核心的,剩下的遇到一个查一个。
// 无参出参:Supplier<T>
Supplier<String> supplier = () -> "hello";

// 有参无出:Consumer<T>
Consumer<String> consumer = s -> System.out.println(s);

// 有参有出:Function<T, R>
Function<String, Integer> function = String::length;

// 有参出布尔:Predicate<T>
Predicate<String> predicate = s -> s.isEmpty();
参数是两个的时候用带 Bi 前缀的:BiFunction、BiConsumer、BiPredicate;返回原始类型的有 ToIntFunction、ToLongFunction、ToDoubleFunction;两个参数还返回一个原始类型的是 ToIntBiFunction 这一类。
自定义函数式接口只要满足「一个抽象方法」,加个 @FunctionalInterface 注解,编译器就会替你检查:
@FunctionalInterface
public interface Transformer<T, R> {
    R transform(T input);

    // default 方法随便加,编译器不认它当抽象方法
    default Transformer<T, R> andThen(Transformer<R, R> after) {
        return value -> after.transform(this.transform(value));
    }
}
自己写的接口加
@FunctionalInterface
多写一个抽象方法立刻编译报错,比事后排查 Lambda 不生效省事
四个核心接口的分工
Supplier无参出参、Consumer有参无出、Function有参出参、Predicate有参出布尔
Stream 里全是这四个的组合
filter要Predicate、map要Function、forEach要Consumer
方法引用比 Lambda 更直观的时候用方法引用
逻辑稍微绕一点就写 Lambda,可读性优先
3. Stream 的三段式结构
Stream 是一串「数据加工流水线」:数据源 → 中间操作 → 终端操作。中间操作是懒执行的,不遇到终端操作,流水线一步都不跑。
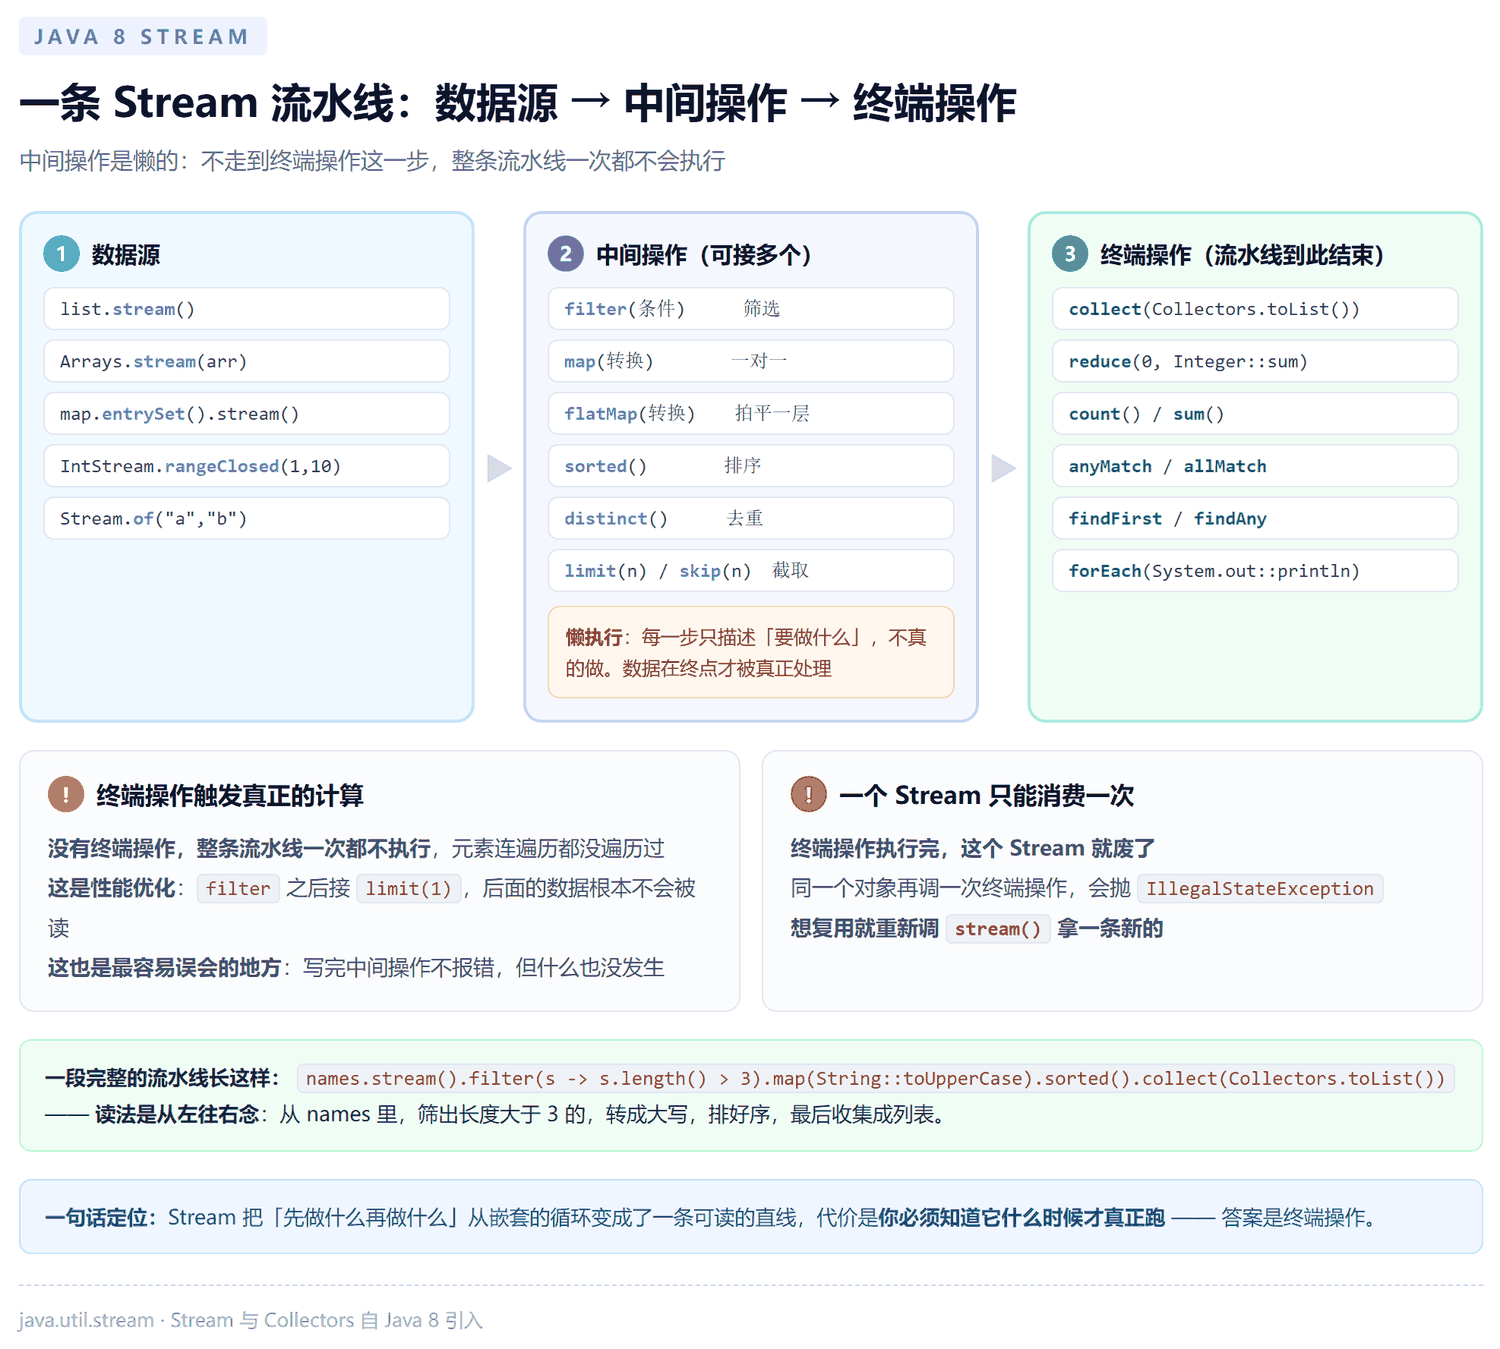
List<String> names = Arrays.asList("alice", "bob", "carol", "dave", "eve");

List<String> result = names.stream()          // 1. 数据源
        .filter(s -> s.length() > 3)          // 2. 中间操作,可以接多个
        .map(String::toUpperCase)
        .sorted()
.collect(Collectors.toList()); // 3. 终端操作,流水线到此才真正执行三段各有各的规矩:数据源有四类(集合、数组、流的生成器、数值区间);中间操作返回新 Stream,不改原集合;终端操作返回普通值或 void,一个 Stream 只能被消费一次。
数据源不只有集合,几种常见的:
// 集合
list.stream();
// 数组
Arrays.stream(new String[]{"a", "b"});
// Map:key 和 value 分成两条流
map.keySet().stream();
map.values().stream();
map.entrySet().stream();
// 数值区间
IntStream.rangeClosed(1, 10).sum();
// 用 Stream 生成
Stream.of("a", "b", "c");
Stream.generate(() -> "x").limit(3);
中间操作是懒执行
没有终端操作,整条流水线一次都不执行,这既是性能优化也是最容易误会的地方
Stream 只能消费一次
用完再stream()一次重新拿,同一个 Stream 对象调两次终端操作会抛IllegalStateException
中间操作不修改原集合
map、filter产生的是新对象,原来的 List 原封不动
Arrays.asList出来的 List 是定长的
能set不能add、不能remove,要增删得包一层new ArrayList<>(...)
并行流别在有顺序要求的地方用
详见第 7 节
4. 中间操作
中间操作分三类:过滤筛选(filter)、转换映射(map、flatMap)、排序去重截取(sorted、distinct、limit、skip)。
List<String> words = Arrays.asList("java", "go", "python", "java", "rust", "c");

words.stream()
     .filter(w -> w.length() > 2)        // 长度大于 2
     .distinct()                           // 去重,依赖 equals 和 hashCode
     .sorted()                             // 升序
     .skip(1)                              // 跳过前 1 个
     .limit(2)                             // 取前 2 个
     .forEach(System.out::println);
map 和 flatMap 的区别是最容易混的一个:map 一对一转换,flatMap 把「流里的流」拍平成一条流。
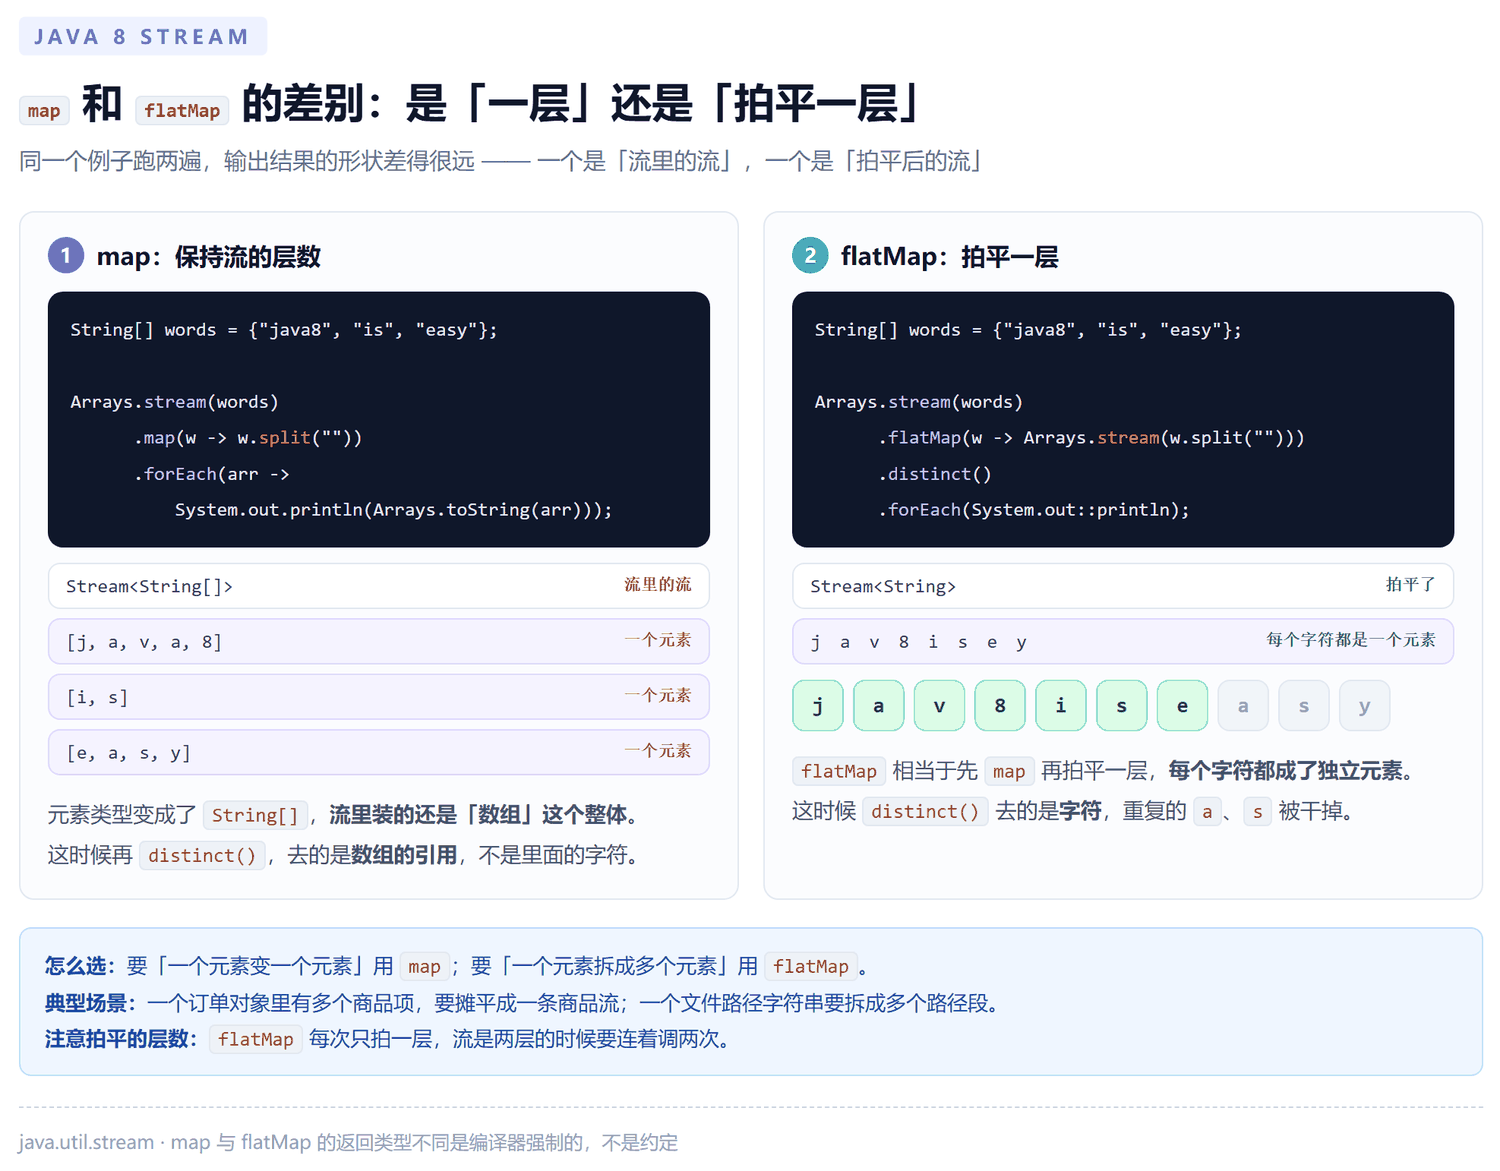
String[] words = {"java8", "is", "easy"};

// map:每个字符串变成字符数组,得到的是 Stream<String[]>
Arrays.stream(words)
      .map(w -> w.split(""))
      .forEach(arr -> System.out.println(Arrays.toString(arr)));
// 输出:[j, a, v, a, 8]、[i, s]、[e, a, s, y]

// flatMap:把字符数组再拆成流,拍平成一条 Stream<String>
Arrays.stream(words)
      .flatMap(w -> Arrays.stream(w.split("")))
      .distinct()
      .forEach(System.out::println);
// 输出:j a v 8 i s e y ... 每个字符各出现一次另外两个常用的:peek 用来在中间做点观察但不改变元素,peek 在并行流里的行为不可靠,别拿它做业务逻辑;mapToInt 之类把流变成数值流,能用 sum、max 这些更直接的聚合。
map和flatMap的差别是「一层还是两层」
map保持流的层数,flatMap每次拍平一层
需要「每个元素再拆成多个元素」就用flatMap
distinct依赖equals和hashCode
对象元素没重写这两个方法,去重就是去重引用,看起来没去掉
limit在并行流上会取消其余任务
顺序流里limit是「取前 n 个」,并行流里找到 n 个就停,可能不是原来的前 n 个
peek只能用来观察
并行流里元素可能同时被多个线程 peek,在里面改共享状态就是埋雷
sorted要给比较器时写全类型
sorted((a, b) -> b.compareTo(a))倒序,元素类型有自然序时sorted()就够
5. 终端操作
终端操作是流水线的终点,触发真正的计算并给出一个结果。分成三类:查找匹配、聚合归约、遍历消费。
List<Student> students = loadStudents();

// 查找匹配
boolean allAdult = students.stream().allMatch(s -> s.getAge() >= 18);
boolean hasJava = students.stream().anyMatch(s -> s.getName().equals("张三"));
boolean noCs = students.stream().noneMatch(s -> s.getMajor().equals("计算机"));
Optional<Student> first = students.stream().filter(s -> s.getAge() > 20).findFirst();
Optional<Student> any = students.stream().filter(s -> s.getAge() > 20).findAny();

// 聚合归约
long count = students.stream().count();
int sum = students.stream().mapToInt(Student::getAge).sum();
Optional<Student> oldest = students.stream()
        .max(Comparator.comparingInt(Student::getAge));
Integer total = students.stream()
        .map(Student::getAge)
        .reduce(0, Integer::sum);

// 遍历消费
students.forEach(System.out::println);
students.stream().forEach(s -> System.out.println(s.getName()));
reduce 有两个重载:带初始值的返回原始类型,不带初始值的返回 Optional——因为空流没法给初始值。
findFirst和findAny在顺序流里结果一样
并行流里findAny更快,但返回的不一定是第一个
要「找到就停」就用findAny
要「第一个」就必须用findFirst
count()有优化路径
数据源是Collection时size()直接返回,不需要遍历元素
reduce三个参数的重载能带容器
reduce(identity, accumulator, combiner)是给并行流用的,顺序流用不上
终端操作只触发一次,中间操作想复用就重新stream()
同一个 Stream 对象消费两次会抛IllegalStateException
6. Collectors 归约
collect 是最常用的终端操作,Collectors 里备了一堆「怎么攒」的策略。最常用的是 toList()、toSet()、toMap()、groupingBy()。
// 转成 Map,key 和 value 各取一列
Map<Long, String> nicknameMap = identities.stream()
        .collect(Collectors.toMap(UserIdentity::getUserId, UserIdentity::getNickname));

// key 重复时保留旧值,否则用第四个参数指定合并策略
Map<Long, String> safe = identities.stream()
        .collect(Collectors.toMap(UserIdentity::getUserId,
                                  UserIdentity::getNickname,
                                  (oldValue, newValue) -> oldValue));

// 按字段分组
Map<String, List<Student>> bySchool = students.stream()
        .collect(Collectors.groupingBy(Student::getSchool));

// 分组的同时统计个数
Map<String, Long> countBySchool = students.stream()
        .collect(Collectors.groupingBy(Student::getSchool, Collectors.counting()));

// 多级分组
Map<String, Map<String, List<Student>>> bySchoolThenMajor = students.stream()
        .collect(Collectors.groupingBy(Student::getSchool,
                Collectors.groupingBy(Student::getMajor)));

// 一趟拿到个数、总和、均值、最大值、最小值
IntSummaryStatistics stats = students.stream()
        .collect(Collectors.summarizingInt(Student::getAge));
// stats: count=10, sum=220, min=20, average=22.0, max=24

// 拼成字符串
String names = students.stream()
        .map(Student::getName)
        .collect(Collectors.joining(", "));
toMap 有个坑:key 重复会直接抛 IllegalStateException,因为它不知道该留哪个。第三个参数就是干这个的。
toMap的 key 重复会抛异常
报IllegalStateException: Duplicate key
必须写第三个合并参数,想留旧值就(old, new) -> old
第三个参数返回null会出问题
HashMap允许 null value,toMap不允许,要用Collectors.toMap(keyFn, valFn, mergeFn, mapSupplier)指定容器
groupingBy的第二个参数是「组内怎么攒」
不写默认toList(),写成Collectors.counting()就是分组计数
groupingBy不接受 null key
字段可能为 null 时用groupingBy(fn, LinkedHashMap::new, toList())或先过滤掉
要保留顺序就用LinkedHashMap
groupingBy默认返回HashMap,顺序不保证
7. 并行流
parallelStream() 把数据切块交给 ForkJoinPool.commonPool() 并行处理。快不快取决于数据量和操作类型,不是加了就快。
List<Integer> numbers = IntStream.rangeClosed(1, 1_000_000).boxed().toList();

// 顺序流
long t1 = System.nanoTime();
numbers.stream().map(i -> i * 2).count();
System.out.println((System.nanoTime() - t1) / 1_000_000 + "ms");

// 并行流
long t2 = System.nanoTime();
numbers.parallelStream().map(i -> i * 2).count();
System.out.println((System.nanoTime() - t2) / 1_000_000 + "ms");并行流不是免费的,数据量小的时候它更慢:切块、线程调度、合并结果都有开销。经验值是元素数量上万、单个元素处理有一定耗时的时候才划算。
还有一个更实际的坑:并行流共用一个线程池。如果代码里在并行流的 lambda 内部又提交任务到同一个池,会互相等待,表现为卡死而不是变慢。
数据量小别用并行流
拆分和线程调度本身有成本,几百个元素并行跑一定更慢
有顺序要求的地方别用并行流
forEach在并行流里的输出顺序不保证,要顺序用forEachOrdered
lambda 里不要改共享状态
并行流里多个线程同时写同一个ArrayList会丢数据,用collect收集,别自己往共享集合里塞
lambda 里别做阻塞操作
并行流共用ForkJoinPool.commonPool(),在里面做 IO 等待会把整个池占住
并行流和parallelSort是两回事
list.parallelSort()是排序专用的并行实现,不要自己用sort硬凑
💡 补充几个容易忽略的:
Stream 不是集合,是一次性视图
它不存数据,数据源改了再看 Stream 看到的是新数据,但同一个 Stream 不能消费两次
Lambda 里能捕获的变量必须是 effectively final
需要累加结果就用collect或者reduce,别去改外部变量
Collectors.toMap的 value 不能为 null
字段本身可能为 null 时,用toMap的四参数重载换HashMap
Stream.ofNullable能把 null 包成单元素流
配合filter(Objects::nonNull)处理可空字段很顺手
方法引用在 IDE 里会被提示,但别无脑接受
可读性优先,绕的 Lambda 留在原地
想按 Java 8 以前的写法重写整条流水线,是过度重构
新代码就用 Stream,老代码读得懂就行,不必全量改
🔥 一句话总结:Lambda 是函数式接口的实现形式,接口只能有一个抽象方法,核心四件套是
Supplier、Consumer、Function、Predicate;Stream 是数据源 → 中间操作 → 终端操作的三段流水线,中间操作懒执行,Stream 只能消费一次;中间操作里map一对一、flatMap拍平一层,distinct依赖equals和hashCode;终端操作里findAny并行更快、findFirst才是第一个,reduce不带初始值返回Optional;Collectors.toMapkey 重复会抛异常,必须给合并函数;并行流只在数据量大时划算,共用线程池,lambda 里别碰共享状态。