Java 集合笔记:框架体系、List/Set/Map 与底层实现
📝 笔记摘要:Java 集合,框架体系与底层实现
数组能装东西,但改不了长度、只能装一种类型、增删元素要整体搬。集合框架把这三件事全解决了,还顺手给了不同的存储结构:查得多用哈希表,增删得多用链表,要排序用红黑树。
这篇按框架体系往下走:Collection 接口的通用方法、迭代器的并发修改问题、List / Set / Map 各自的实现差异和底层结构,最后是 Collections 工具类。泛型那套 List<E>、Map<K, V> 的规则在 Java 泛型笔记 里,集合里出现的尖括号按那套理解就行。
上篇 框架与接口
1. 为什么用集合 2. 集合框架体系
3. Collection 接口与常用方法 4. 迭代器与增强 for
下篇 三种实现与工具类
5. List 的四个实现 6. Set 的三个实现
7. Map 的四个实现 8. Collections 工具类
1. 为什么用集合
数组的三个限制是出了名的:长度在创建时定死、只能存同一种基本类型、增删元素要把后面的整体搬位。集合把这三件事全接了过去,代价是每个元素多一层包装、泛型擦除后不能存基本类型。
// 数组:长度写死,类型写死,插入要整体搬
String[] names = new String[3];
names[0] = "a";
names[1] = "b";
names[2] = "c";
names[3] = "d";              // 编译不过:ArrayIndexOutOfBoundsException 在等着

// 集合:长度动态,类型由泛型管,插入删改都有现成方法
List<String> names = new ArrayList<>();
names.add("a");
names.add("b");
names.remove(0);             // 删的是值还是下标,取决于重载的是 remove(Object) 还是 remove(int)
names.add(0, "c");           // 带下标的插入只有 List 有
数组不是被集合淘汰了,是分工不同
元素固定、要求连续内存、要极致性能,数组仍然更合适
集合底层大量用数组实现,选集合不等于放弃数组
remove有两个重载,最容易踩的就是它
remove(int)删的是下标,remove(Object)删的是值
list.remove(0)删下标,list.remove("0")删值
基本类型进不了泛型容器
List<int>非法,要写List<Integer>
大量基本类型直接用数组,别为了「统一风格」全塞进 ArrayList
2. 集合框架体系
整个框架就三个顶层接口:Iterable 提供迭代能力,Collection 是单列集合的根,Map 是双列集合的根,它不继承 Collection,因为「键值对」和「元素」是两种不同的模型。
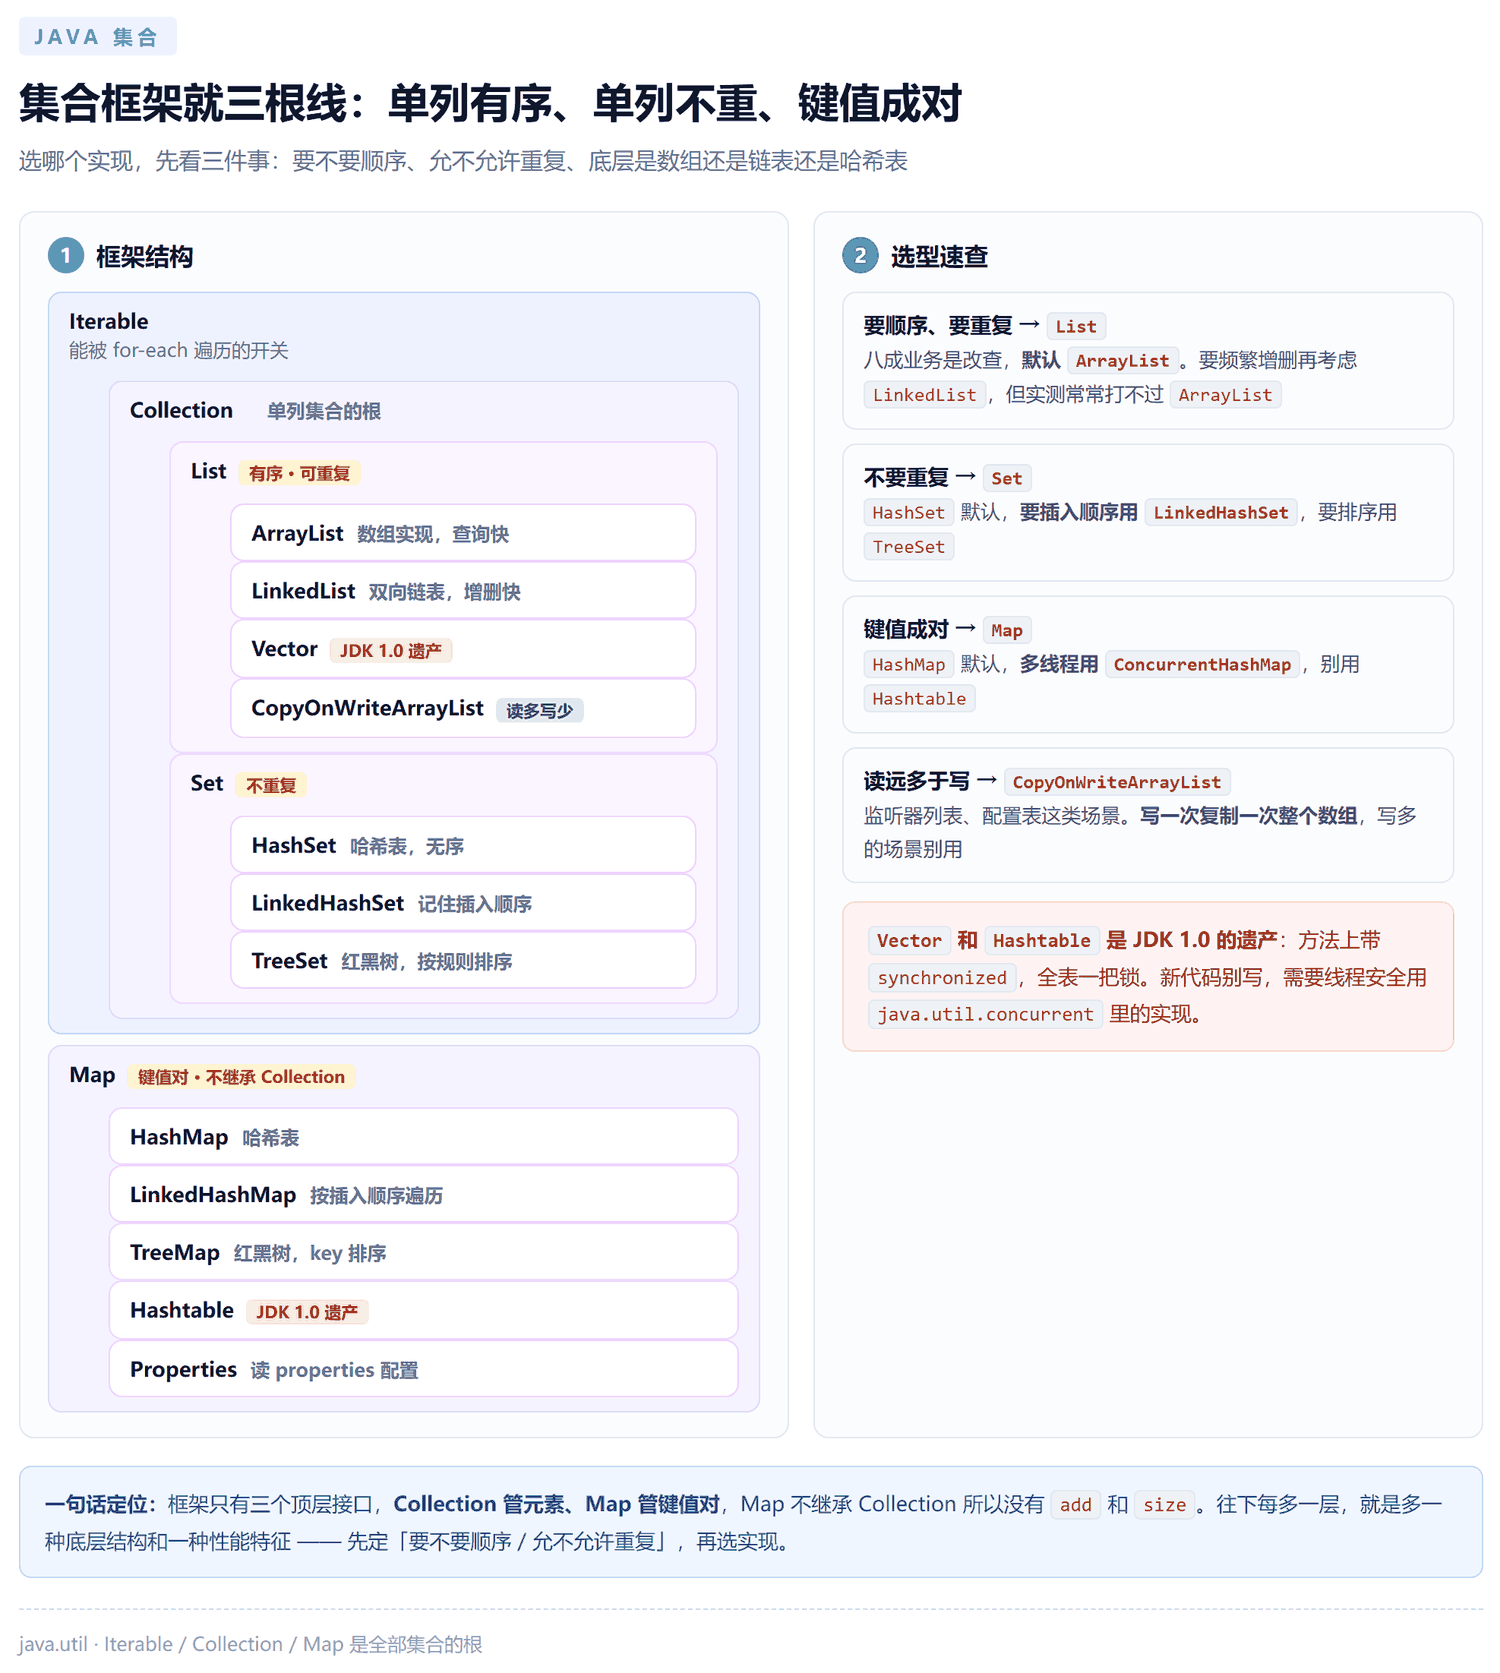
单列集合分两支:List 有序可重复,Set 无序不重复。双列集合 Map 的 key 不重复、value 可以重复。
// 单列集合
Iterable
└── Collection
    ├── List        有序、可重复
    │   ├── ArrayList          数组实现,查询快
    │   ├── LinkedList          双向链表,增删快
    │   ├── Vector              数组实现,方法带 synchronized
    │   └── CopyOnWriteArrayList 写时复制,读多写少
    └── Set         无序、不重复
        ├── HashSet            哈希表
        ├── LinkedHashSet       哈希表 + 双向链表,记住插入顺序
        └── TreeSet             红黑树,按规则排序

// 双列集合
Map
├── HashMap            哈希表
│   └── LinkedHashMap  哈希表 + 双向链表
├── TreeMap            红黑树
└── Hashtable          哈希表,方法带 synchronized
    └── Properties     读 properties 配置用
选型的第一条依据是「要不要顺序」和「要不要重复」
要顺序要重复 →List;不要重复 →Set;要键值对 →Map
Map不是Collection的子类
所以Collection的方法(add、size)在Map上用不了
遍历 Map 要走entrySet()、keySet()、values()三条路
Iterable是「能被 for-each 遍历」的开关
自己实现Iterable,你的类就能进 for-each
Vector和Hashtable是 JDK 1.0 的遗产
方法上带synchronized,全表一把锁,性能不如新实现
新代码用ArrayList配Collections.synchronizedList,或直接上CopyOnWriteArrayList
3. Collection 接口与常用方法
Collection 是接口,不能实例化,拿 ArrayList 当它的实现来演示。接口上定义的方法分三类:增删改查、批量操作、判断类。
import java.util.ArrayList;
import java.util.Collection;

public class CollectionDemo {
    public static void main(String[] args) {
        Collection<Object> list = new ArrayList<>();

        // 增
        list.add("a");
        list.add(1);
        list.add(false);

        // 删:按值删,删成功返回 true
        boolean removed = list.remove("a");

        // 查
        boolean hasC = list.contains("c");
        int size = list.size();
        boolean empty = list.isEmpty();

        // 批量操作:参数是 Collection 就行,List / Set 都能传
        Collection<Object> other = new ArrayList<>();
        other.add("x");
        other.add("y");
        list.addAll(other);
        boolean containsAll = list.containsAll(other);
        boolean removeAll = list.removeAll(other);

        // 清空
        list.clear();
    }
}
Collection 上没有 get(int),因为集合的基本约定是不保证有序,按下标取元素这种事只有 List 敢承诺。
remove(Object)和remove(int)的分界
传int字面量 → 走remove(int),删下标
传Integer对象 → 走remove(Object),删值
想删下标又怕歧义,写成remove(Integer.valueOf(0))或者干脆用subList之外的方式
集合允许存null,但不是所有实现都允许
ArrayList、HashMap允许,Hashtable不允许,存 null 直接抛NullPointerException
clear()只是清空引用,不释放堆内存压力
元素很多时list.clear()之后对象仍可能被 GC 观察期卡住
大列表释放内存用list = null更干脆
4. 迭代器与增强 for
遍历集合用 Iterator,for-each 只是它的语法糖。Iterator 的规矩是:先 hasNext() 判断能不能下移,再 next() 取值,少一步就 NoSuchElementException。
import java.util.ArrayList;
import java.util.Iterator;
import java.util.List;

public class IteratorDemo {
    public static void main(String[] args) {
        List<String> names = new ArrayList<>(List.of("a", "b", "c"));

        Iterator<String> it = names.iterator();
        while (it.hasNext()) {
            String next = it.next();
            System.out.println(next);
        }

        // for-each 就是上面那段的语法糖
        for (String name : names) {
            System.out.println(name);
        }
    }
}但用迭代器遍历时在循环体里增删元素会抛 ConcurrentModificationException。原因是迭代器记着创建时的 modCount,集合每改一次就加一,遍历到末尾一对不上就报「并发修改」。
List<String> names = new ArrayList<>(List.of("a", "b", "c"));

// 增强 for 里删元素:抛 ConcurrentModificationException
for (String name : names) {
    if (name.equals("a")) {
        names.remove(name);         // 改结构了,迭代器察觉到了
    }
}

// 要边遍历边删,用迭代器自己的 remove
Iterator<String> it = names.iterator();
while (it.hasNext()) {
    if (it.next().equals("a")) {
        it.remove();                // 走迭代器的 remove,不改 modCount
    }
}

// 或者用 removeIf,Java 8 之后最省事
names.removeIf(name -> name.equals("a"));
并发修改异常不是「多线程」的意思
单线程里边遍历边改集合一样会抛,它防的是「遍历过程中集合被换了」
想遍历时删除,用迭代器的remove()
它改的是集合内部状态但不碰modCount
Java 8 之后优先removeIf
底层用bulkRemove一次性处理,比逐个iterator.remove()快
遍历 Map 同样有这个问题
entrySet()拿到的是视图,遍历时改 Map 一样炸
5. List 的四个实现
List 有序、可重复、按索引访问。四个实现底层完全不同,选错了性能差一个数量级。
ArrayList
底层是 Object[] 数组。查询按索引直接算地址,O(1);增删要搬后面的元素,O(n)。默认构造出来是空数组,第一次 add 才把容量撑到 10,之后按 1.5 倍扩。
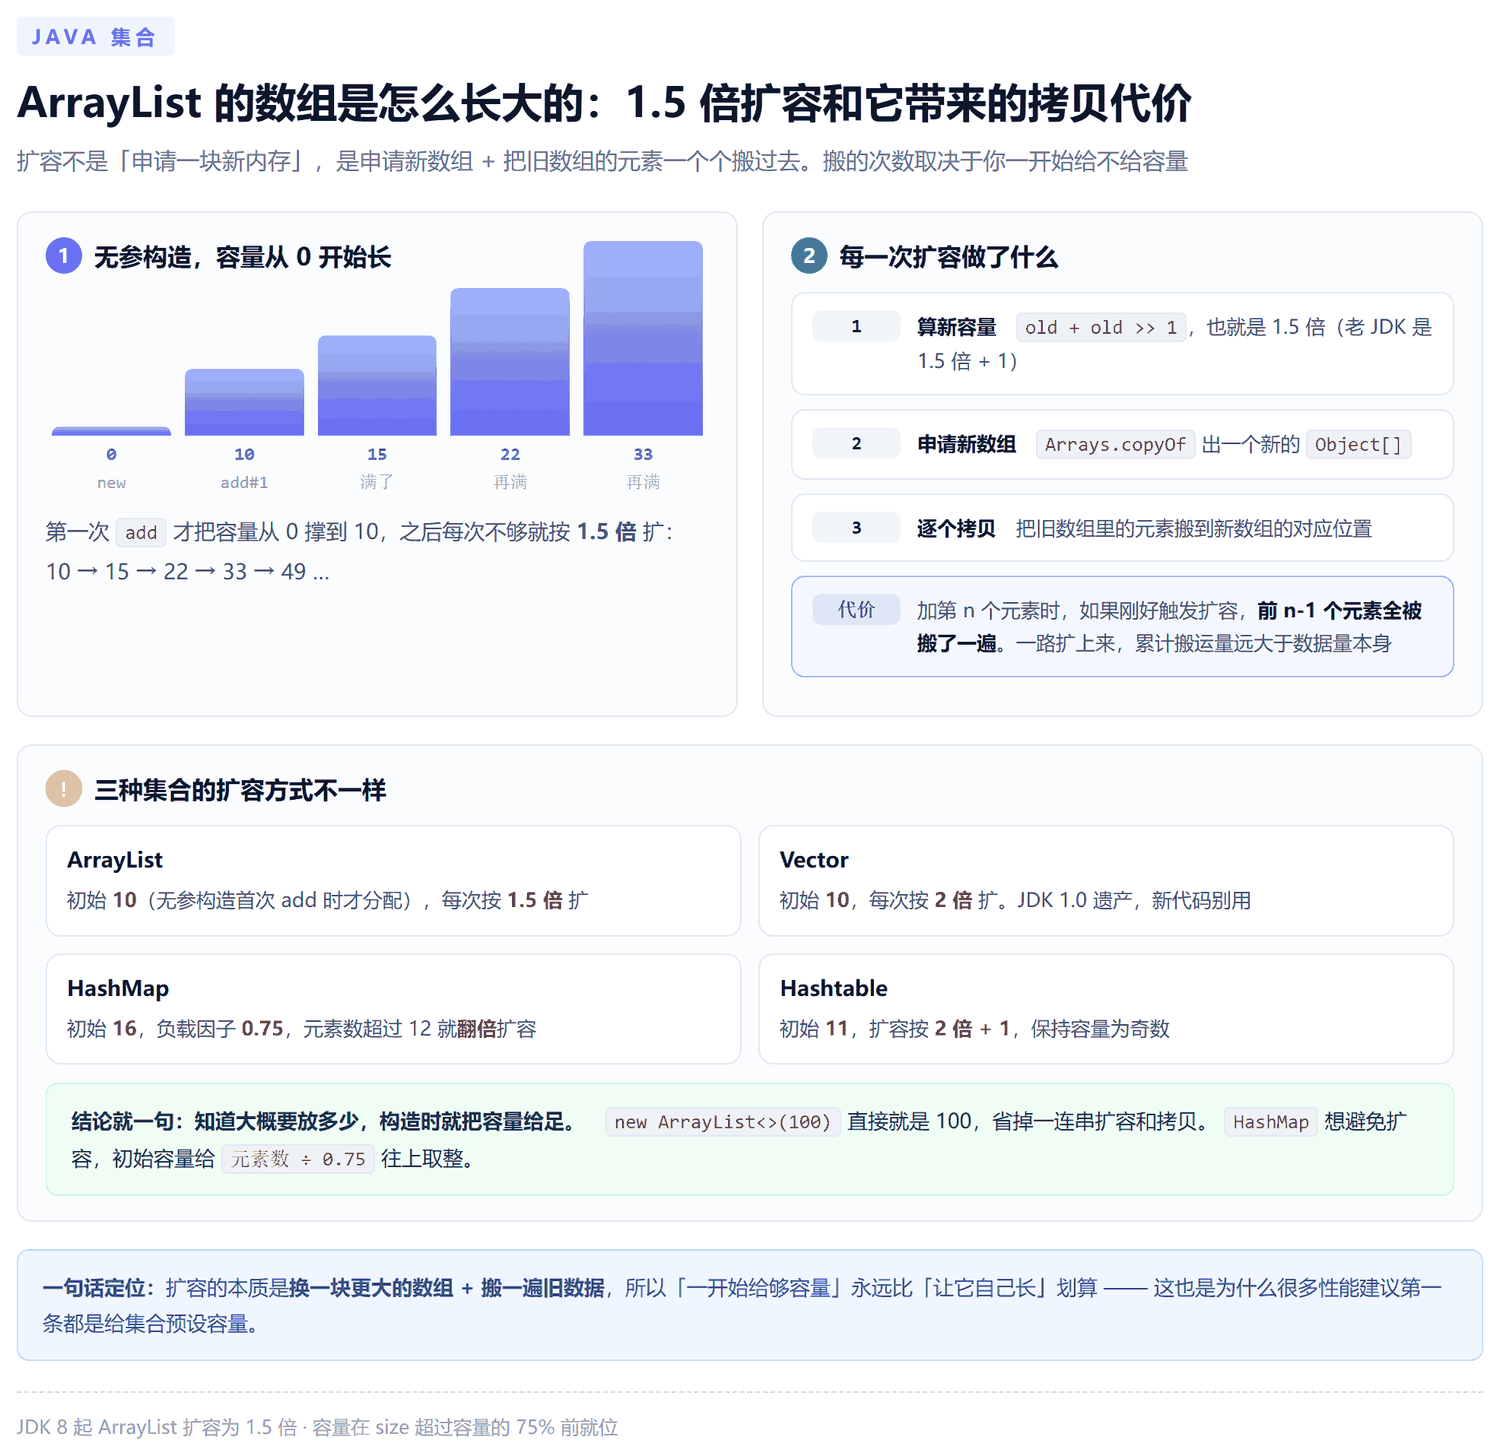
List<Integer> list = new ArrayList<>();       // 容量 0,第一次 add 后变 10
list.add(1);                                        // 10 装满了
list.add(2);                                        // 扩容到 15
// 10 -> 15 -> 22 -> 33 ... 每次 1.5 倍

// 知道大概要放多少,构造时直接给容量,省掉一连串扩容拷贝
List<Integer> planned = new ArrayList<>(100);
Vector 结构和 ArrayList 几乎一样,区别是方法上带 synchronized,而且扩容按 2 倍。它属于 JDK 1.0 的遗产,新代码别用,需要线程安全用 CopyOnWriteArrayList。
LinkedList
底层是双向链表,每个节点存 item、prev、next 三个引用。头插尾插只要改几个指针,增删是 O(1);查第 n 个要一步步走,是 O(n)。
LinkedList<String> list = new LinkedList<>();
list.add("b");                 // 尾插
list.addFirst("a");            // 头插
list.addLast("c");
list.remove();                 // 删掉第一个
list.remove("b");              // 删掉值为 b 的
list.remove(1);                // 删下标 1
它同时实现了 Deque,所以能当双端队列用:addFirst、addLast、push、poll、peek 都有。但实际项目里 LinkedList 用得很少——遍历时缓存命中率差、每个节点多两个指针的内存开销,实测常常打不过 ArrayList。
CopyOnWriteArrayList
写时复制:每次写操作都复制一份完整数组,读操作不加锁直接读当前数组。遍历时不会抛并发修改异常,因为迭代器拿的是一份快照。
CopyOnWriteArrayList<Integer> list = new CopyOnWriteArrayList<>();
for (int i = 0; i < 10; i++) {
    list.add(i);
}

// 迭代时删除,ArrayList 会炸,这个不会
Iterator<Integer> it = list.iterator();
while (it.hasNext()) {
    Integer v = it.next();
    if (v % 2 == 0) {
        list.remove(v);          // 每次删都复制一份数组
    }
}
ArrayList 扩容是 1.5 倍,Vector 是 2 倍
两者初始容量都是 10(new ArrayList<>(n)指定容量时直接就是 n)
CopyOnWriteArrayList 写一次复制一次整个数组
只适合「读远多于写」的监听器列表、配置表这类场景
写多的场景它就是灾难,add一百万次等于复制一百万次
LinkedList的增删优势只在「已知节点位置」时成立
按值查找它还是 O(n),而且每次遍历都要new节点,GC 压力大
八成业务是改查,ArrayList是默认选择
真正要频繁增删,先怀疑是不是数据结构选错了,而不是换LinkedList
6. Set 的三个实现
Set 不允许重复元素。「不允许重复」靠的是 equals 和 hashCode 这一对契约,不是靠引用比较。
HashSet 底层就是一个 HashMap,元素当 key,value 是个固定占位对象。LinkedHashSet 在哈希表外多接一条双向链表,记住插入顺序。TreeSet 底层是 TreeMap,按规则排序。
Set<String> hashSet = new HashSet<>();
hashSet.add("java");
hashSet.add("php");
hashSet.add("java");
System.out.println(hashSet.size());        // 2,重复的 java 没进去

Set<String> linked = new LinkedHashSet<>();
linked.add("php");
linked.add("java");
linked.add("c++");
System.out.println(linked);                // [php, java, c++],按插入顺序

// 自定义排序
TreeSet<String> tree = new TreeSet<>(Comparator.reverseOrder());
tree.add("jack");
tree.add("a");
System.out.println(tree);                  // [jack, a],倒序
用自定义对象做 HashSet 元素时,equals 和 hashCode 必须同时重写,只写一个必出问题。
public class Employee {
    private final String id;
    private final String name;

    public Employee(String id, String name) {
        this.id = id;
        this.name = name;
    }

    @Override
    public boolean equals(Object o) {
        if (this == o) return true;
        if (!(o instanceof Employee other)) return false;   // Java 16+ 的模式匹配
        return Objects.equals(id, other.id);
    }

    @Override
    public int hashCode() {
        return Objects.hash(id);          // 只用 id 参与哈希,和 equals 的判断字段保持一致
    }
}
equals和hashCode必须一起重写
约定是:equals相等的对象,hashCode必须相等
只重写equals的后果是两个「内容相同」的对象被当成两个元素,Set里出现重复
哈希字段要选「不变」的
放进HashSet之后再改参与哈希的字段,对象就再也找不到了,还可能造成内存泄漏
TreeSet的排序靠Comparable或构造时传的Comparator
两者都没有会抛ClassCastException
HashSet的「无序」不是随机的
顺序由哈希值决定,同样的元素每次遍历顺序都一样,换了顺序说明元素集合变了
要按插入顺序就用LinkedHashSet
7. Map 的四个实现
Map 存键值对。key 不重复、value 可以重复;HashMap 允许一个 null key 和多个 null value,Hashtable 一个都不许。
HashMap 的底层是数组 + 链表 + 红黑树三段结构:数组是桶,每个桶先挂链表,链表太长时转成红黑树。
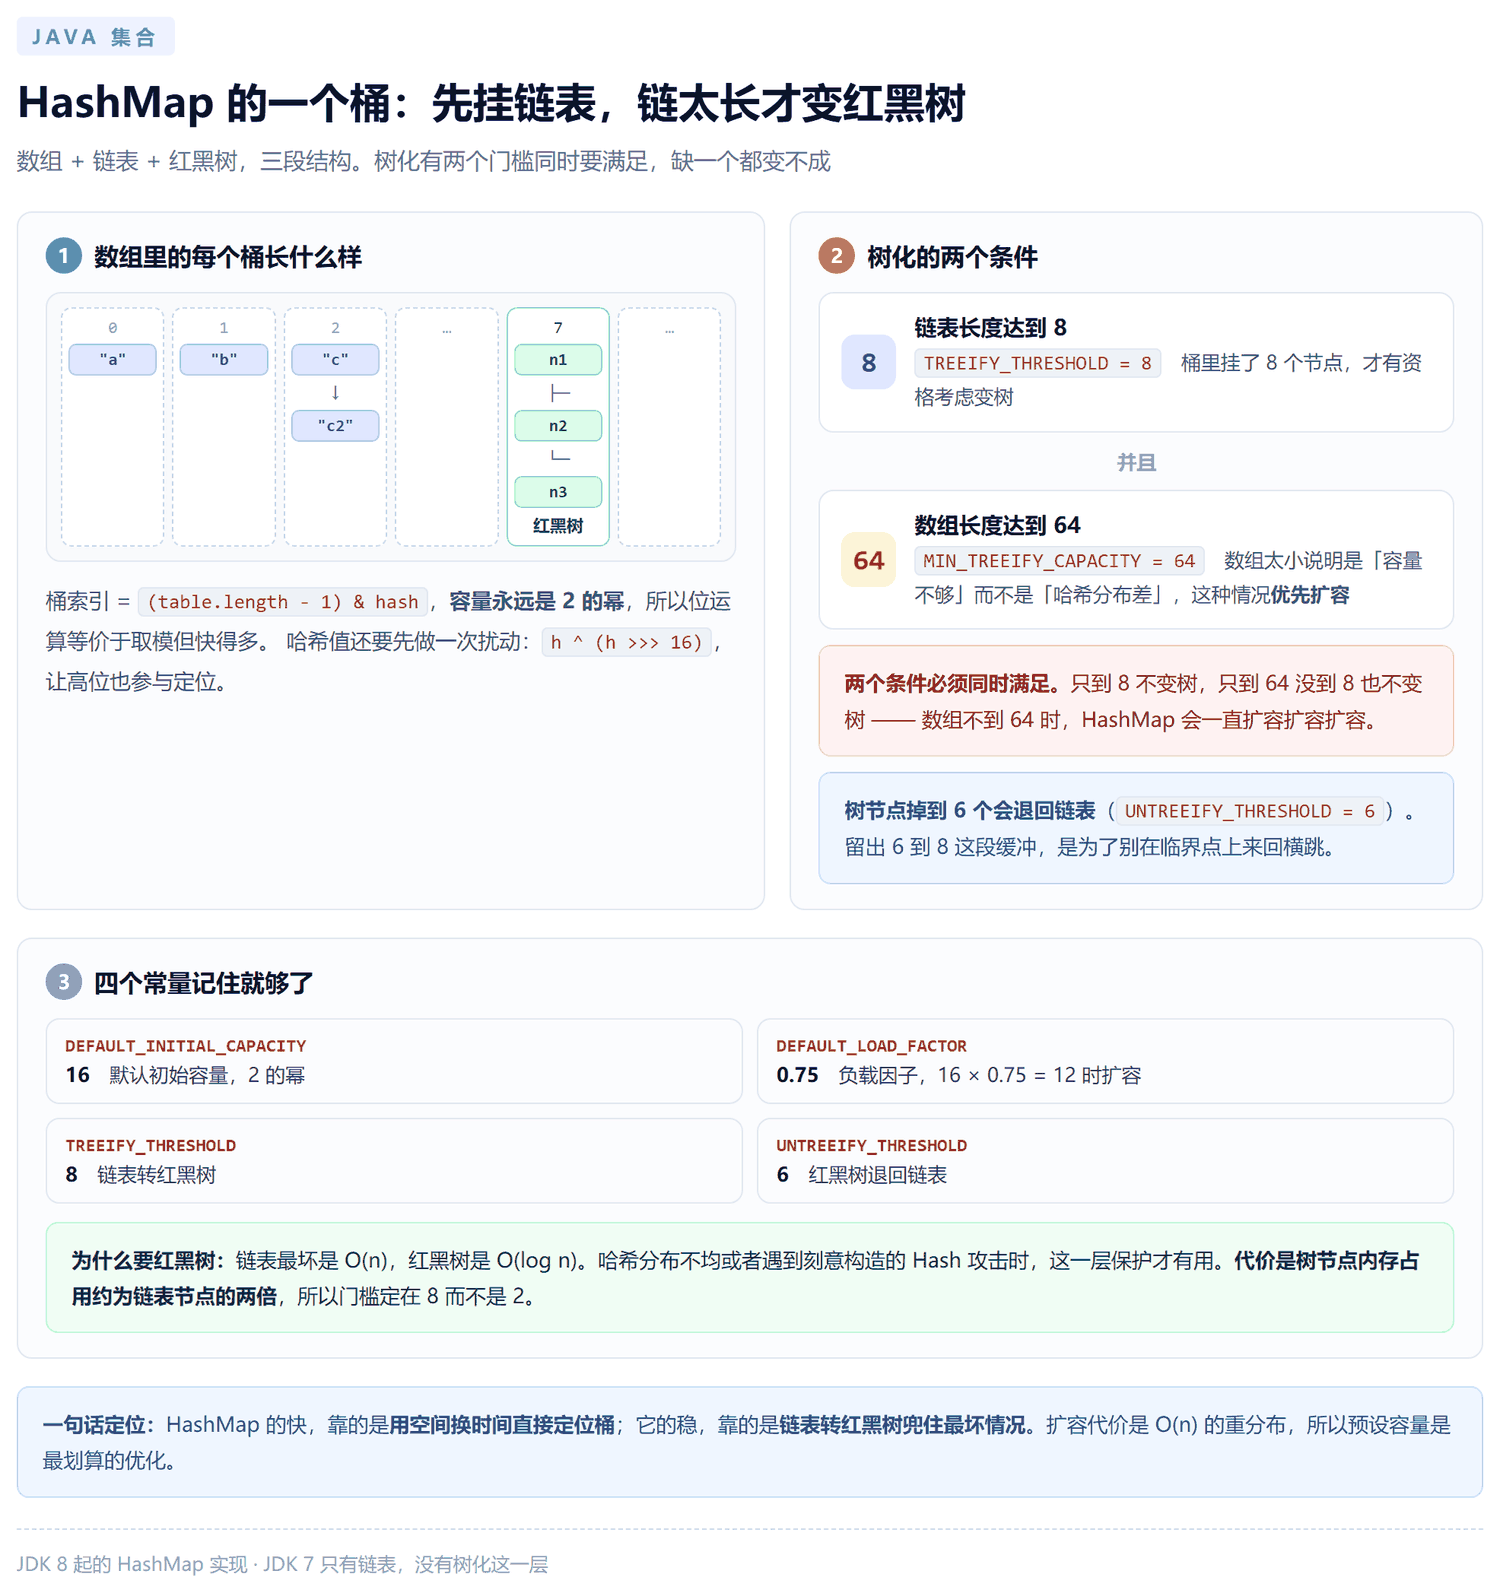
// 默认初始容量 16,负载因子 0.75,超过 12 就扩容翻倍
Map<String, Integer> map = new HashMap<>();
map.put("no1", 1);
map.put("no2", 2);

Integer v = map.get("no2");           // 2
Integer d = map.get("missing");       // null
map.containsKey("no1");               // true
map.containsValue(2);                 // true
map.remove("no1");                    // 返回被删的值 1
map.size();                           // 1
遍历 Map 有三条路,优先走 entrySet(),它一次拿到键和值,不用查两遍:
for (Map.Entry<String, Integer> entry : map.entrySet()) {
    System.out.println(entry.getKey() + "-" + entry.getValue());
}

// 只需要键
for (String key : map.keySet()) { }

// 只需要值
for (Integer value : map.values()) { }
Hashtable 是 HashMap 的前辈,方法带 synchronized,不允许 null,默认初始容量 11,扩容按「2 倍 + 1」。LinkedHashMap 在哈希表外接一条双向链表,按插入顺序遍历。TreeMap 是红黑树,key 按规则排序。
哈希表的核心是四个常量
DEFAULT_INITIAL_CAPACITY = 16、DEFAULT_LOAD_FACTOR = 0.75
TREEIFY_THRESHOLD = 8链表转红黑树、MIN_TREEIFY_CAPACITY = 64数组够大才转
两个条件要同时满足,数组不到 64 只会扩容,树化不上去
红黑树节点掉到 6 个会退回链表
UNTREEIFY_THRESHOLD = 6,留出 6 到 8 的缓冲区间是为了别来回横跳
Map 允许 null,但 ConcurrentHashMap 不允许
并发场景下「key 不存在」和「key 存在但 value 是 null」没法区分
Properties是给配置文件用的
读.properties时用,继承自Hashtable,value 只能是 String
多线程下要用ConcurrentHashMap
Hashtable是全表一把锁,ConcurrentHashMap是桶级锁,差距比想象中大
8. Collections 工具类
Collections 是给集合的静态工具类,方法都在 java.util 里,不用导包冲突,但和 Collection 只差一个 s,import 的时候容易看花眼。
import java.util.Collections;
import java.util.List;

public class CollectionsDemo {
    public static void main(String[] args) {
        List<String> list = new ArrayList<>(List.of("a", "b", "c"));

        Collections.reverse(list);                   // 反转
        Collections.shuffle(list);                   // 洗牌,随机
        Collections.sort(list);                      // 自然序排序
        Collections.sort(list, Comparator.reverseOrder());   // 指定比较器

        Collections.swap(list, 0, 2);                // 交换两个位置的元素

        List<String> empty = Collections.emptyList();   // 不可变的空列表
        List<String> single = Collections.singletonList("only");
        Map<String, String> one = Collections.singletonMap("k", "v");

        List<String> safe = Collections.unmodifiableList(list);   // 只读视图
        List<String> sync = Collections.synchronizedList(list);    // 线程安全包装
    }
}
unmodifiableList 返回的是视图不是拷贝,原列表改了它跟着改,只是挡住你从视图上改。
Collections.sort改的是原列表
它不是返回新列表,是原地排序
unmodifiableList是视图不是快照
原列表改了它跟着变,想真隔离得自己new ArrayList<>(list)
synchronizedList只是给方法加锁
遍历它的时候仍然要手动synchronized (list) { },否则照样抛并发修改异常
方法名和Collection差一个 s,import 时看错行
IDE 里两个一起 import 会看到两条长得几乎一样的
💡 补充几个容易忽略的:
初始化集合直接给容量
new ArrayList<>(100)比让它自己扩 10 次强,省的是一连串数组拷贝
HashMap 的容量也可以预估
默认负载因子 0.75,要放 1000 个元素,初始容量给1334左右刚好不触发扩容
不要用Vector和Hashtable写新代码
它们是 JDK 1.0 的遗产,全表锁的性能代价在并发下完全没必要付
需要线程安全的集合直接上java.util.concurrent里的
ConcurrentHashMap、CopyOnWriteArrayList、ConcurrentLinkedQueue
集合的遍历顺序是有业务含义的
要按插入顺序用LinkedHashMap,要按排序用TreeMap,别指望HashMap的顺序稳定
集合里的对象要考虑序列化
ArrayList能存可序列化的元素,存了不可序列化的对象,缓存或 RPC 时会炸
学框架之前先把集合和泛型吃透
Java 泛型笔记里那套Map<K, V>的读写权限规则,在 MyBatis 的返回值里天天用
🔥 一句话总结:集合框架三条线——
List有序可重复、Set无序不重复、Map键值对且不继承Collection;底层选型记住ArrayList数组 1.5 倍扩、LinkedList双向链表、HashMap数组加链表加红黑树(16 容量、0.75 负载、8 和 64 双条件才树化);两个必踩的坑是remove(int)删下标remove(Object)删值、遍历时改结构抛ConcurrentModificationException;自定义对象进Set或当Map的 key,equals和hashCode必须一起重写。