
0
0
0
05-异步、正则表达式
生成器和协程和正则表达式
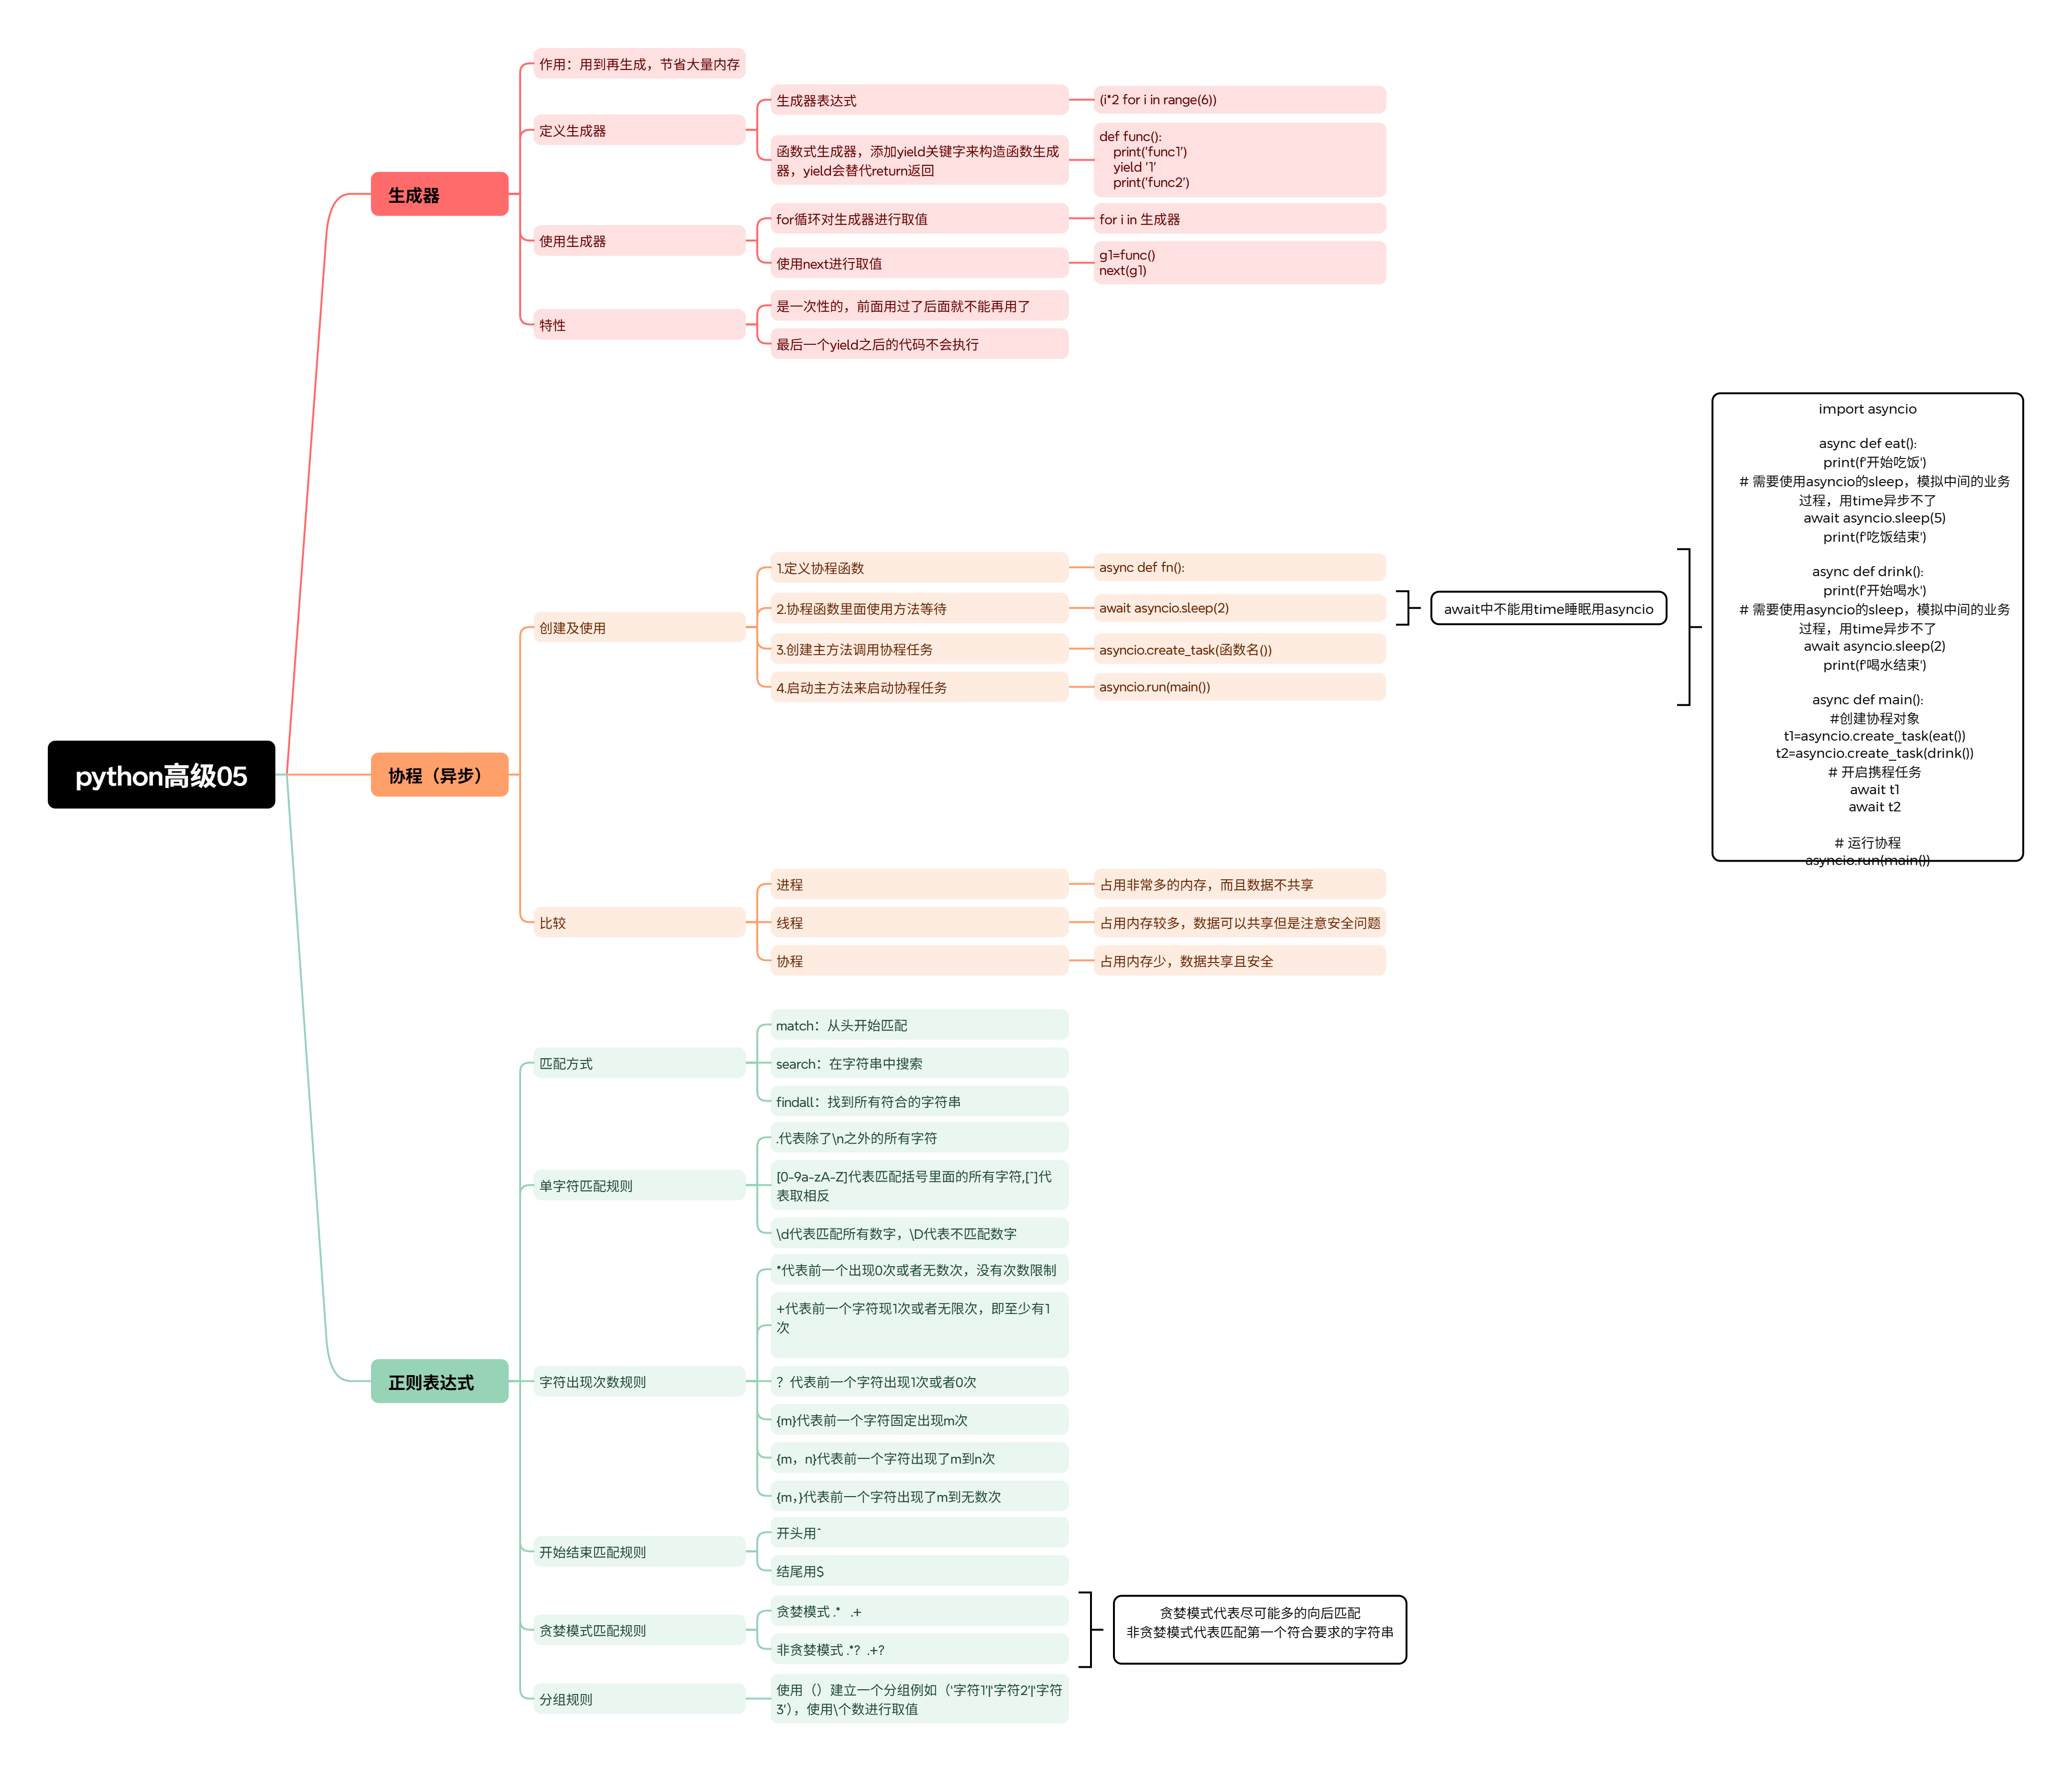
思维导图
推导式(回顾)
l1 = [i*2 for i in range(10)]
s1 = {i*2 for i in range(10)}
d1 = {i:i*2 for i in range(10)}
直接得到的结果的,会占用内存
生成器
创建生成器
gennerator = (i*2 for i in range(10))
不会直接得到结果,不会占用内存

使用next调用生成器(10-2=8,剩余8次)
next(gennerator)
next(gennerator)

使用循环调用生成器(循环8次,因为只剩8次)
for i in generator:
    print(i)

函数生成器:函数内部使用了yield关键字,函数的结果就会变成生成器
def fn():
    print('函数开始...')
    print('函数结束...')
    yield 1
     print('函数开始...')
    print('函数结束...')
    yield 2
    print('函数开始...')
    print('函数结束...')
    yield 3
    print('函数开始...')
    print('函数结束...')
    yield 4
generator = fn()
next(generator) #1
next(generator) #2
next(generator) #3
next(generator) #4
可以将函数的内容分开执行
协程
原理是基于生成器实现的
注意点:
1.async用于标记异步函数
2.await用于标记可等待的函数
3.async和await是需要搭配使用的
4.taks1 = asyncio.create_task(异步函数())
5.需要再统一的入口函数进行任务的并发 await task1
6.asyncio.run(统一入口函数())


1.协程主要是用于处理不需要占用CPU的任务
2.懂得如何使用三方包
2.1 client = httpx.AsyncClient()
2.2 res =  await client.get('http://接口地址...')
2.3 res.json()...
网络请求的使用
httpx用于实现网络请求
#百度图片爬虫-----------------------------------------------------------------------
import time

import httpx
client = httpx.Client()
# 1.输入获取图片的关键字
word = input('请输入你要获取的图片')
# 2.获取可以下载图片的集合信息(多张图片的信息)
info = client.get(
    url=f'https://image.baidu.com/search/acjson?tn=resultjson_com&word={word}&ie=utf-8&fp=result&fr=&ala=0&applid=8932294420318369399&pn=90&rn=30&nojc=0&gsm=5a&newReq=1',
    # 因为百度有防爬机制,不是随便调接口就能访问的,需要模拟浏览器的行为进行调用
    headers={
        'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36',
        'Accept': 'application/json, text/plain, */*',
        'Accept-Language': 'zh-CN,zh;q=0.9,en;q=0.8',
        'Referer': 'https://image.baidu.com/',
        'Connection': 'keep-alive',
    }
)
# print(info.json()) #保留字典格式
# print(info.text)# 把内容转成文字
# print(image.content)  # 图片的内容
# print(f"图片有{len(info.json()['data']['images'])}张") #有了30张图片
for i in info.json()['data']['images'][:10]:
    # print(i['thumburl']) #图片地址
    # 通过调用图片地址接口获取图片
    image = client.get(i['thumburl'])
    # print(image.content) #图片的内容
    # 创建文件,写入图片内容
    with open(file=f"files/{time.time()}.jpg",mode="wb") as f:
        f.write(image.content)
# 总结:
# 1.找获取图片的url(百度)
# 2.创建请求客户端
# 3.调用url(关键字可以修改)
# 4.获取到的是图片信息的集合(res.json()['data']['images'])
# 5.循环这个列表,获取每一张图片的url i['thumburl']
# 6.调用图片url接口,获取图片信息(res.content()图片内容)
# 7.创建文件,写入信息
#搜索图片爬虫-----------------------------------------------------------------------
# 1.获取下载图片的url
# 2.调用url获取图片信息集合
# 3.遍历信息集合,找到每一张图片的url
# 4.调用图片url获取图片内容
# 5.保存图片
import time
import httpx
word = input('输入搜索的内容')
client = httpx.Client()
res = client.get(
    url=f'https://pic.sogou.com/napi/pc/searchList?mode=1&start=48&xml_len=48&query={word}&channel=pc_pic&scene=pic_result',
    headers={
        'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36',
        'Accept': 'application/json, text/plain, */*',
        'Accept-Language': 'zh-CN,zh;q=0.9,en;q=0.8',
        'Referer': 'https://image.baidu.com/',
        'Connection': 'keep-alive',
        'x-time4p':str(int(time.time()*1000))
    }
)
print(len(res.json()['data']['items']))
for i in res.json()['data']['items']:
    image = client.get(i['thumbUrl'])
    with open(file=f"files/{time.time()}.jpg",mode="wb") as f:
        f.write(image.content)
# 爬虫 - 静态资源/动态接口
# 1.找到资源连接(网址)
# 2.调接口获取网页内容(text)
# 3.通过正则获取网页内容图片的连接
# 4.网络请求调用图片链接获取图片内容
# 5.保存内容到图片文件
import re
import httpx
client = httpx.Client()
# res就是网页的内容
res = client.get(url='https://www.tsinghua.edu.cn/')
img_list = re.findall(r'<img.*src="(.*?)".*>',res.text)
print(img_list) #所有src的列表,里面有无效的地址,所以需要筛选
for i in img_list:
    if re.search(r"(jpg|png|gif)",i):
        # 有效图片,就下载图片
        # 央视网:+http:是因为央视网的图片地址没有http:
        # 清华网:+https://www.tsinghua.edu.cn/:是因为央视网的图片地址没有http:
        img = client.get('https://www.tsinghua.edu.cn/'+i)
        # i.split('/')[-1]取出链接里面最后一个名字
        with open(file=f"files/{i.split('/')[-1]}",mode="wb") as f:
            f.write(img.content)
# 1.找一个网址(老一点网页)
# 2.通过调用接口,获取网页内容
# 3.通过正则获取图片的链接
# 4.通过接口获取图片内容
# 5.写入文件
爬虫
1.动态接口爬虫(接口)
1.1 - F12在网页查看请求接口(请求地址)
1.2 - 查看请求类型(get)
1.3 - 查看请求头(模拟浏览器传递信息)
2.静态页面爬虫(正则)
1.1 - 找一个静态网页(老一点的)
1.2 - 通过地址请求网页获取内容
1.3 - 使用正则findall查找图片链接
1.4 - 调用图片链接获取图片内容进行保存
正则表达式
匹配方式:
1.match - 从头匹配
2.search - 是否包含
3.findall - 是否包含,返回列表


单个匹配:
. 任意字符(不包含\n)
[0-9a-zA-Z] 匹配集合内的内容
\d 数字


多个匹配:
* 任意次数
+ 至少一次
? 0或1次
{5}  固定次数
{3,5}  3-5次
{5,}   至少5次

开头结尾匹配:
f'^正则表达式$'

贪婪与非贪婪:
贪婪:尽可能多的匹配 .*   .+
非贪婪:尽可能少的匹配  .*?  .+?

分组:

|  或者  (qq|sina|163)
<(h1)><\1>  ()表示分组  \1表示使用组(1是第一个分组的意思)

拓展:findall查找的时候,如果查找的是组,直接查找组的内容

content_test = '<img class="lazy" src="//p2.img.cctvpic.com/photoAlbum/page/performance/img/2026/6/20/1781930258479_596.jpg" data-src="//p2.img.cctvpic.com/photoAlbum/page/performance/img/2026/6/20/1781930258479_596.jpg" width="100%">'


r1 = re.findall(r'^<img.*src="(.*)".*>$', content)  # 第一个多贪,第二个少贪
第一个.*贪到的内容: class="lazy" src="//p2.img.cctvpic.com/photoAlbum/page/performance/img/2026/6/20/1781930258479_596.jpg" data-
第二个.*贪到的内容:src="//p2.img.cctvpic.com/photoAlbum/page/performance/img/2026/6/20/1781930258479_596.jpg" width="100%"
第三个.*贪到的内容:

r2 = re.findall(r'^<img.*?src="(.*?)".*>$')# 第一个少贪,第二个多贪
第一个.*贪到的内容: class="lazy"
第二个贪到的内容://p2.img.cctvpic.com/photoAlbum/page/performance/img/2026/6/20/1781930258479_596.jpg
第三个贪到的内容: data-src="//p2.img.cctvpic.com/photoAlbum/page/performance/img/2026/6/20/1781930258479_596.jpg" width="100%"