Java IO 笔记:File 类、字符编码与流体系
📝 笔记摘要:Java IO,从文件句柄到流体系
Java 的 IO 从 JDK 1.1 用到现在,API 旧,但坑的位置一直没挪过:File 只管路径和元数据,内容得靠流一格一格搬;字节流不认编码,字符流才管编码;流不关,文件句柄就漏在那儿。
这篇按 File → 字符编码 → 流体系 → 高级流 → 框架的顺序走一遍,每个点都是四步:它是什么、语法长什么样、代码怎么写、容易踩哪。Java 基础篇第 22 节里提过一句「老 API 是 File 配 FileInputStream,新 API 是 java.nio.file」,那是入门视角,这里把老 API 整套摊开讲清楚。
上篇 File 与流的基础
1. File 与 IO 流的分工 2. File 类的使用
3. UTF-8 字符编解码 4. IO 流总览
5. 字节输入流(InputStream) 6. 字节输出流(OutputStream)
7. 文件拷贝 8. 管道的关闭
下篇 高级流与框架
9. 字符流 10. 缓冲流
11. 转换流 12. 打印流
13. 数据流 14. 序列化
15. IO 框架
1. File 与 IO 流的分工
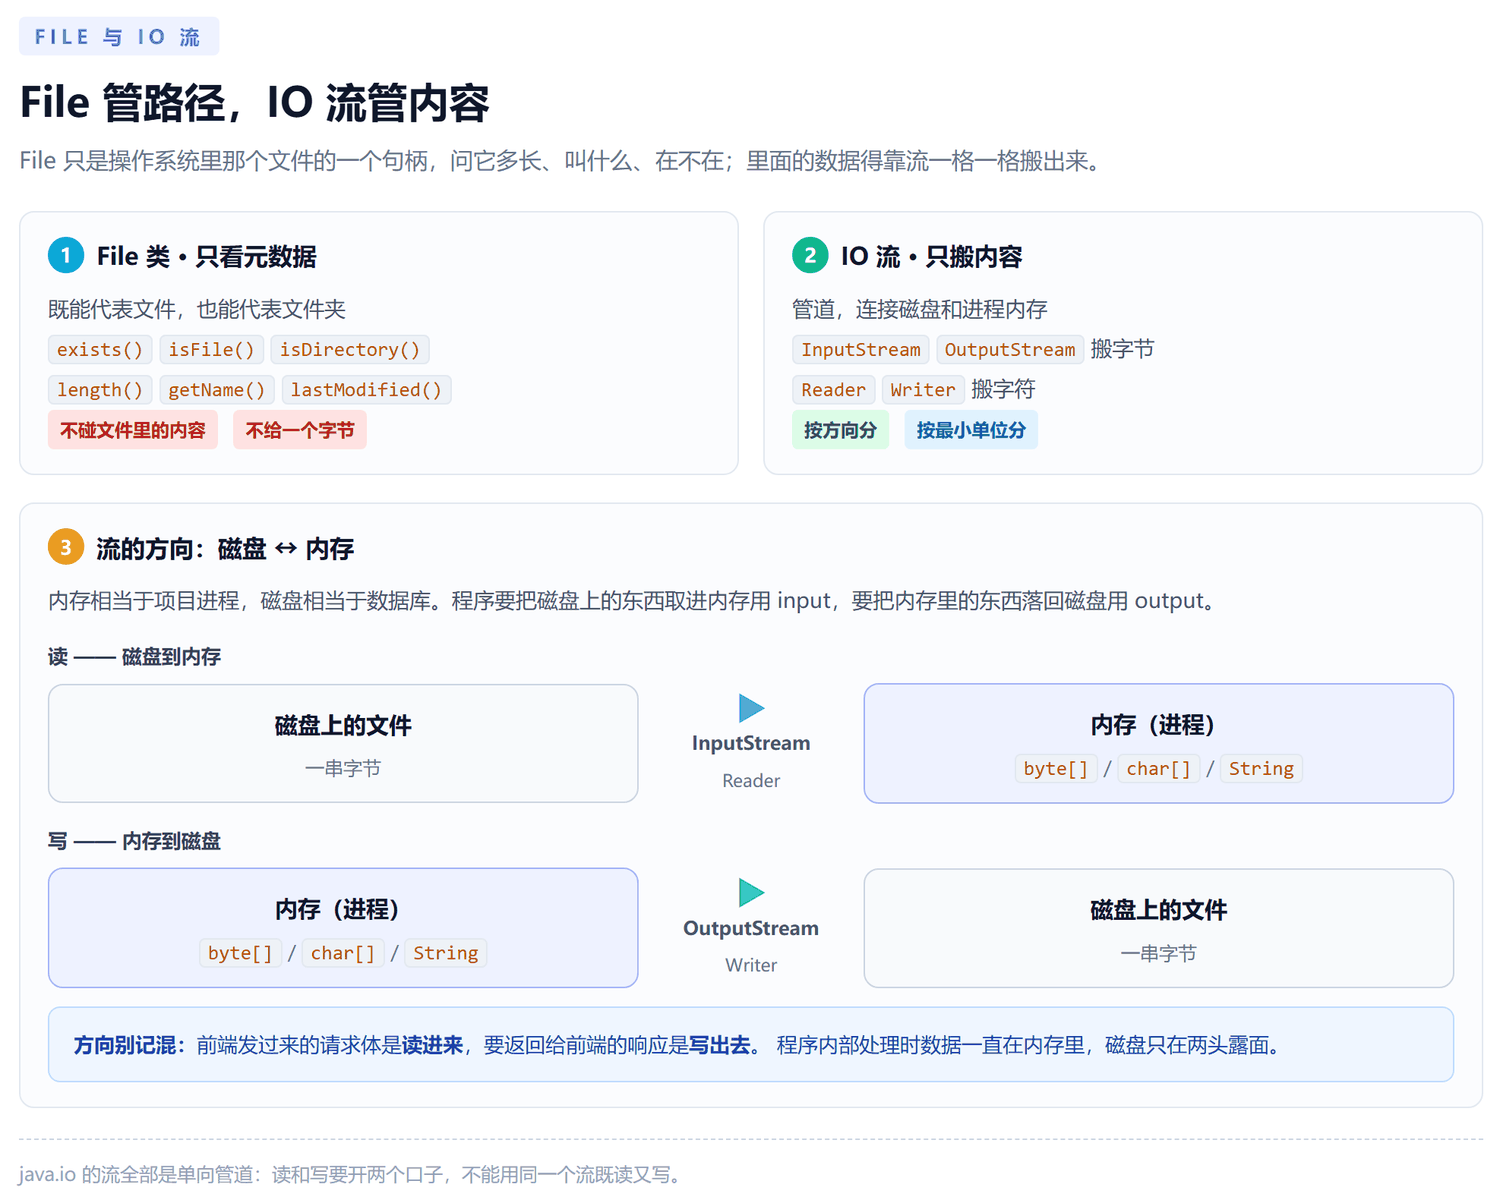
File 代表操作系统内的文件,IO 流是用来读取这些文件的。File 既可以代表文件,又可以代表文件夹;File 只能获取文件的信息,不能对文件里面的数据进行操作,要操作文件里面的数据需要用到 IO 流。
记成一句话:File 代表文件,IO 流代表内容。
File 不是流
new File(...)只是造了个路径的句柄,它不占文件句柄,也不读一个字节
没有流就动不了内容
想看文件里有什么,得开FileInputStream或者FileReader
File 不检查路径存不存在
new File("a.txt")造出来的东西,文件在不在要问exists()
它代表文件还是文件夹,构造时不知道
得靠isFile()和isDirectory()去问操作系统
2. File 类的使用
File 有两种用法:拿它当路径用(造对象、问信息、创建删除),或者当参数喂给流(new FileInputStream(file))。
2.1 创建 File 对象
三种写法拿到的都是同一个文件,区别只在路径怎么拼。
public static void main(String[] args) {
    /*
     * 三种写法都可以,用双斜杠或者反斜杠来表示文件路径,第三种可以换用File.separator来表示,可以跨系统自动获取分割符
     * */
    File file = new File("C:\\data\\images\\001.png");
    File file01 = new File("C:/data/images/001.png");
    File file02 = new File("C:" + File.separator + "data" + File.separator + "images" + File.separator + "001.png");
    System.out.println("文件是否存在" + file02.exists());
    System.out.println("文件大小" + file02.length());

    /*
     * 获取文件夹信息
     * */
    File files = new File("C:\\data\\images");
    System.out.println("文件夹是否存在" + files.exists());
    System.out.println("文件夹本身大小,不包含文件夹内容的大小" + files.length());

    /*
     * 相对文件路径获取文件,默认在根目录下面
     * */
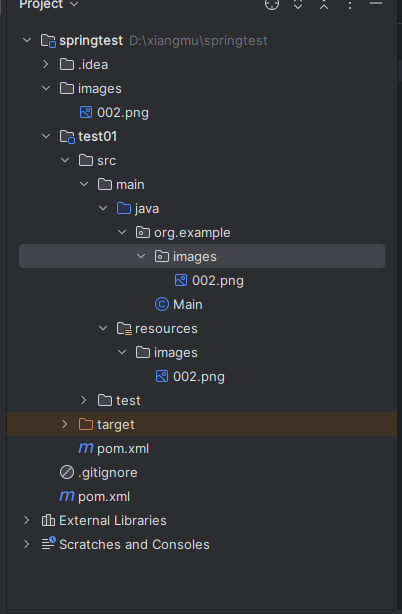
    File filepath = new File("images/002.png");
    System.out.println("文件是否存在" + filepath.exists());
    System.out.println("文件大小" + filepath.length());

    /*
     * 相对文件路径获取文件,需要加上模块的名称
     * */
    File filepath01 = new File("test01/src/main/resources/images/002.png");
    System.out.println("文件是否存在" + filepath01.exists());
    System.out.println("文件大小" + filepath01.length());
}
三个构造方法,父路径和子路径分开拼的那两个在遍历目录时最省事:
//通过将给定的路径名字符串转换为抽象路径名来创建新的File实例
public File(String pathname)
//从父路径名字符串和子路径名字符串创建新的 File实例
public File(String parent, String child)
//从父抽象路径名和子路径名字符串创建新的 File实例
public File(File parent, String child)
文件目录结构如下:
2.2 File 对象的常见方法
判断和查询这一组用得最多。
public static void main(String[] args) {
    /*
     * 相对文件路径获取文件,需要加上模块的名称
     * */
    File filepath01 = new File("test01/src/main/java/org/example/images/002.png");
    System.out.println("文件是否存在" + filepath01.exists());
    System.out.println("是否为文件" + filepath01.isFile());
    System.out.println("是否为文件夹" + filepath01.isDirectory());
    System.out.println("文件大小" + filepath01.length());
    System.out.println("文件名称" + filepath01.getName());
    System.out.println("文件最后修改日期" + filepath01.lastModified());
    System.out.println("文件路径(与传入的路径相同)" + filepath01.getPath());
    System.out.println("文件绝对路径" + filepath01.getAbsolutePath());
}
File 的完整方法清单,抄一份备查:
// 判断文件是否可执行
public boolean canExecute()
// 判断文件是否可阅读
public boolean canRead()
// 判断文件是否可写入
public boolean canWrite()
//创建一个空文件
public boolean createNewFile()
//删除此文件
public boolean delete()
//程序结束删除此文件
public void deleteOnExit()
//判断文件或者文件夹是否存在
public boolean exists()
//获取给定抽象路径名的绝对File对象
public File getAbsoluteFile()
//获取File的绝对路径
public String getAbsolutePath()
//获取File的正确绝对路径文件
public File getCanonicalFile()
//获取File的正确绝对路径
public String getCanonicalPath()
//转成url格式
public URI toURI()
//文件或目录的名称
public String getName()
//获取父文件的路径
public String getParent()
//获取父文件
public File getParentFile()
//文件的路径
public String getPath()
//抽象路径名是否是绝对的
public boolean isAbsolute()
//是否是个目录
public boolean isDirectory()
//是否是文件
public boolean isFile()
//文件是否隐藏
public boolean isHidden()
//文件上次修改的时间
public long lastModified()
//文件的长度
public long length()
//重命名文件或目录
public boolean renameTo(File dest)
//设置文件或目录的最后修改时间
public boolean setLastModified(long time)
//设置成只读
public boolean setReadOnly()
//转成Path对象
public Path toPath()
//比较当前File对象与指定的File对象的路径名。如果当前File对象的路径名字典序在指定的File对象的路径名之前,则返回一个负整数。如果当前File对象的路径名字典序在指定的File对象的路径名之后,则返回一个正整数。如果当前File对象的路径名与指定的File对象的路径名相同,则返回0。
public int compareTo(File pathname)
//创建目录
public boolean mkdir()
public boolean mkdirs()
//目录下所有文件和目录的文件名
public String[] list()
public String[] list(FilenameFilter filter)
//目录下所有文件和目录的绝对路径
public File[] listFiles()
public File[] listFiles(FilenameFilter filter)
public File[] listFiles(FileFilter filter)
getPath 和 getAbsolutePath 不是一回事
getPath()原样返回你传进去的那个字符串,传相对路径它就返回相对路径
getAbsolutePath()拿当前工作目录拼一遍,它不做任何规范化
要真正干净的绝对路径用 getCanonicalPath
它会把.、..这些消掉,还能解析软链接和大小写
length() 对文件夹基本没意义
Windows 上文件夹的length()恒为 0,不包含里面文件的大小
lastModified 返回的是毫秒时间戳
要看得懂就套一层new Date(ts)
删除走 delete,别用 deleteOnExit
deleteOnExit()挂在 JVM 退出钩子上,程序被杀就漏
2.3 File 创建文件、删除文件
public static void main(String[] args) throws IOException {
    /*
     * 在指定位置创建文件
     * */
    File filepath01 = new File("test01/src/main/java/org/example/images/003.png");
    filepath01.createNewFile();//创建指定路径下的文件,需要抛出异常,成功返回True,失败返回false
    /*
     * 在指定位置创建文件夹
     * */
    File filepath02 = new File("test01/src/main/java/org/example/images/images01");
    filepath02.mkdir();//只能创建一级文件夹,请确保上级文件夹存在,成功返回True,失败返回false
    filepath02.mkdirs();//能创建多级文件夹,成功返回True,失败返回false
    filepath02.delete();//删除指定文件或者文件夹,需要确保文件夹下面没有文件,成功返回True,失败返回false
}
三个方法的返回值别忽略
全都不抛异常,失败就返回 false:磁盘满、没权限、路径是文件、文件夹非空
createNewFile()唯一的例外是父目录不存在,它抛 IOException
mkdir 和 mkdirs 的区别是「建几级」
mkdir()只建一级,父目录不存在直接失败
mkdirs()把缺的都补上,已经存在也返回 false
delete 删不掉非空文件夹
实测目录里有文件时delete()返回false,不抛异常也不删
递归删得自己先listFiles()再逐个删,或者用FileUtils.deleteDirectory()
删除前先确认 exists()
路径写错的时候delete()返回false,和「删不掉」长得一模一样
2.4 File 文件夹递归
list() 和 listFiles() 只遍历一级,前者给文件名,后者给 File 对象。
public static void main(String[] args) {
    /*
     * 遍历文件夹
     * */
    File filepath01 = new File("C:\\data\\images");
    String[] list = filepath01.list();//此方法只遍历一级文件目录
    for (String s : list) {
        System.out.println("遍历文件名称:" + s);
    }
    System.out.println("---------------------------");
    File[] files = filepath01.listFiles();//可以获得文件对象,一遍获得下一级文件
    for (File file : files) {
        System.out.println("遍历文件名称:" + file.getName());
    }
}
多级目录要自己递归,这个写法适用于文件搜索之类的场景:
public class FileSearch {
    public static void main(String[] args) {
        Map<String, String> resultMap = new HashMap<>();
        getFileMap(resultMap, "11", new File("C:\\data\\images"));
        System.out.println(resultMap.toString());
    }

    private static void getFileMap(Map<String, String> resultMap, String FileName, File file) {
        //如果传入的file文件有问题则跳出
        if (!file.exists() || file.length() <= 0) {
            return;
        }
        //否则去除这个文件夹下所有的内容
        File[] files = file.listFiles();
        if (files == null) {
            return;
        }
        //循环取值
        for (File file1 : files) {
            //判断是否是文件
            if (file1.isFile()) {
                //判断文件名是否包含FileName
                if (file1.getName().contains(FileName)) {
                    //如果包含就添加到map中
                    resultMap.put(file1.getName(), file1.getAbsolutePath());
                }
            } else {
                //否则就递归调用
                getFileMap(resultMap, FileName, file1);
            }
        }
    }
}
list() 和 listFiles() 会返回 null
路径不是目录、或者没权限,返回的是 null 不是空数组,直接 for 循环就 NPE
实测对一个普通文件调list(),拿到的就是null
递归里那个 length() 判断是错的
文件夹在 Windows 上length()恒为 0,所以非空目录会被这一行直接挡掉
要判空用listFiles() == null,判目录用isDirectory()
软链接会无限递归
目录里有指向自己的软链接,递归就停不下来,深度限制得自己加
要按条件筛,listFiles 带过滤器更省事
listFiles((dir, name) -> name.endsWith(".txt")),不用自己 if
新 API 一行搞定
Files.walk(path)直接返回所有层级的路径流,自带软链接检测
3. UTF-8 字符编解码
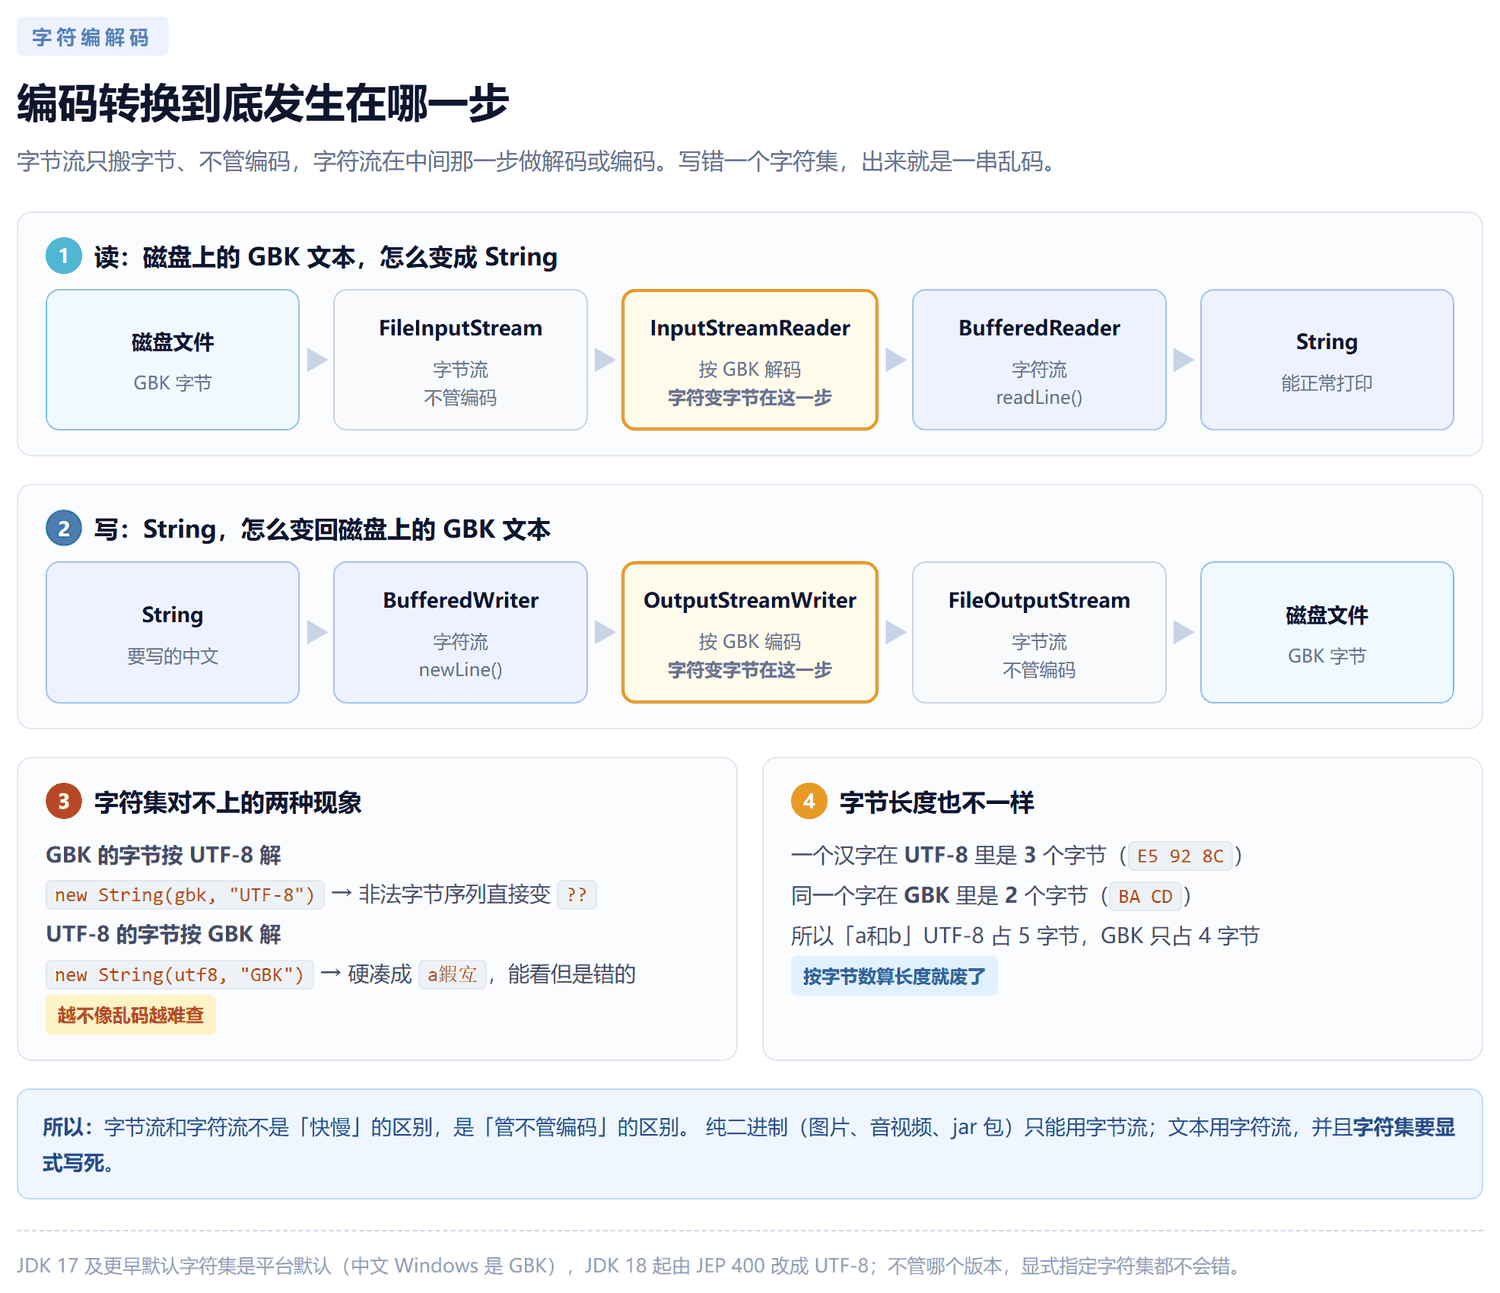
字符在内存里是 char,落盘是字节。编码就是把字符变成字节,解码就是把字节变回字符,两边用的字符集必须一致,不一致就是乱码。
public class Byte {
    public static void main(String[] args) throws UnsupportedEncodingException {
        String a = "a和b";
        /*
         * 字符串编码
         * */
        byte[] bytes = a.getBytes("UTF-8");//指定字符集,英文 1 个字节,汉字 3 个字节,一共五个字节 [97, -27, -110, -116, 98]
        System.out.println(Arrays.toString(bytes));
        byte[] gbks = a.getBytes("GBK");//指定字符集,GBK 里汉字是两个字节,一共四个字节 [97, -70, -51, 98]
        System.out.println(Arrays.toString(gbks));
        /*
         * 字符串解码
         * */
        String s = new String(bytes, "UTF-8");//指定字符集,输出 'a和b'
        System.out.println(s);
        String s1 = new String(gbks, "GBK");//指定字符集,输出 'a和b'
        System.out.println(s1);
        //混用出现错误
        String s2 = new String(gbks, "UTF-8");//a??b
        System.out.println(s2);
        String s3 = new String(bytes, "GBK");//a鍜宐
        System.out.println(s3);
    }
}
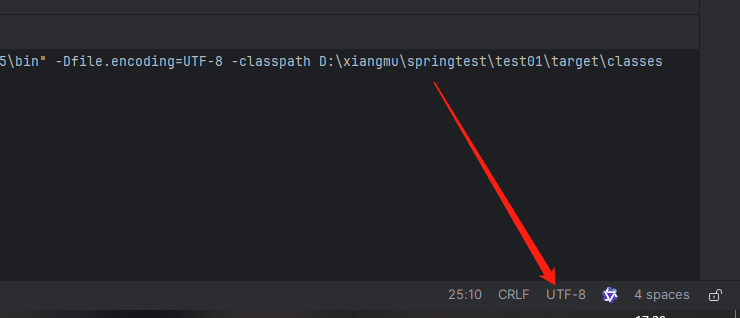
在 IDEA 编译器中可以在右下角看到文本的字符集编码:
同一个字,字节数不一样
「和」在 UTF-8 里是 3 个字节(E5 92 8C),在 GBK 里是 2 个字节(BA CD)
所以「a和b」UTF-8 占 5 个字节,GBK 只占 4 个,按字节数算字符串长度就废了
不写字符集,默认是哪个不确定
JDK 18 起由 JEP 400 改成 UTF-8,JDK 17 及更早是平台默认,中文 Windows 上是 GBK
同一份代码换台机器结果就变,永远显式写字符集
混用有两种乱码,一种好认一种难认
GBK 字节按 UTF-8 解:非法字节序列直接变??,一眼看出坏了
UTF-8 字节按 GBK 解:a鍜宐,能显示但是错的,最难查
源码和文件是两套编码
源码是javac -encoding定的,文件是getBytes定的,两边要分别配
用 StandardCharsets 别用字符串
Charset.forName("UTF-8")写错一个字母,运行时才抛异常
StandardCharsets.UTF_8编译期就定死,写不错
4. IO 流总览
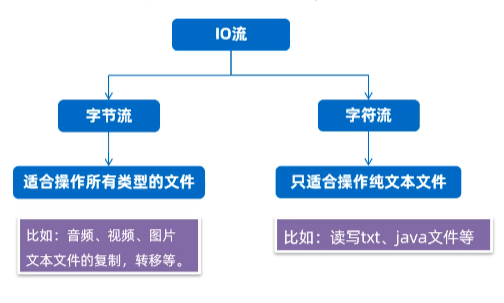
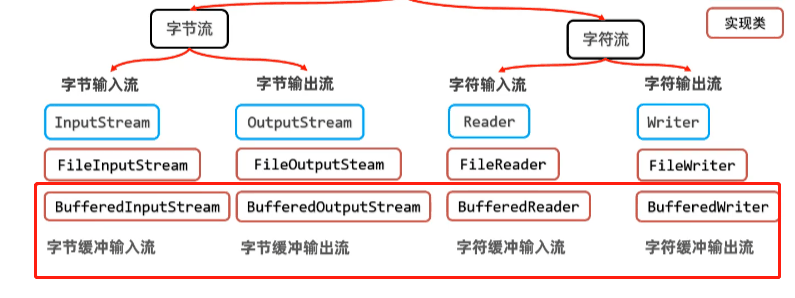
IO 流有两个分类维度,交叉起来才是完整的体系。
按照方向,分为输入流和输出流:
按照最小单位,分为字节流、字符流;字节流是和操作所有类型的文件包括音视频、图片,字符流适合操作文本文件。
四类流各管一段:
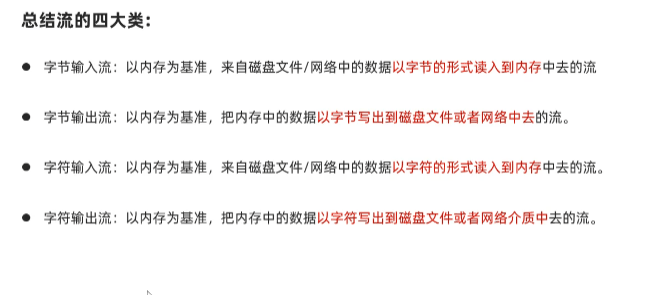
内存相当于是项目进程,磁盘相当于是数据库,所以程序接收(前端发过来的,硬盘中拿到的)用 input,程序写入(写到硬盘里的,返回给前端的)用 output。
字节流和字符流的分界是「管不管编码」
字节流一个字节一个字节搬,它不知道 97 是 ASCII 的 a 还是别的什么
字符流按字符集解码,所以它必须知道字符集是谁
纯二进制只能用字节流
图片、音视频、jar 包、Protobuf,用字符流会被解码坏掉
字节流不是不能读文本
能读,但读出来的是字节不是字符,汉字会被拆开,必须自己处理边界
流是单向的
同一个流不能又读又写,读用 InputStream,写用 OutputStream
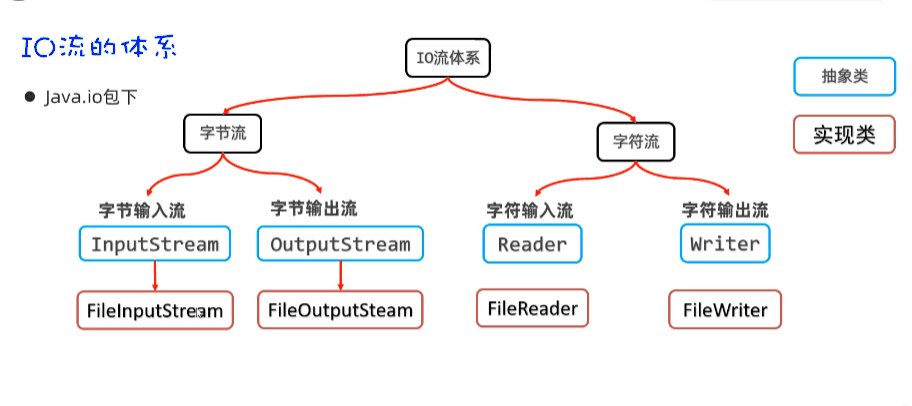
整条继承链在 java.io 包里
InputStream → OutputStream → Reader → Writer 四个是根,剩下的全是它们的实现
5. 字节输入流(InputStream)
FileInputStream 负责从文件里取字节。它有两个构造方式,传路径字符串或者传 File 对象都行。
5.1 用 read 读单个字节
使用 read 方法读取性能很差,因为每次都向硬盘拿字节,要是文件很大就需要拿几万次甚至更多,并且汉字会乱码。
public class FileInputStreamClass {
    public static void main(String[] args) throws IOException {
        //根据文件路径创建FileInputStream对象,也可以根据File对象创建管道
        FileInputStream fileInputStream = new FileInputStream("test01/src/main/java/org/example/images/002.png");
        File file = new File("test01/src/main/java/org/example/images/002.png");
        FileInputStream fileInputStreamOne = new FileInputStream(file);
        int readOne = fileInputStreamOne.read();//获取第一个字节
        System.out.println("第一个字节" + readOne);
        int readTwo = fileInputStreamOne.read();//获取第二个字节
        System.out.println("第二个字节" + readTwo);
        /*
         * 是一种流水模型,每次read就会往后读一个字节,当所有字节都读完了就会返回-1,所以可以循环打印直到最后一个字节
         * */
        int a;
        List<Integer> list = new ArrayList();
        /*
         * 注意不要出现多次.read()否则统计的不准确,因为每次read都会往后读一个字节,以下为错误写法
         *
         *   while(true){
         *       System.out.println(fileInputStreamOne.read());
         *       if (-1==fileInputStreamOne.read()){
         *       break;
         *       }
         *   }
         *
         * 使用read方法读取性能很差,因为每次都向硬盘拿字节,要是文件很大就需要拿几万次甚至更多,并且汉字会乱码
         *
         *
         * */
        //从第三个字节开始
        while (true) {
            a = fileInputStreamOne.read();
            list.add(a);
            System.out.println(a);
            if (-1 == a) {
                break;
            }
        }
        System.out.println("文件File的大小为:" + file.length() + ";统计的大小为:" + list.size());
        //使用完成后必须释放系统资源
        fileInputStream.close();
    }
}
read() 返回的是 int 不是 byte
返回 0 到 255,末尾统一返回 -1
用byte接就装不下 -1,得用 int
那个统计出来的数比文件大 1
循环里list.add(a)在判断之前,结尾那个 -1 也被统计进去了
实测 93926 字节的文件,list.size()是 93927,把-1排除掉才等于文件大小
错误写法为什么错
注释里那段read()调了两次,一次打印一次判断,指针多走一格
结果就是每隔一个字节被跳掉,而且判断到的永远是隔一个的值
读单个字节就是单字节 IO
大文件几万个系统调用,慢得离谱,还得自己处理汉字被截断的问题
5.2 用 read 读多个字节
解决了多次读取磁盘的问题,但是解决不了汉字乱码的问题,若果只是进行文件的拷贝,则没有影响。
public class FileInputStreamMoreReadClass {
    public static void main(String[] args) throws IOException {
        //根据文件路径创建FileInputStream对象,也可以根据File对象创建管道
        FileInputStream fileInputStream = new FileInputStream("test01/src/main/java/org/example/images/002.png");
        File file = new File("test01/src/main/java/org/example/images/test.txt");
        FileInputStream fileInputStreamOne = new FileInputStream(file);//文件内容为字符串zxcasdqwe
        byte[] aByte = new byte[5];//先创建有个字节大小的桶,平时代码中可以看见类似于byte[] aByte = new byte[1024]
        int readOne = fileInputStreamOne.read(aByte);//获取第一桶字节
        System.out.println("第一个桶字节大小为" + readOne + ";内容为:" + new String(aByte));//第一个桶字节大小为5;内容为:zxcas
        int readTwo = fileInputStreamOne.read(aByte);//获取第二桶字节
        System.out.println("第二个桶字节大小为" + readTwo + ";内容为:" + new String(aByte));//第二个桶字节大小为4;内容为:dqwes,最后剩余四个,但是桶的大小是5最后一个就有问题,没东西覆盖
        System.out.println("第二个桶字节大小为" + readTwo + ";内容为:" + new String(aByte).substring(0, readTwo));//第二个桶字节大小为4;内容为:dqwe
        int readThr = fileInputStreamOne.read(aByte);//获取第三桶字节
        System.out.println("第三个桶字节大小为" + readThr + ";内容为:" + new String(aByte));//第三个桶字节大小为-1;内容为:dqwes;大小为-1说明弄完了
        //使用完成后必须释放系统资源
        fileInputStream.close();
    }
}
使用循环的进阶版本:
public class FileInputStreamMoreForEachClass {
    public static void main(String[] args) throws IOException {
        //根据文件路径创建FileInputStream对象,也可以根据File对象创建管道
        FileInputStream fileInputStream = new FileInputStream("test01/src/main/java/org/example/images/002.png");
        File file = new File("test01/src/main/java/org/example/images/002.png");
        FileInputStream fileInputStreamOne = new FileInputStream(file);
        byte[] buffer = new byte[1024];
        int a;
        while (true) {
            a = fileInputStreamOne.read(buffer);
            System.out.println(a);
            if (-1 == a) {
                break;
            }
        }
        System.out.println("文件File的大小为:" + file.length());
        //使用完成后必须释放系统资源
        fileInputStream.close();
    }
}
桶里没装满的部分是上一次的残留
第一次读 5 个字节「zxcas」,第二次只读到最后 4 个「dqwe」,第 5 个位置还留着上次的 s
所以new String(aByte)出来是「dqwes」,必须用substring(0, readTwo)截断
read(byte[]) 返回的是这次真读了多少
不是桶的容量,文件末尾那一桶永远不满
返回 -1 表示读完
第三次读返回 -1,但桶里的内容还是上一次那个,别以为 -1 的桶也是脏的
这个坑在拷贝时最致命
写的时候按read返回的长度写,多写就会在文件尾部糊上一段旧数据
桶大小 1024 是惯例
太小了系统调用多,太大了白占内存还慢,1 KB 到 8 KB 之间最常见
5.3 一次性读取所有字节
此方法的问题是如果内存小于文件大小就不行了,但是可以解决汉字乱码问题,因为一次性把文件读完了。
public static void main(String[] args) throws IOException {
    //根据文件路径创建FileInputStream对象,也可以根据File对象创建管道
    FileInputStream fileInputStream = new FileInputStream("test01/src/main/java/org/example/images/002.png");
    File file = new File("test01/src/main/java/org/example/images/002.txt");
    FileInputStream fileInputStreamOne = new FileInputStream(file);//文件内容为字符串zxcasdqwe
    byte[] aByte = new byte[(int) file.length()];//根据文件的大小设置桶的大小
    byte[] bytes = fileInputStreamOne.readAllBytes();//现成方法设置桶的大小
    int readOne = fileInputStreamOne.read(aByte);//获取第一桶字节
    //使用完成后必须释放系统资源
    fileInputStream.close();
}
readAllBytes 是 JDK 9 才有的
JDK 8 及更早没这方法,只能用read(byte[])自己凑
它返回的是整个文件,不是读了多少
返回值直接就是字节数组,不用再管桶,也没有残留问题
一次读进内存,大文件会 OOM
文件比堆内存还大直接OutOfMemoryError,流式读才是正解
JDK 9 还给了两个好用的方法
transferTo(OutputStream)直接倒给另一个流,拷贝一行搞定
readNBytes(int)只读指定字节数,读文件头几个字节用它
按文件大小开桶也不保险
new byte[(int) file.length()]假设了文件大小不变,读的过程中被追加了就截断
6. 字节输出流(OutputStream)
FileOutputStream 负责往文件里写字节,构造的时候指定写到哪个路径。
public static void main(String[] args) throws IOException {
    //创建一个文章输出管道,输出到指定位置。
    FileOutputStream fileOutputStream = new FileOutputStream("test01/src/main/java/org/example/images/output.txt");
    //使用write方法将指定的字节输出到文件中,首先可以写入单个字节
    fileOutputStream.write(97);//把97字节输出到文件里,97对应的是小写a
    fileOutputStream.write('b');//b代表的int类型是98
    //可以写入一个字节数组
    byte[] bytes = "这是一个测试字符串zxcasdqwe".getBytes();//把一个字符串转换成字节数组
    fileOutputStream.write(bytes);
    //可以自定义截取数组的长度
    fileOutputStream.write(bytes, 0, bytes.length - 9);
    /*
     * 最终文件内容是 'ab这是一个测试字符串zxcasdqwe这是一个测试字符串'
     * */
    //每次运行的时候都会把文件覆盖写入,如果想在后面进行追加的话,可以换参数控制,创建一个追加管道
    FileOutputStream fileOutputStreamOne = new FileOutputStream("test01/src/main/java/org/example/images/output.txt", true);
    byte[] bytes1 = "\r\n".getBytes();//实现文件换行
    fileOutputStreamOne.write(bytes1);
    fileOutputStreamOne.write(bytes);
}
截取长度算的是字节不是字符
「这是一个测试字符串zxcasdqwe」在 UTF-8 下是 36 字节,不是 17 个字符
bytes.length - 9剩下 27 字节,正好是 9 个汉字,所以结果是「这是一个测试字符串」
拿字符串的length()去算截断位置,汉字会被切坏
默认是覆盖,不是追加
第二个参数传true才追加,不传就把文件清空重写
日志、配置这类要追加的场景,忘了传 true 就只剩最后一次
write(int) 写的是低 8 位
write(97)写进去是一个字节 97,不是 97 这个字符串
换行符分平台
Windows 认\r\n,Linux 认\n,要跨平台用System.lineSeparator()
字符流有 write(String),字节流没有
FileOutputStream只能写字节,想直接写字符串得先getBytes()
7. 文件拷贝
拷贝是字节流最典型的用法,一个读一个写,循环搬运。
public static void main(String[] args) throws IOException {
    //根据文件路径创建FileInputStream对象,也可以根据File对象创建管道
    File file = new File("test01/src/main/java/org/example/images/002.png");
    File fileOne = new File("test01/src/main/java/org/example/images/copy002.png");
    FileInputStream fileInputStreamOne = new FileInputStream(file);
    FileOutputStream fileOutputStreamOne = new FileOutputStream(fileOne);
    byte[] buffer = new byte[1024];
    int a;
    while (true) {
        a = fileInputStreamOne.read(buffer);
        if (-1 == a) {
            break;
        }
        fileOutputStreamOne.write(buffer, 0, a);
    }
    System.out.println("文件拷贝完成!");
    //使用完成后必须释放系统资源
    fileOutputStreamOne.close();
    fileInputStreamOne.close();
}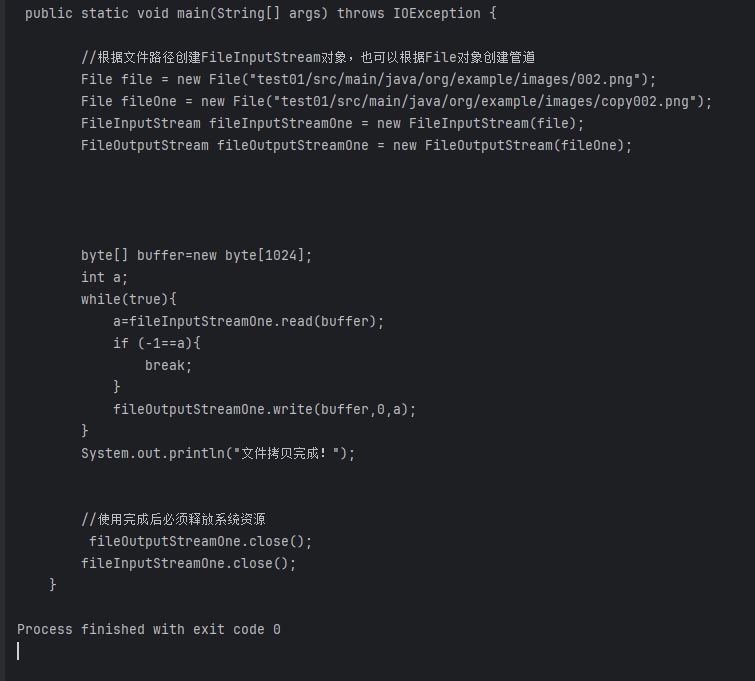
写多少要跟读多少对齐
write(buffer, 0, a)里的a是这次真读到的字节数,不能写成buffer.length
写满了,最后一桶会把旧数据糊到文件尾部,文件大小对不上
JDK 9 有更省事的写法
fileInputStreamOne.transferTo(fileOutputStreamOne)一行搞定,连循环都省了
大文件别整个读进内存
1024 字节一块地搬,一个 10 GB 的文件内存占用也就 1 KB
源和目标别是同一个文件
new FileOutputStream(file)会先把源文件清空,然后才轮到读,文件直接空了
拷贝完比一下大小
file.length()对比目标文件长度,不一致就说明中间断了
服务端收到上传文件之后也是这套流程
完整的接收链路见 Spring Boot 文件上传
8. 管道的关闭
运行完后管道需要关闭,这是就需要把 close 方法写到 finally 之中。
Java 7 之后别再手写 finally
try-with-resources 把流声明写在括号里,用完自动关,抛异常也关
手写 finally 的话,close 自己抛异常会把原来的异常盖掉,排查时看到的是错的那个
没关的流会漏文件句柄
Windows 上句柄有上限,漏多了就报「文件 too many open files」
而且数据可能还在缓冲区里没落盘,close 的时候才 flush
多个流要按相反顺序关
先关包在外面的,try-with-resources 帮你处理这个顺序
System.out 也是个流
调用过System.setOut()之后,原来的标准输出被替换了,关的时候别关错
9. 字符流
读写文本文件时经常使用。字符流的构造方法多一个字符集参数,写文本的时候这个参数是保命的。
9.1 字符输入流(FileReader)
public static void main(String[] args) {
    //根据文件路径创建字符输入流对象
    try (
        FileReader fileReader = new FileReader("test01/src/main/java/org/example/images/file.txt");
    )//写在括号里就不用再finally里面写关闭流了,也不用写关闭管道了
    {
        char[] charBuffer = new char[1024];
        int readCount = 0;
        while ((readCount = fileReader.read(charBuffer)) != -1) {
            System.out.println(new String(charBuffer, 0, readCount));
        }
    } catch (FileNotFoundException e) {
        throw new RuntimeException(e);
    } catch (IOException e) {
        throw new RuntimeException(e);
    }
}
9.2 字符输出流(FileWriter)
用字符输出流进行操作后,必须调用 close 方法(或者 flush 方法)之后才能写入到文件里面,否则就是空白文件。
public static void main(String[] args) {
    //根据文件路径创建字符输出流对象
    try (
        FileWriter fileReader = new FileWriter("test01/src/main/java/org/example/images/filewrite.txt");
        FileWriter fileOneReader = new FileWriter("test01/src/main/java/org/example/images/filewrite.txt", true);//允许拼接
    )//写在括号里就不用再finally里面写关闭流了,也不用写关闭管道了
    {
        fileReader.write(97);//写一个 int,拿到的是低 16 位对应的字符
        fileReader.write('a');//按照字符写入
        fileReader.write('测');//按照字符写入
        fileReader.write("测试");
        fileReader.write("测试一个字符串", 0, 4);//从第 0 个字符开始,写 4 个字符
        char[] chars = {'a','b','c','d','e','f','g','h','i','j','k','l','m','n','o','p','q','r','s','t','u','v','w','x','y','z'};
        fileReader.write(chars);//按照字符数组写入
        fileReader.write(chars, 0, 5);//按照字符数组截取写入
    } catch (FileNotFoundException e) {
        throw new RuntimeException(e);
    } catch (IOException e) {
        throw new RuntimeException(e);
    }
}
字符流的 write(int) 写的是字符不是字节
write(97)写进去的是字符a,不是字节流里那个 97
它取的是 int 的低 16 位,所以别拿它写文件编码
write(String, int, int) 的长度是字符数
write("测试一个字符串", 0, 4)写的是前 4 个字符,也就是「测试一个」
字节流那边算的是字节,两边单位不一样,别串
同一个文件开两个 Writer 是坑
一个覆盖一个追加,打开的瞬间覆盖的那个就把文件清空了
两个流写同一个文件,写到什么位置全看缓冲和关闭顺序,结果不可预期
要追加就只开一个带true的,要覆盖就只开一个不带参数的
字符集能显式指定就别省
new FileWriter(path, StandardCharsets.UTF_8),JDK 10 起支持
不写字符集,JDK 18 前后默认值不一样,跨机器就是乱码
忘了 flush 就是空白文件
字符流有缓冲,数据可能在内存里没落盘
close()会顺带 flush,用 try-with-resources 就没这个问题
10. 缓冲流
对原始流进行包装,能提升性能。
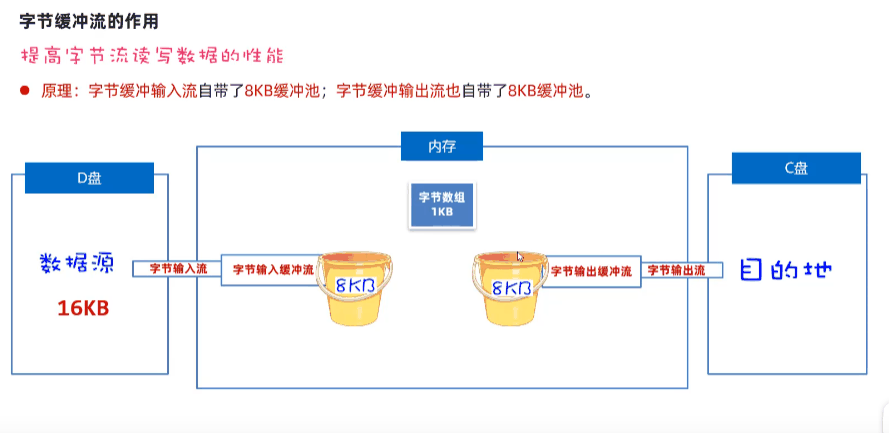
缓冲流性能高的原理:本身包含了 8kb 的缓冲池,假设源文件 16kb,字节数组为 1kb,原来读写需要 16 次读加 16 次写,一共 32 次;带上缓冲池后就只需要 2+2=4 次。
10.1 字节缓冲流
public static void main(String[] args) {
    //根据文件路径创建字节输入流对象
    try (
        FileInputStream fileInputStream = new FileInputStream("test01/src/main/java/org/example/images/002.png");
        BufferedInputStream bufferedInputStream = new BufferedInputStream(fileInputStream, 8192 * 2);//可以通过参数来调整缓冲池的大小
        FileOutputStream fileOutputStream = new FileOutputStream("test01/src/main/java/org/example/images/Bufffer002.png");
        BufferedOutputStream bufferedOutputStream = new BufferedOutputStream(fileOutputStream, 8192 * 2);
    )//写在括号里就不用再finally里面写关闭流了,也不用写关闭管道了
    {
        byte[] bytes = new byte[1024];
        int readCount = 0;
        while ((readCount = bufferedInputStream.read(bytes)) != -1) {
            System.out.println(readCount);
            bufferedOutputStream.write(bytes, 0, readCount);
        }
    } catch (FileNotFoundException e) {
        throw new RuntimeException(e);
    } catch (IOException e) {
        throw new RuntimeException(e);
    }
}
10.2 字符缓冲输入流
public static void main(String[] args) {
    //根据文件路径创建字符输入流对象
    try (
        FileReader fileInputStream = new FileReader("test01/src/main/java/org/example/images/file.txt");
        BufferedReader bufferedReader = new BufferedReader(fileInputStream);
    )//写在括号里就不用再finally里面写关闭流了,也不用写关闭管道了
    {
        //可以通过里面自带的readLine()方法来读取一行,但是不能读取文章最后一行的后面一行,文章最后一行的后面一行会返回null
        String str = "";
        while (null != (str = bufferedReader.readLine())) {
            System.out.println(str);
        }
    } catch (FileNotFoundException e) {
        throw new RuntimeException(e);
    } catch (IOException e) {
        throw new RuntimeException(e);
    }
}
10.3 字符缓冲输出流
public static void main(String[] args) {
    //根据文件路径创建字符输出流对象
    try (
        FileWriter fileInputStream = new FileWriter("test01/src/main/java/org/example/images/fileWrite.txt");
        BufferedWriter bufferedReader = new BufferedWriter(fileInputStream);
    )//写在括号里就不用再finally里面写关闭流了,也不用写关闭管道了
    {
        bufferedReader.write("测试一行数据");
        bufferedReader.newLine();//此方法可以自动换行
        bufferedReader.write("测试一行数据");
    } catch (FileNotFoundException e) {
        throw new RuntimeException(e);
    } catch (IOException e) {
        throw new RuntimeException(e);
    }
}
缓冲流是装饰器
它自己不读文件,接一个普通流进去,替它做批量搬运
所以它和被包装的流都要关,只关外层等于没关
默认缓冲池是 8192 字节
new BufferedInputStream(in)就是 8 KB,可以自己传第二个参数改
readLine 是缓冲流带来的
FileReader没有readLine(),得自己按换行符切
readLine 读不到最后一行后面的那一行
读到文件尾它返回null,所以判断条件是null不是空串
newLine 比手写 \r\n 稳
它按运行平台写换行符,跨平台不用自己判断
缓冲流也要 flush
close 会顺带 flush,用 try-with-resources 就别手动管了
11. 转换流
当程序的编码和读取文件的编码不一致时,就会出现乱码,例如程序是 utf-8 的字符集,但是 txt 文件是 GBK 字符集,这时候就需要用到转换流进行编码转换。
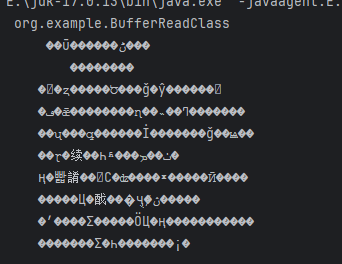
11.1 转换输入流
public static void main(String[] args) {
    //根据文件路径创建字节输入流对象
    try (
        FileInputStream fileInputStream = new FileInputStream("test01/src/main/java/org/example/images/hanzi.txt");
        InputStreamReader gbk = new InputStreamReader(fileInputStream, "GBK");//先转化成字节流,然后再弄成字符转换流
        BufferedReader bufferedReader = new BufferedReader(gbk);//接着再转换成缓冲流进行操作
    )//写在括号里就不用再finally里面写关闭流了,也不用写关闭管道了
    {
        //可以通过里面自带的readLine()方法来读取一行
        String str = "";
        while (null != (str = bufferedReader.readLine())) {
            System.out.println(str);
        }
    } catch (FileNotFoundException e) {
        throw new RuntimeException(e);
    } catch (IOException e) {
        throw new RuntimeException(e);
    }
}
11.2 转换输出流
public static void main(String[] args) {
    //根据文件路径创建字节输出流对象
    try (
        FileOutputStream fileInputStream = new FileOutputStream("test01/src/main/java/org/example/images/outputhanzi.txt");
        OutputStreamWriter gbk = new OutputStreamWriter(fileInputStream, "GBK");//先转化成字节流,然后再弄成字符转换流
        BufferedWriter bufferedReader = new BufferedWriter(gbk);//接着再转换成缓冲流进行操作
    )//写在括号里就不用再finally里面写关闭流了,也不用写关闭管道了
    {
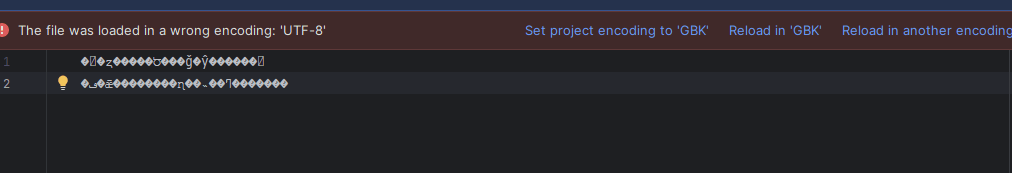
        //这样写出来生成的txt文件就是GBK格式,直接用UTF-8看会乱码
        bufferedReader.write("  大江东去,浪淘尽,千古风流人物。");
        bufferedReader.newLine();
        bufferedReader.write("  故垒西边,人道是,三国周郎赤壁。");
    } catch (FileNotFoundException e) {
        throw new RuntimeException(e);
    } catch (IOException e) {
        throw new RuntimeException(e);
    }
}
写完的文件用 UTF-8 打开,IDEA 会直接提示编码不对:
转换流是字节流和字符流之间的桥
InputStreamReader把字节解成字符,OutputStreamWriter把字符编成字节
字符集就写在这两个类上,其他流都不用管
包装顺序不能反
正确顺序是 字节流 → 转换流 → 缓冲流
缓冲流包在转换流外面,才能一次读一行;反过来readLine就没有了
写出来的 GBK 文件不是错,是约定
文件头不带编码信息,打开的时候得知道它是 GBK
跨系统传文件,统一 UTF-8 才是省事的选择
用 Charset 构造器更省心
new InputStreamReader(in, StandardCharsets.UTF_8),编译期定死字符集
JDK 10 之后 FileReader 也能指定字符集了
new FileReader(file, StandardCharsets.UTF_8),不一定非要转换流
转换流是装饰器,别忘关
只关FileInputStream不关转换流,缓冲里的数据一样丢
12. 打印流
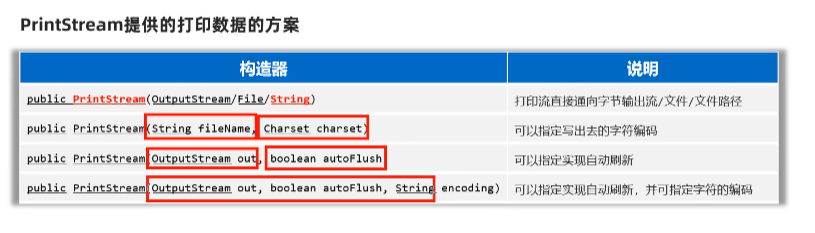
可以实现更加方便高效的写数据,使用方便、性能高的流。
12.1 PrintStream
public class PrintStreamClass {
    public static void main(String[] args) {
        //根据文件路径创建打印流对象
        try (
            PrintStream printStream = new PrintStream("test01/src/main/java/org/example/images/printOutStream.txt", Charset.forName("UTF-8"));//可以指定文件地址并且输出字符集编码
            FileOutputStream outputStream = new FileOutputStream("test01/src/main/java/org/example/images/printOutStream.txt");
            PrintWriter printWriter = new PrintWriter(outputStream, true, Charset.forName("UTF-8"));//可以指定文件刷新以及字符编码,字符刷新后可以在打印完就生成文件,不需要关闭流
        )//写在括号里就不用再finally里面写抛出异常了,也不用写关闭管道了
        {
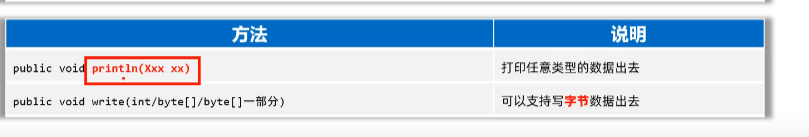
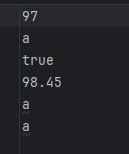
            //可以使用println方法打印各种类型的数据,并且还可以自动换行,底层时全都给转换成String类型了
            printStream.println(97);
            printStream.println("a");
            printStream.println(true);
            printStream.println(98.45);
            //写单个字节
            printStream.write(97);
            //写字符串用 print
            printStream.print("a");
        } catch (FileNotFoundException e) {
            throw new RuntimeException(e);
        } catch (IOException e) {
            throw new RuntimeException(e);
        }
    }
}
12.2 PrintWriter
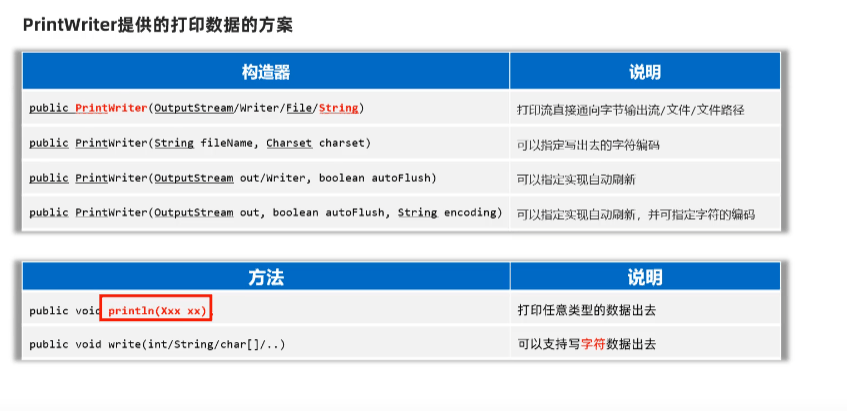
public class PrintWriterClass {
    public static void main(String[] args) {
        //根据文件路径创建打印流对象
        try (
            PrintWriter printWriter = new PrintWriter(new FileOutputStream("test01/src/main/java/org/example/images/printOutStream.txt"), true, Charset.forName("UTF-8"));//可以指定文件刷新以及字符编码
        )//写在括号里就不用再finally里面写抛出异常了,也不用写关闭管道了
        {
            //可以使用println方法打印各种类型的数据,并且还可以自动换行,底层时全都给转换成String类型了
            printWriter.println(97);
            printWriter.println("a");
            printWriter.println(true);
            printWriter.println(98.45);
            //写一个 int,拿到的是低 16 位对应的字符
            printWriter.write(97);
        } catch (FileNotFoundException e) {
            throw new RuntimeException(e);
        } catch (IOException e) {
            throw new RuntimeException(e);
        }
    }
}
12.3 日志输出
System.out.println() 其实就是打印流,System.out 相当于是获取控制台的输出流。可以通过指定日志输出流的地址,把日志输出到指定文件中。
public static void main(String[] args) {
    System.out.println("床前明月光");
    System.out.println("疑是地上霜");
    try (PrintStream printStream = new PrintStream("test01/src/main/java/org/example/images/printbaocun.txt", Charset.forName("UTF-8"));){
        //通过new一个输出流,把系统的日志输出到指定文件中,前两句诗输出在控制台里面,后两句输出在文件printbaocun中
        System.setOut(printStream);
        System.out.println("举头望明月");
        System.out.println("低头思故乡");
    } catch (IOException e) {
        throw new RuntimeException(e);
    }
}
PrintStream.write(String) 是 private,编译不过
公开的 write 只有write(int)、write(byte[])、write(byte[], int, int)
写字符串用print()或println()
PrintStream 吞异常
它内部把 IOException 记在一个trouble标志上,不往外抛
要感知写失败,得调checkError(),或者用 PrintWriter
PrintWriter 有 checkError 和 flush
它不吞异常,是真正做字符输出的那个,写文本优先用它
自动刷新是按行来的
构造器第二个参数传true,碰到换行或者调用 flush 才落盘
不自动刷新的话,程序异常退出,缓冲区里的日志就丢了
System.setOut 换的是全局标准输出
换完整个 JVM 的System.out都变了,测试里换了记得换回来
生产环境别用 System.out 记日志
用 logback 或 log4j2,能分级、能落盘能轮转
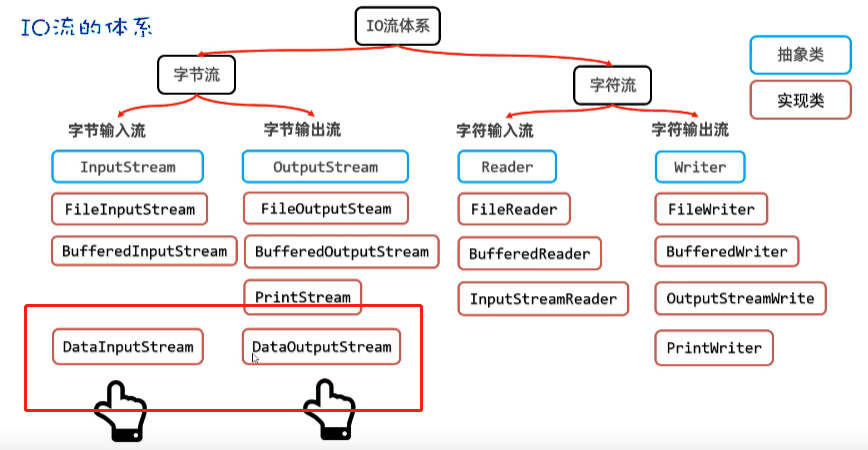
13. 数据流
可以把打印的数据以及他的类型一并保存起来,在文件中看起来是乱码,但是读出来就正常了。
public static void main(String[] args) {
    try (
        FileOutputStream fileOutputStream = new FileOutputStream("test01/src/main/java/org/example/images/dataoutstream.txt");
        DataOutputStream dos = new DataOutputStream(fileOutputStream);
        FileInputStream fileInputStream = new FileInputStream("test01/src/main/java/org/example/images/dataoutstream.txt");
        DataInputStream dis = new DataInputStream(fileInputStream);
    ){
        //连带着内容和类型一块存进去,存进去后文件是乱码的,但是可以根据类型再读出来
        dos.writeInt(97);
        dos.writeDouble(97.5566);
        dos.writeUTF("测试字符串");
        dos.writeBoolean(false);
        //根据顺序读内容,一定要对应起来,否则就会出问题
        System.out.println(dis.readInt());
        System.out.println(dis.readDouble());
        System.out.println(dis.readUTF());
        System.out.println(dis.readBoolean());
    } catch (Exception e) {
        e.printStackTrace();
    }
}
数据流是带类型的字节流
writeInt写 4 字节,writeDouble写 8 字节,writeBoolean写 1 字节
读的时候用对应的 read 方法,类型自动还原
写和读的顺序必须一一对应
写的时候先 writeInt 再 writeUTF,读就得先 readInt 再 readUTF
顺序错一个,readUTF 会把长度字段当成内容读出来,后面全串位
writeUTF 有 2 字节长度前缀
它用的是 modified UTF-8,每个 BMP 字符 1 到 3 字节
实测「测试字符串」5 个字写 17 字节,整份文件 30 字节
DataOutputStream 是装饰器
它包在FileOutputStream外面,两个都得关
别拿它写给人看的文件
存进去的是二进制,记事本打开是乱码,要存文本就用字符流
14. 序列化
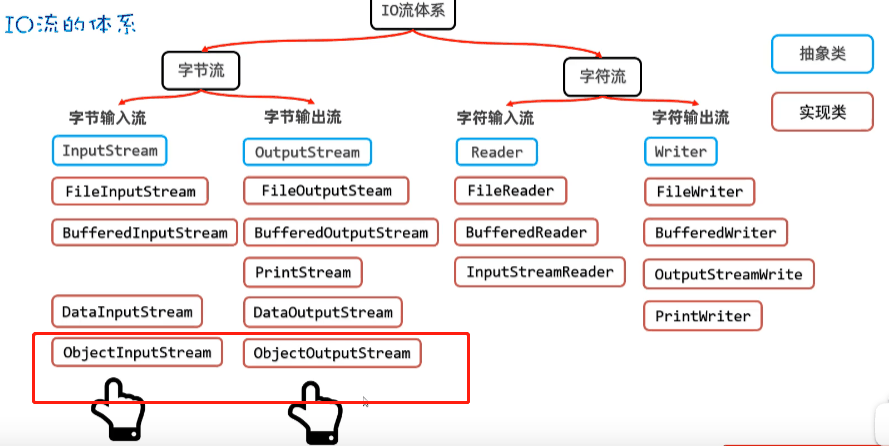
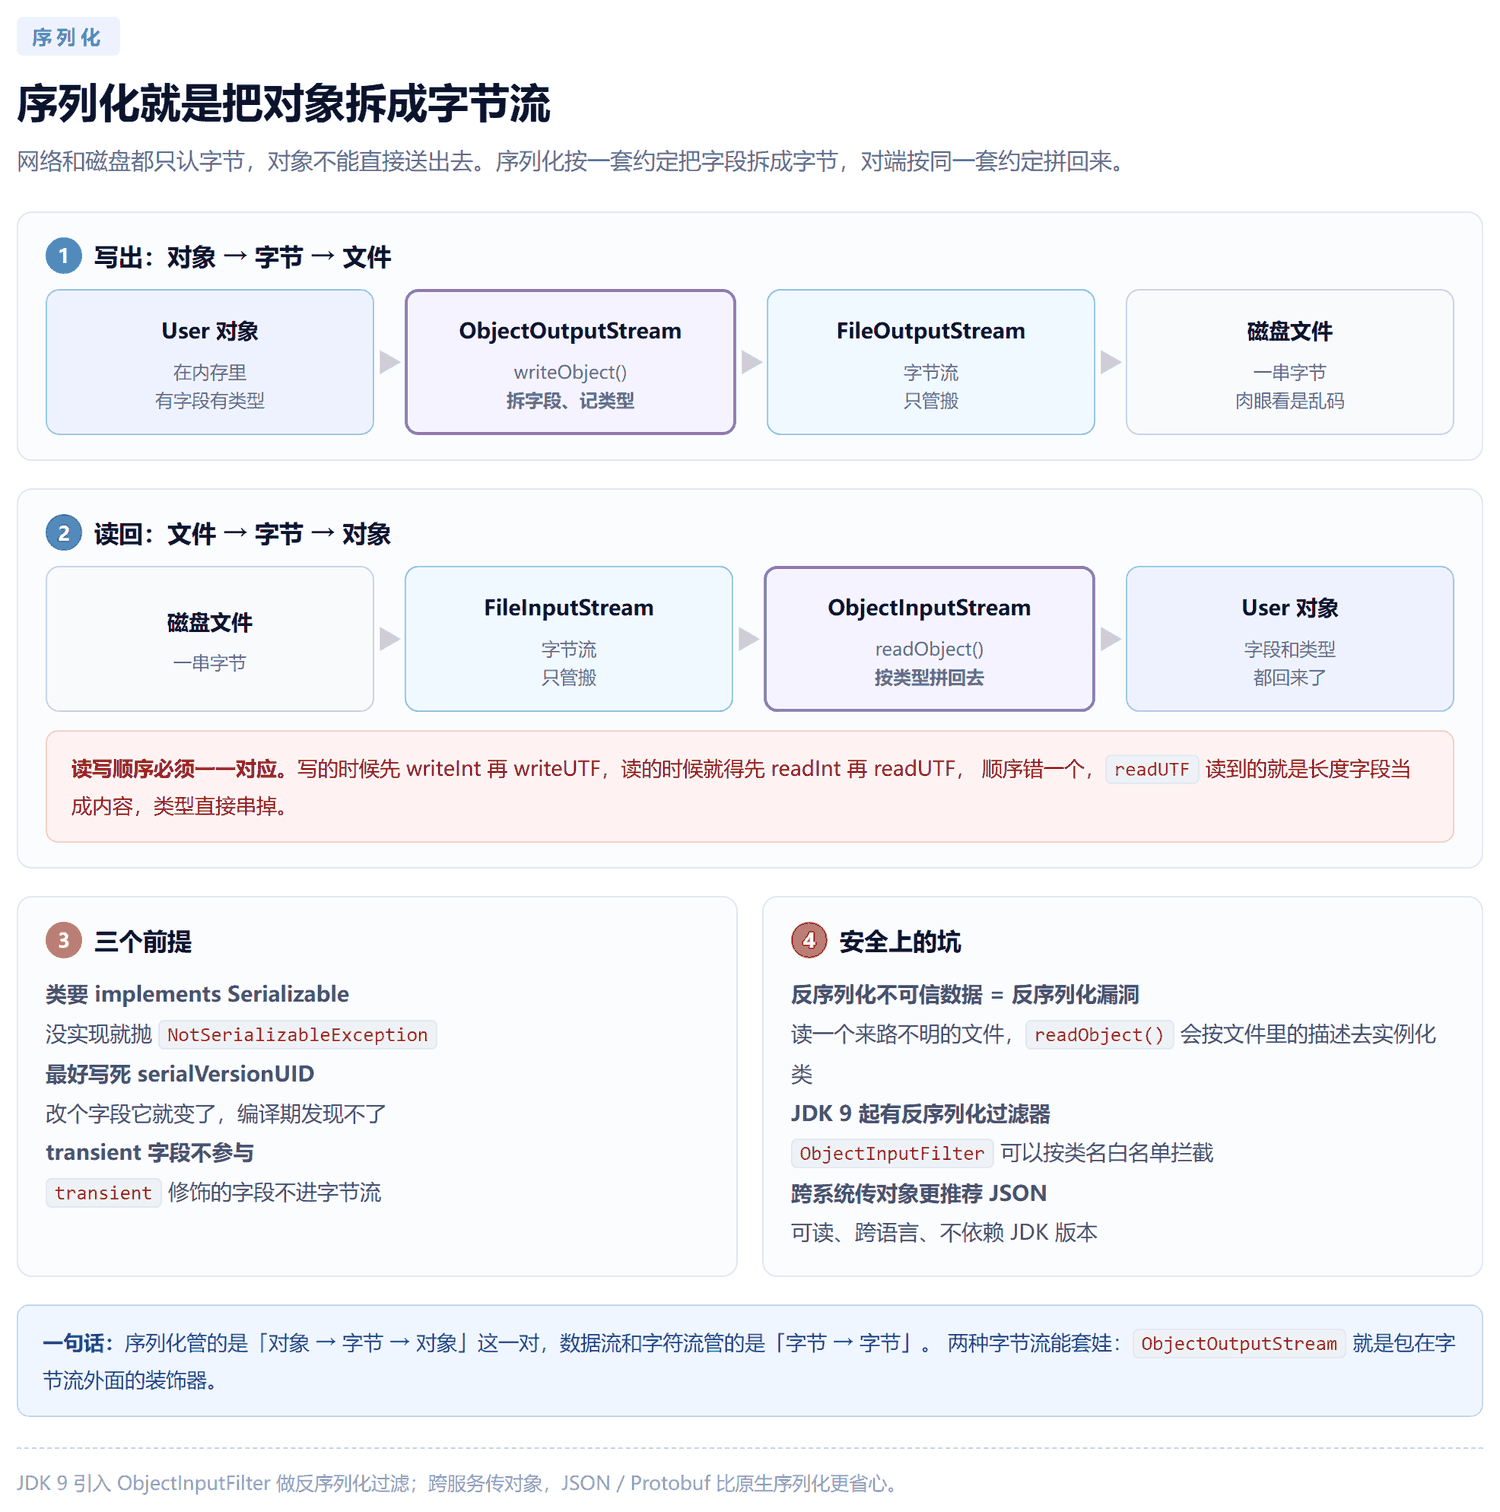
要把对象类进行网络传输时需要进行序列化,拿到对象后再进行反序列化。因为网络传输都是二进制,对象是不能直接传输的。
序列化可以使用原生的方法,如下用流进行操作(必须要在类上面实现 Serializable),也可以用 JSON 等方式。
14.1 序列化
把 java 对象写到文件中去:
public static void main(String[] args) {
    User user = new User();
    user.setName("张三");
    user.setAge(18);
    user.setAddress("北京市");
    user.setPhone("123456789");
    try (
        ObjectOutputStream objectOutputStream = new ObjectOutputStream(new FileOutputStream("test01/src/main/java/org/example/images/ObjectStreamClas.txt"));
    ){
        //此处使用User类必须经过序列化,否则就无法变成对象存储
        objectOutputStream.writeObject(user);
    } catch (Exception e) {
        throw new RuntimeException(e);
    }
}
14.2 反序列化
把文件读回 java 对象中来:
public static void main(String[] args) {
    try (
        ObjectInputStream objectInputStream = new ObjectInputStream(new FileInputStream("test01/src/main/java/org/example/images/ObjectStreamClas.txt"));
    ){
        //此处使用User类必须经过序列化,否则就无法变成对象存储
        User user = (User) objectInputStream.readObject();
        System.out.println(user);
    } catch (Exception e) {
        throw new RuntimeException(e);
    }
}被序列化的类长这样,Serializable 是个空接口,声明了就能被序列化:
import java.io.Serializable;

public class User implements Serializable {
    private static final long serialVersionUID = 1L;

    private String name;
    private int age;
    private String address;
    private String phone;

    public String getName() { return name; }
    public void setName(String name) { this.name = name; }
    public int getAge() { return age; }
    public void setAge(int age) { this.age = age; }
    public String getAddress() { return address; }
    public void setAddress(String address) { this.address = address; }
    public String getPhone() { return phone; }
    public void setPhone(String phone) { this.phone = phone; }

    @Override
    public String toString() {
        return "User{name='" + name + "', age=" + age + ", address='" + address + "', phone='" + phone + "'}";
    }
}
类必须 implements Serializable
没实现就抛NotSerializableException,编译期不报错,运行时才炸
serialVersionUID 写死一个
它是指纹,类一改它就可能对不上,反序列化直接抛InvalidClassException
transient 修饰的字段不进字节流
读回来是默认值,密码、临时 token 这类别指望它带过去
static 字段本来就不参与
它属于类不属于对象,序列化管不着
反序列化不可信数据等于开了个洞
读一个来路不明的文件,readObject()会按文件里的描述去实例化类
JDK 9 起有ObjectInputFilter做类名白名单
跨服务传对象优先 JSON 或 Protobuf
可读、跨语言、不挑 JDK 版本,原生序列化只适合自己存自己读
15. IO 框架
15.1 Commons-IO
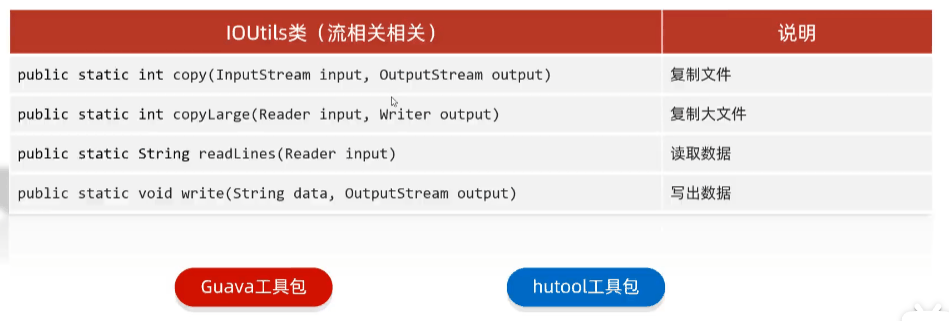
Apache Commons IO 是给 IO 写的一堆工具类,最新是 2.22.0,最低要 Java 8。
<dependency>
    <groupId>commons-io</groupId>
    <artifactId>commons-io</artifactId>
    <version>2.22.0</version>
</dependency>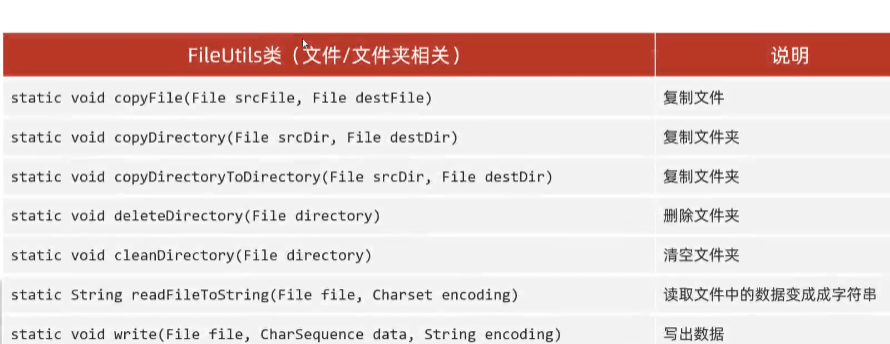
import org.apache.commons.io.FileUtils;
import org.apache.commons.io.IOUtils;
import java.io.File;
import java.io.FileInputStream;
import java.io.FileOutputStream;
import java.io.InputStream;
import java.io.OutputStream;
import java.nio.charset.StandardCharsets;

public class CommonsIoDemo {
    public static void main(String[] args) throws Exception {
        File src = new File("test01/src/main/resources/images/002.png");
        File dest = new File("test01/src/main/resources/images/copy002.png");

        //一行拷贝整个文件,不用自己写循环
        FileUtils.copyFile(src, dest);

        //读文本,字符集显式指定
        String text = FileUtils.readFileToString(new File("notes.txt"), StandardCharsets.UTF_8);
        System.out.println(text);

        //流之间倒数据
        try (InputStream in = new FileInputStream(src);
             OutputStream out = new FileOutputStream(dest)) {
            IOUtils.copy(in, out);
        }
    }
}
15.2 Hutool
Hutool 是国产的 Java 工具库,5.8 系列是当前稳定线,最新 5.8.48。
<dependency>
    <groupId>cn.hutool</groupId>
    <artifactId>hutool-all</artifactId>
    <version>5.8.48</version>
</dependency>
import cn.hutool.core.io.FileUtil;
import cn.hutool.core.io.IoUtil;
import java.io.File;
import java.io.FileInputStream;
import java.nio.charset.StandardCharsets;
public class HutoolIoDemo {
public static void main(String[] args) throws Exception {
//读字符串,默认 UTF-8
String content = FileUtil.readUtf8String("notes.txt");
System.out.println(content);
//一行拷贝,第三个参数是「目标已存在时是否覆盖」
FileUtil.copy("src.txt", "dest.txt", true);
//目录操作
File[] files = FileUtil.ls("D:\\data");
FileUtil.mkdir("D:\\data\\sub");
//流之间倒数据
byte[] bytes = IoUtil.readBytes(new FileInputStream("notes.txt"));
}
}Commons-IO 和 Hutool 干的是同一件事
一个 Apache 官方,一个国产全家桶,方法名不一样,思路一样
FileUtils 最大的价值是删文件夹和拷文件夹
FileUtils.deleteDirectory(dir)递归删,自己写要十几行
工具类解决的是「重复代码」,不是「理解流」
面试问的是原理,工具库解决的是效率,两回事
别让框架遮住 API
用FileUtils之前,至少手写过一次原始流,出问题才知道往哪查
新项目优先看 NIO
Files.copy、Files.readAllLines、Files.walk一行顶一段,而且没有 checked exception
框架是兜底不是起点
先搞懂管道、缓冲、编码这三件事,框架只是把它们包了个壳
💡 补充几个容易忽略的:
JDK 18 起默认字符集才是 UTF-8
JDK 17 及更早是平台默认,中文 Windows 上是 GBK,JEP 400 改的
所以「不写字符集」这件事,跨版本结果不一样
相对路径的基准是工作目录
不是项目根,也不是类所在目录,IDEA 里是模块目录,命令行里是启动命令的目录
打包成 jar 之后工作目录更容易变,配置和资源别靠相对路径找
File 是老 API,新代码优先 Path
Path和Files组合起来一行能顶十行,而且不抛受检异常
大文件别整个读进内存
流式读 + 缓冲流 + try-with-resources 是三件套,JDK 9 之后还有transferTo可以偷懒
流是单向的,读写要开两个
同一个流不能既读又写,随机读写用RandomAccessFile
先想清楚字节还是字符
这一步定了,编码的事就定了,文本用字符流,二进制用字节流
官方文档和教程的定位不一样
官方文档按主题排,适合查细节;菜鸟教程的 Java 目录按学习顺序排,适合当路线图
两边对着看,学的顺序和查的效率都能兼顾
🔥 一句话总结:
File只管路径和元数据,内容得靠流;流按方向分输入输出、按最小单位分字节字符,字节流不管编码,字符流才管;同一个字 UTF-8 三个字节 GBK 两个字节,JDK 18 起默认才是 UTF-8,永远显式写字符集;read()单字节慢得离谱,read(byte[])要按实际长度截断,桶里的残留和结尾的 -1 是两个经典坑;写的时候默认覆盖不是追加,截取长度算的是字节;流用完必须关,Java 7 之后一律用 try-with-resources;缓冲流靠 8KB 缓冲池把 32 次读写压到 4 次;转换流的字符集就写在 InputStreamReader 和 OutputStreamWriter 上,包装顺序是字节流→转换流→缓冲流;PrintStream.write(String) 是 private 编译不过,它还吞异常,写文本优先 PrintWriter;数据流带着类型一起存,读写顺序必须一一对应;序列化要求类 implements Serializable,serialVersionUID 写死,transient 字段不参与,反序列化不可信数据就是漏洞,跨服务传对象用 JSON;Commons-IO 2.22 和 Hutool 5.8 是兜底不是起点,新代码优先 Path 和 Files。